Anthropic 和 Theorem 已证明,大语言模型 (LLMs) 现在能够以以前认为不可行的规模,为现实世界的软件生成形式化正确性证明。通过使用 Claude 在汇编代码层面为 100 多个开源库证明安全属性,该团队展示了 AI 如何弥合复杂软件与形式化验证所需的严谨数学模型之间的鸿沟。
这张图片说明了文章的核心前提:使用 LLMs 弥合复杂软件与严谨数学模型之间的鸿沟。
使用 LLM 扩展证明
历史上,形式化验证仅保留给航空电子等关键任务系统,因为它需要巨大的人力投入;例如,形式化验证 seL4 操作系统内核耗时 20 人年。Anthropic 的研究表明,LLMs 现在可以自动化大部分这一过程,为 RISC-V 汇编代码生成证明,以确保程序在无内存安全错误的情况下正常退出。
这种转变允许对以前因过于复杂而无法处理的生产级库进行验证。通过使用 AI 针对执行环境的一般模型生成证明,开发人员可以转向一种将经过验证的安全保证整合到开发生命周期中的工作流。
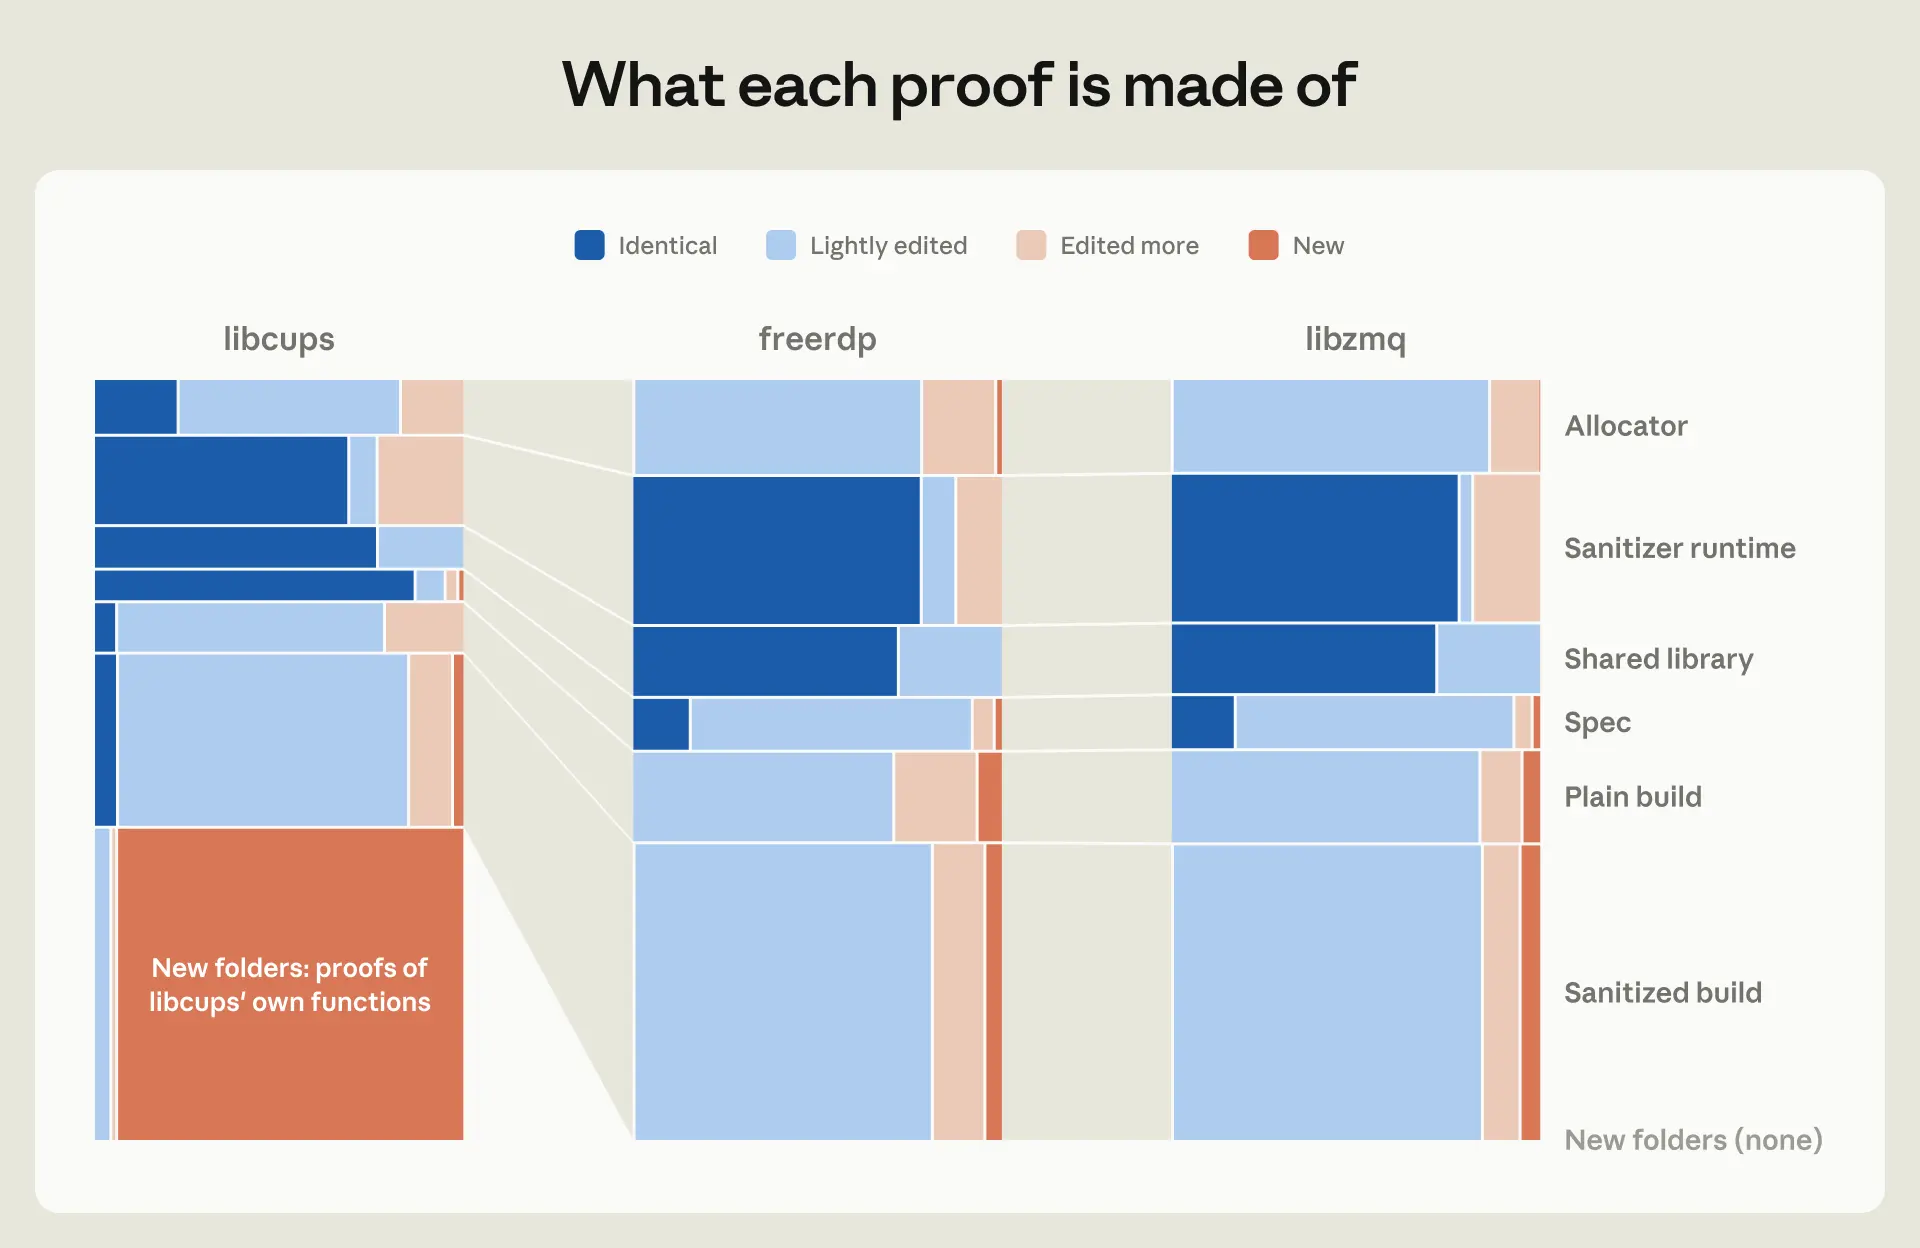
该图表提供了现在可以使用 AI 生成证明来验证的生产级库的具体示例。
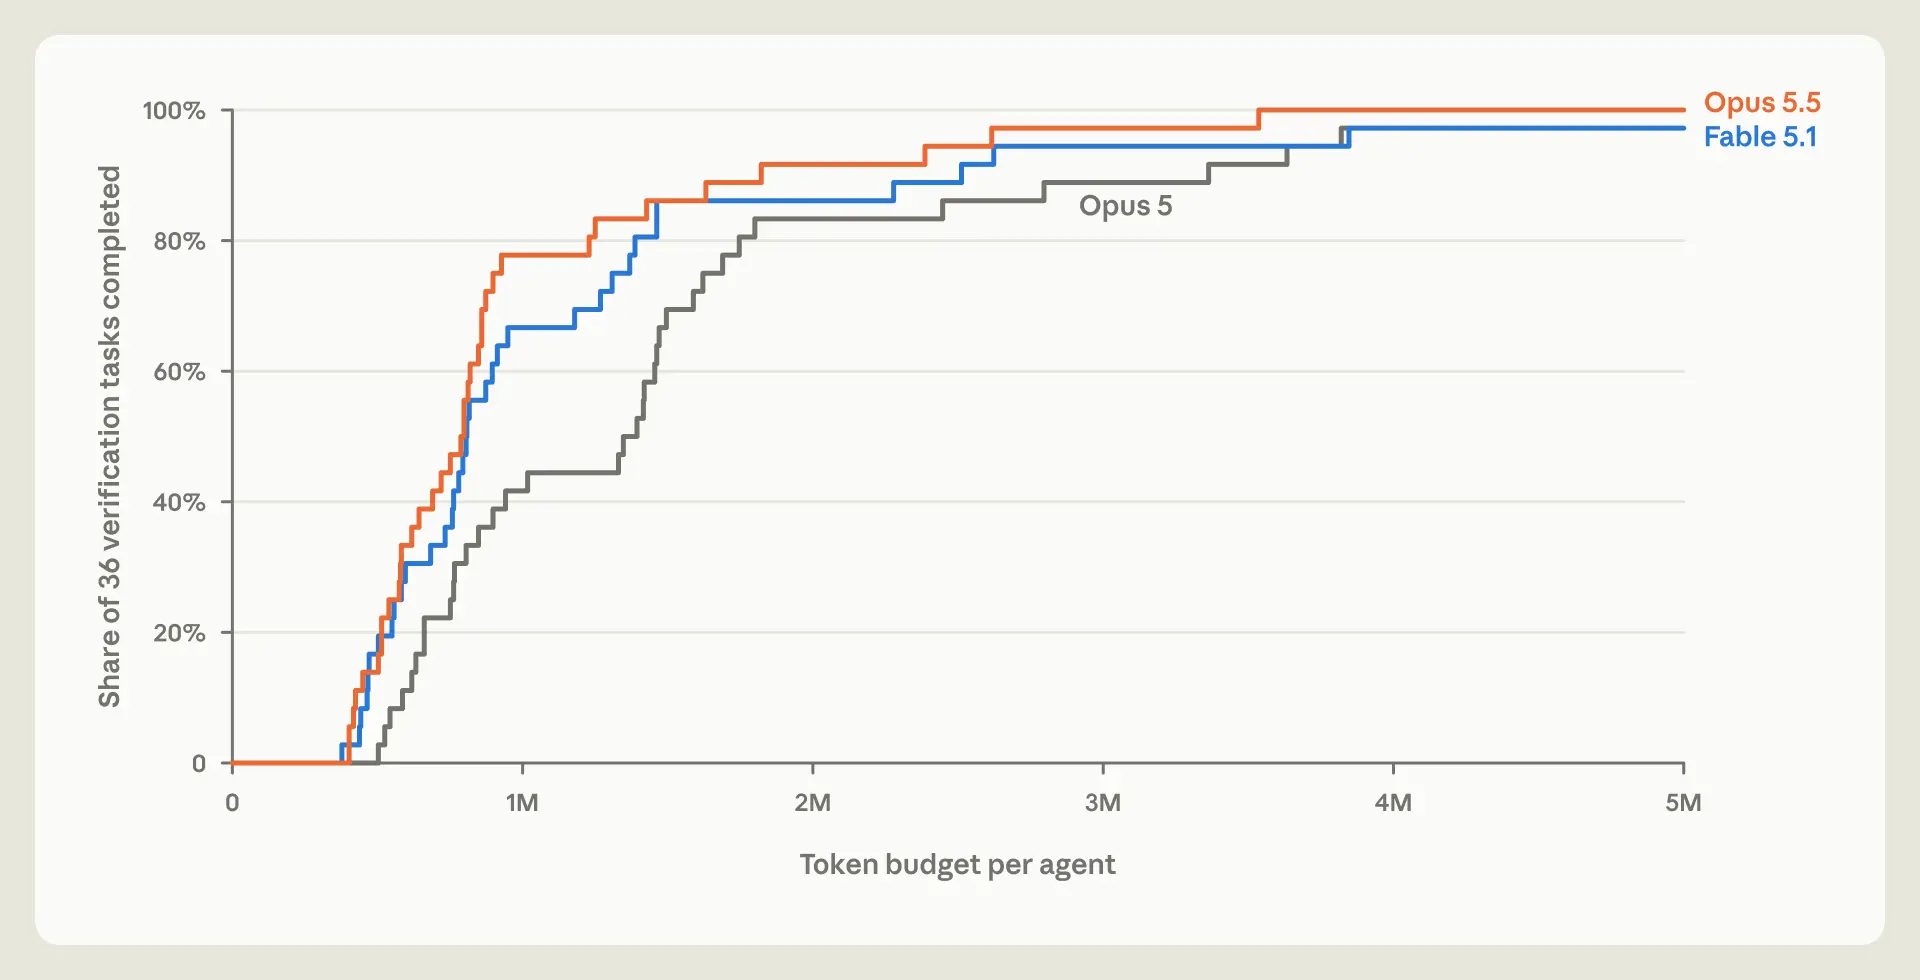
该图表量化了不同模型在完成验证任务中的效率,支持关于扩展证明的讨论。
“形式化验证提供全称量词声明,测试提供存在量词声明——任何难以验证的组件中的错误都可能导致证明的崩溃。”
— Formal Verification is Not Verifiable
受信任计算基础
形式化验证的一个核心局限是它依赖于“受信任计算基础”——即为了使证明成立而必须假设正确的组件。这包括底层的机器语义、操作系统的进程语义以及证明器本身。
如果这些难以验证的组件中包含任何错误,生成的证明可能无效。为了缓解这一问题,研究人员正在探索“二进制验证”,它避免对高级编程语言的语义建模,而是建模更简单的机器语义。
属性 vs. 绝对正确性
专家认为,“形式化验证”一词经常被宽泛地使用,应当替换为“形式化验证的属性”。由于软件本质上是复杂的,通常不可能为系统的每一个层级创建一个统一的正确性概念。
虽然引擎或数据库可能是数学上定义良好的,但面向用户的组件往往受审美和主观需求驱动。目标是转向一个可验证的组件堆栈,其中特定的一阶属性在二进制层面得到证明,即便承认多线程和分布式系统在未来几年仍是重大挑战。
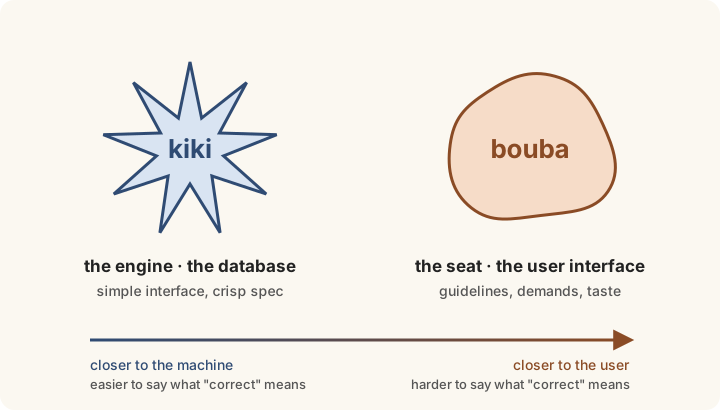
此图支持了由于用户面向组件的复杂性,应将“形式化验证”细化为“形式化验证的属性”的论点。