Edge0-145B 是世界上首个拥有 1450 亿参数的开源端侧 AI 模型,能够在报告峰值内存为 29GB 的兼容个人笔记本电脑上运行。通过将高参数推理和代码能力从云端转移到本地硬件,该模型在保持与前沿云端模型媲美性能的同时,消除了循环 API 费用和数据处理限制。
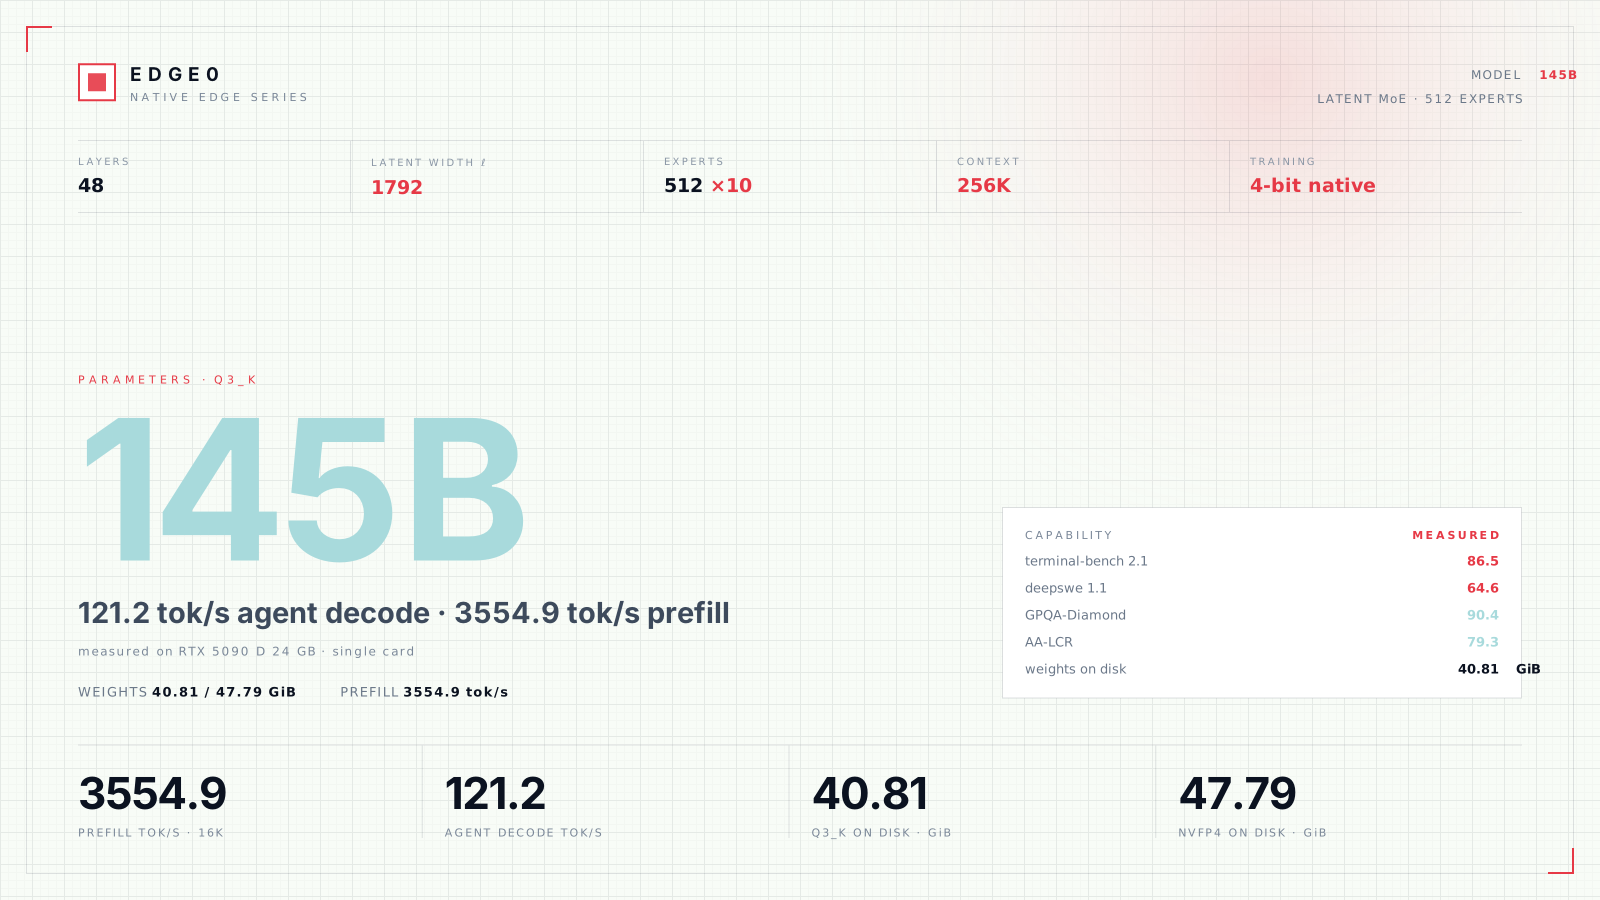
此图表展示了 1450 亿参数模型的技术架构和性能指标。
克服内存墙
从历史上看,端侧 AI 模型一直局限于较小的规模,例如用于移动端基础模型的 18 亿到 32.5 亿参数模型。这是由于“内存墙”造成的,即大型模型所需的内存和带宽超过了个人硬件所能提供的,迫使模型能力与本地执行之间做出权衡。
Edge0-145B 通过使用潜在 MoE 架构解决了这一问题。在这种设计中,64 个专家组共享两个大型矩阵,而每个专家保留一小组参数以捕捉其特定的差异。这种共享方式在保持高专家数量的同时,大幅减少了推理过程中必须移动的权重。
“Edge0-145B 是世界上首个拥有 1450 亿参数的开源端侧 AI 模型。”
— Edge0-145B: Open-Source On-Device AI with 145B Parameters
多层推理引擎
为了处理 1450 亿个参数,Edge0 框架采用了四层设计,流水处理 GPU 内存、系统内存和 SSD 访问。频繁使用的“热专家”保留在 GPU 内存中,而大约 40GB 的专家库位于系统内存中,48GB 的词汇数据驻留在 SSD 上,以便按需读取。
该系统还采用并行调度,同时使用 CPU 和 GPU。GPU 计算缓存的专家,而 CPU 处理剩余工作,并使用投机解码一次验证多个候选 token,将读取权重的成本分散到更多的输出 token 上。
性能与实际应用
在内部测试中,Edge0-145B 展示了超过每秒 1,100 个 token 的预填充速度和每秒 80+ 个 token 的解码速率。这些速度支持复杂的智能体工作流,例如在 Blender 中生成 3D 场景或制作视频脚本,模型可以在其中规划、编写、调试并视觉检查自己的工作。
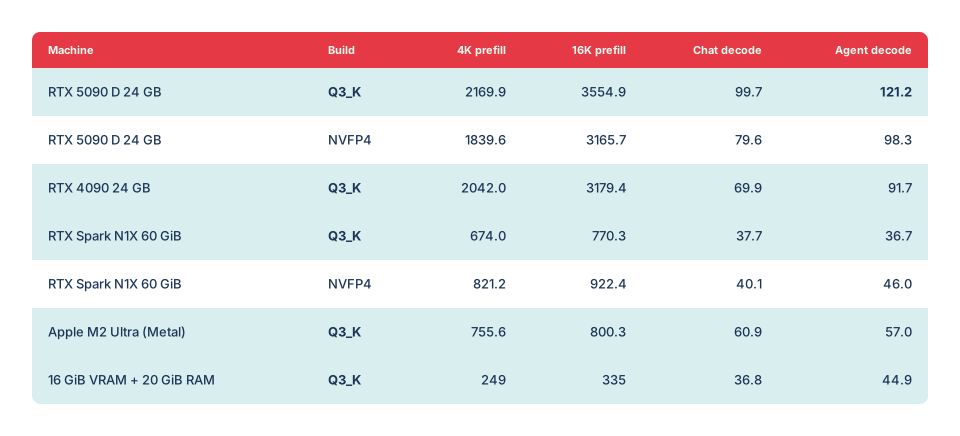
速度表为模型在不同场景下的性能提供了具体数据点。
虽然该模型消除了云端模型的 token 费用并保持数据本地化,但它仍需要特定的硬件。报告的成果是在峰值内存占用为 29GB 且典型功耗约为 120W 的配置上实现的,这意味着用户必须拥有能够承受这些需求且不会降频的硬件。
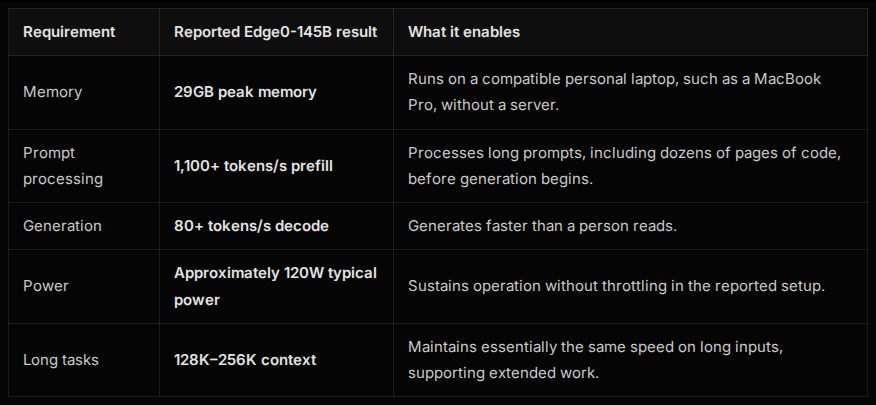
此表格提供了最后一段提到的具体硬件要求和性能指标。
HN Digest 根据 edge0.ai 报告的数据绘制;数值与来源一致。
Hacker News 读者的反应
- 亲身经验: 一位曾将类似模型用于代码智能体的评论者表示,基准测试分数与复杂知识工作的实际表现一致,并建议进行评估。 评论 ↗
- 质疑: 一位评论者对智能体生成的设计的实用性表示怀疑,指出手动清理混乱的输出有时可能会抵消使用 AI 所节省的时间。 评论 ↗
- 质疑: 另一位用户分享了谨慎的观点,指出考虑到其规模,他们对模型的性能持怀疑态度,但仍有兴趣看看第三方测试是否能证实发布的数值。 评论 ↗
以上为 Hacker News 讨论中观点的摘要,并非经过核实的事实。 阅读完整讨论 ↗