一台 13 年前的 iPad Air 和一台标准的小米电视盒子现在可以以每秒 2.6 到 5.1 个 token 的速度运行 16B 参数的混合专家(MoE)模型。这是通过 'smolmaxxing' 项目实现的,该项目针对低功耗设备的特定硬件瓶颈——即有限的 RAM、缓慢的闪存存储和基础的 CPU 指令——进行了优化,从而解锁了此前认为在这些硬件上无法实现的性能。
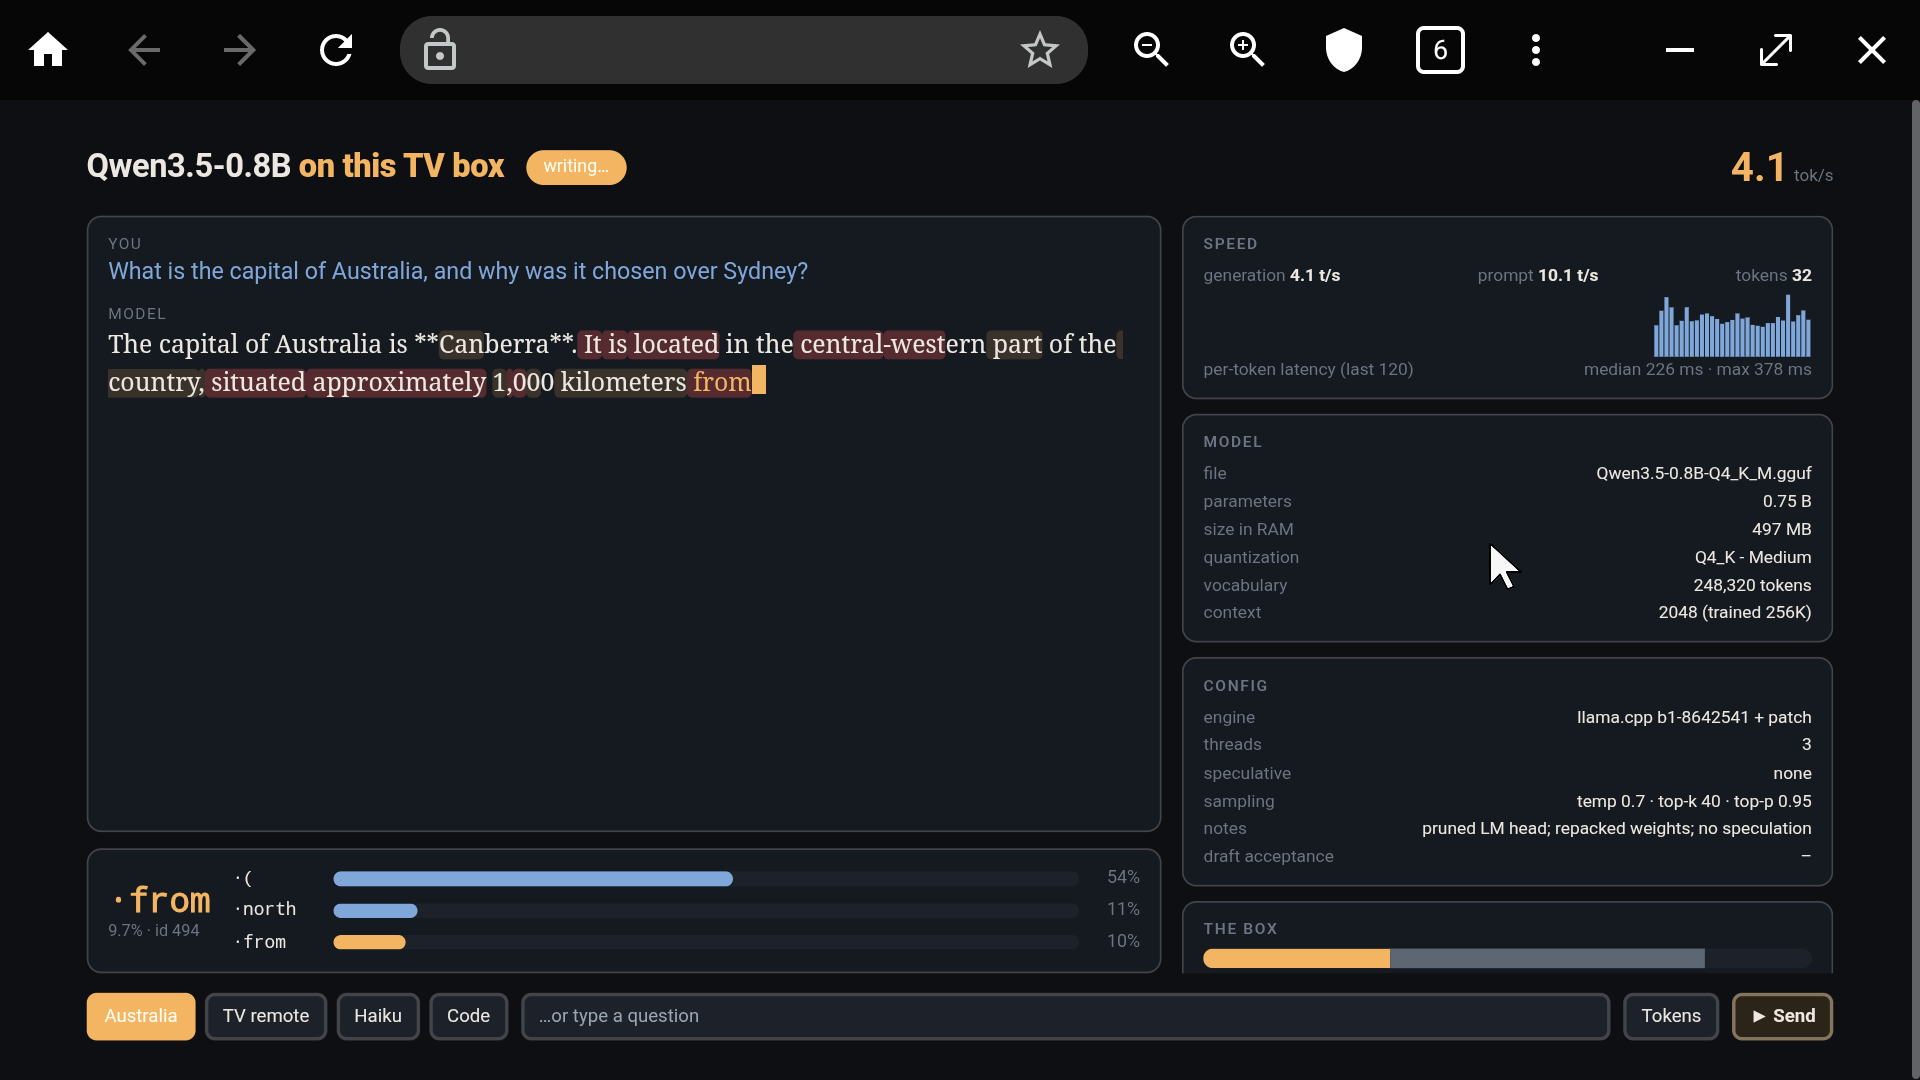
此截图展示了电视盒子硬件上模型输出的实际用户界面。
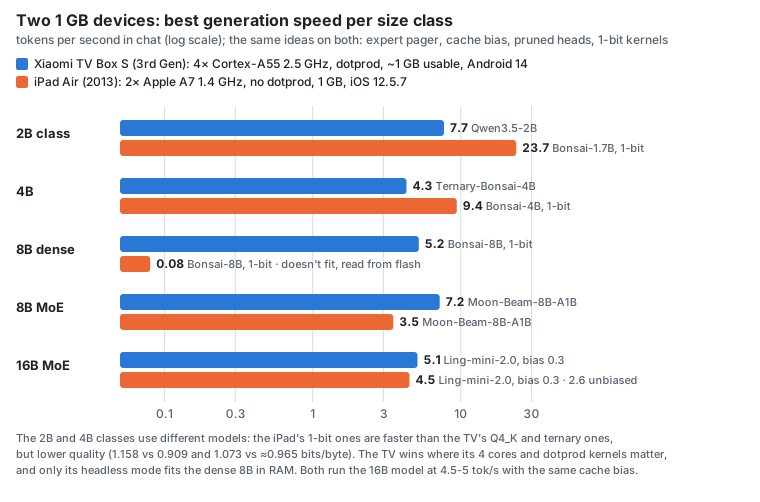
此图展示了不同模型大小的性能增益,特别突出了 16B MoE 模型在两个设备上的表现。
克服计算和内存限制
为了在像小米电视盒子 S 这样配备 Amlogic S7D 芯片且仅有 1.9 GB RAM 的设备上运行模型,该项目实施了几项专注于计算的创新。这些创新包括用于 vdotq_laneq 指令的 Q2_K 和三元重打包、1-bit 位平面,以及一个可在基础 NEON 指令上运行且无需 dotprod 支持的专用 1-bit 查找表内核。
内存限制通过“无头”模式和剪枝的 LM 头来解决,这些操作可以为每个模型释放 0.2 到 0.5 GB 的 RAM。这些优化允许系统保持更大的可用内存池,这对于将模型保留在 RAM 中而非不断交换到磁盘至关重要。
“你身边的每台设备都比看起来更强大。”
— GitHub - hyperionaidev/smolmaxxing: maxxing the ability to run different LLMs on the smallest devices possible
权重流式传输与专家分页
对于比设备物理 RAM 更大的模型,smolmaxxing 利用带有 O_DIRECT 的权重流式传输引擎和“专家分页器”。该机制根据需求从闪存中分页非专家权重,并预取后续层以最小化延迟。这对于混合专家(MoE)模型特别有效,因为这些模型在任何给定时间只需要激活一小部分总权重。
在 2013 年的 iPad Air 上,这种方法允许 16B MoE 模型以每秒 2.6-4.5 个 token 的速度运行。系统使用缓存感知路由和衰减频率剔除策略,以确保最常使用的专家保持可访问状态,从而减轻闪存 278 MB/s 速度限制的影响。
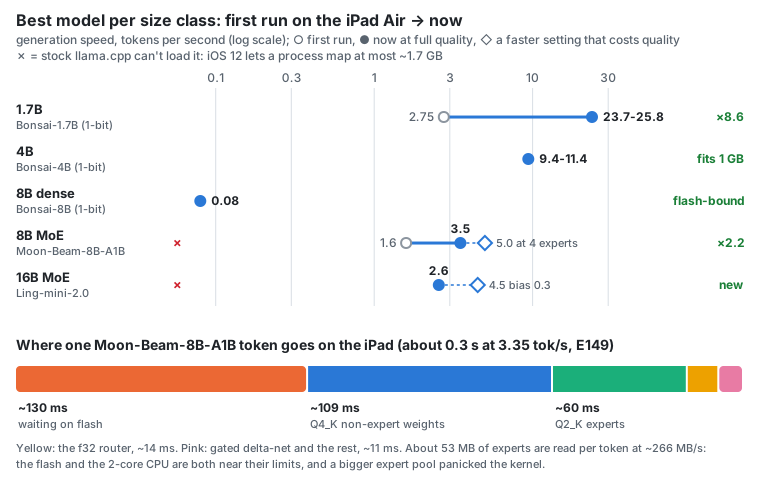
此计分板提供了 iPad Air 性能的具体数据点,包括 16B MoE 模型的速度。
性能权衡与瓶颈
该项目表明,对于超过 2B 参数的模型,主要瓶颈从 CPU 计算转向闪存速度。模型的生成速度严格受限于设备从闪存流式传输权重的能力;例如,在电视盒子上运行的 9B 模型仅达到每秒 0.27 个 token,因为它受到严重的闪存带宽限制。
在速度和输出质量之间存在可衡量的权衡。在 iPad Air 上,增加 Moon-Beam-8B-A1B 模型的专家数量可以将生成速度提升到每秒 5.0 个 token,但这会导致困惑度增加 27%,这意味着模型的回答变得不再连贯。
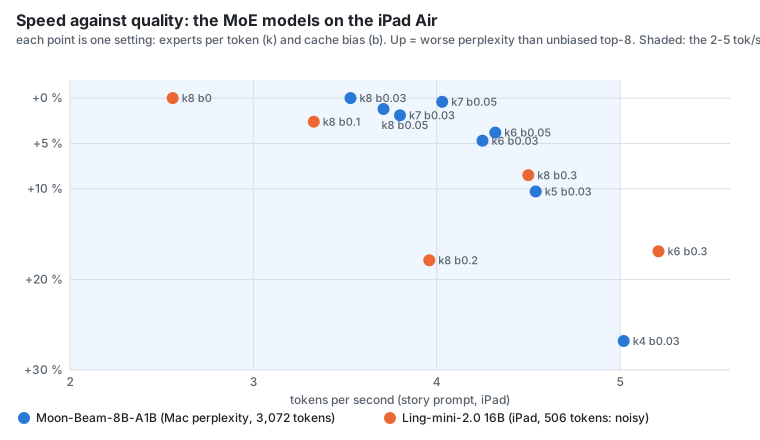
此图说明了最后一段提到的关于增加活跃专家所产生的特定权衡。
Hacker News 读者的反应
- 亲身经验: 一位评论者分享了他们成功在内存小于 1GB 的第一代 iPad Air 和小米电视盒子上运行 16B 模型的心得。 评论 ↗
- 亲身经验: 另一位用户指出,类似的努力已经成功在带有 GPU 加速的 Nintendo Wii 上运行模型。 评论 ↗
- 替代方案: 几位评论者建议在旧款旗舰移动设备、第一代 Raspberry Pi 或 ESP32 设备上测试该项目。 评论 ↗
以上为 Hacker News 讨论中观点的摘要,并非经过核实的事实。 阅读完整讨论 ↗