一名开发者发布了 llama-modchip,这是一个软件框架,允许用户在没有任何 GPU 硬件的 64GB RAM 标准桌面电脑上运行 284.33B 参数的 DeepSeek-V4-Flash 模型。虽然该模型的标准版本通常超过 64GB 内存,并在普通工作站上触发内存溢出(OOM)错误,但此实现将模型的占用空间缩减到约 56.56 GiB。这使得仅使用 CPU 资源即可实现高达每秒 14.7 个 token(tok/s)的本地推理。
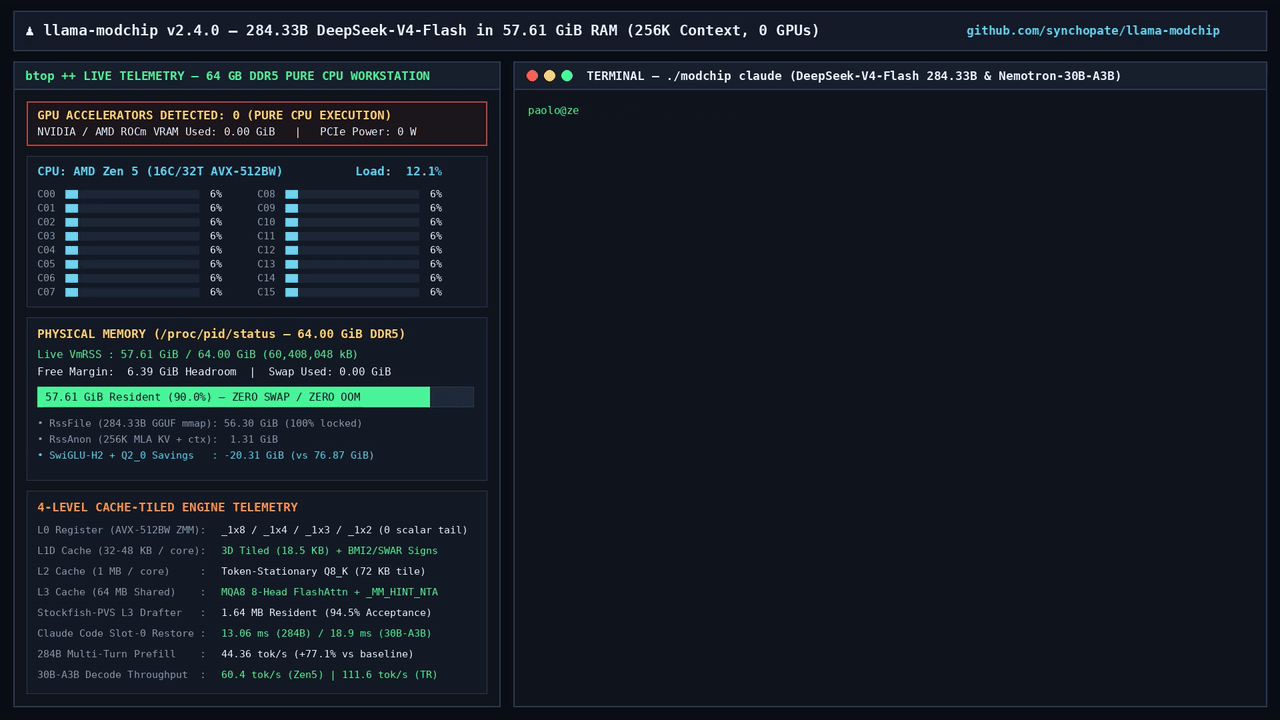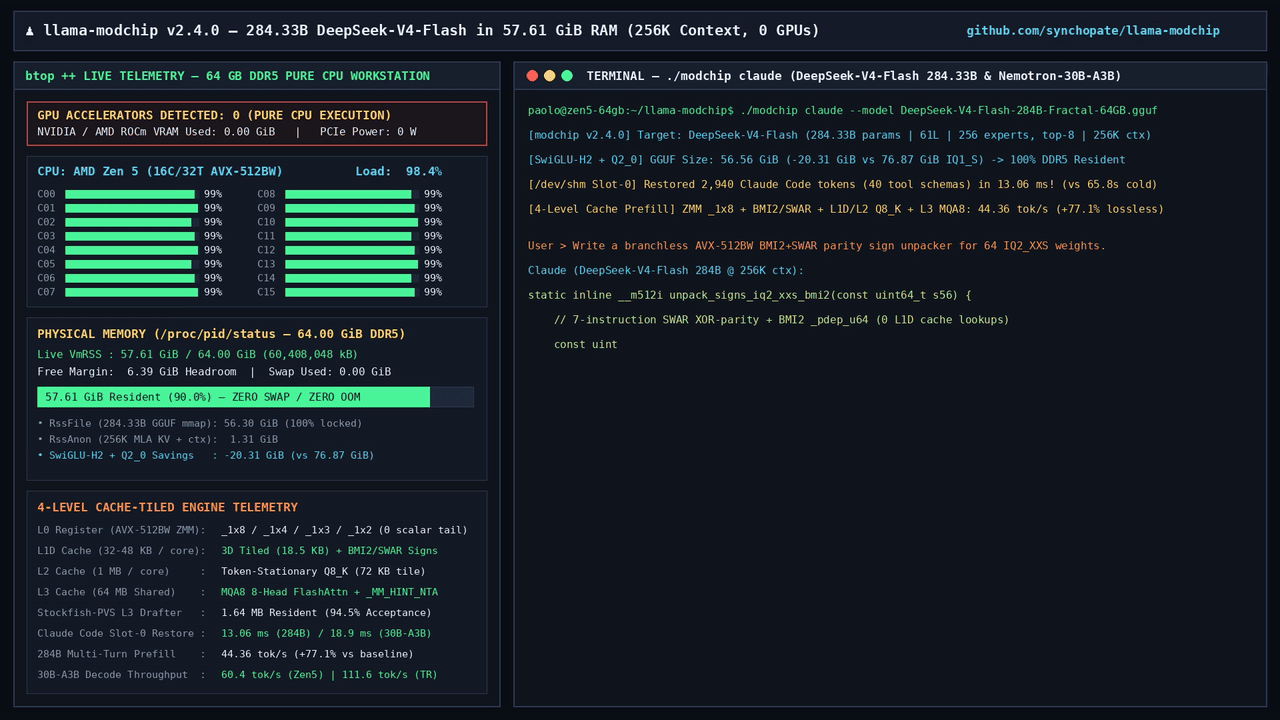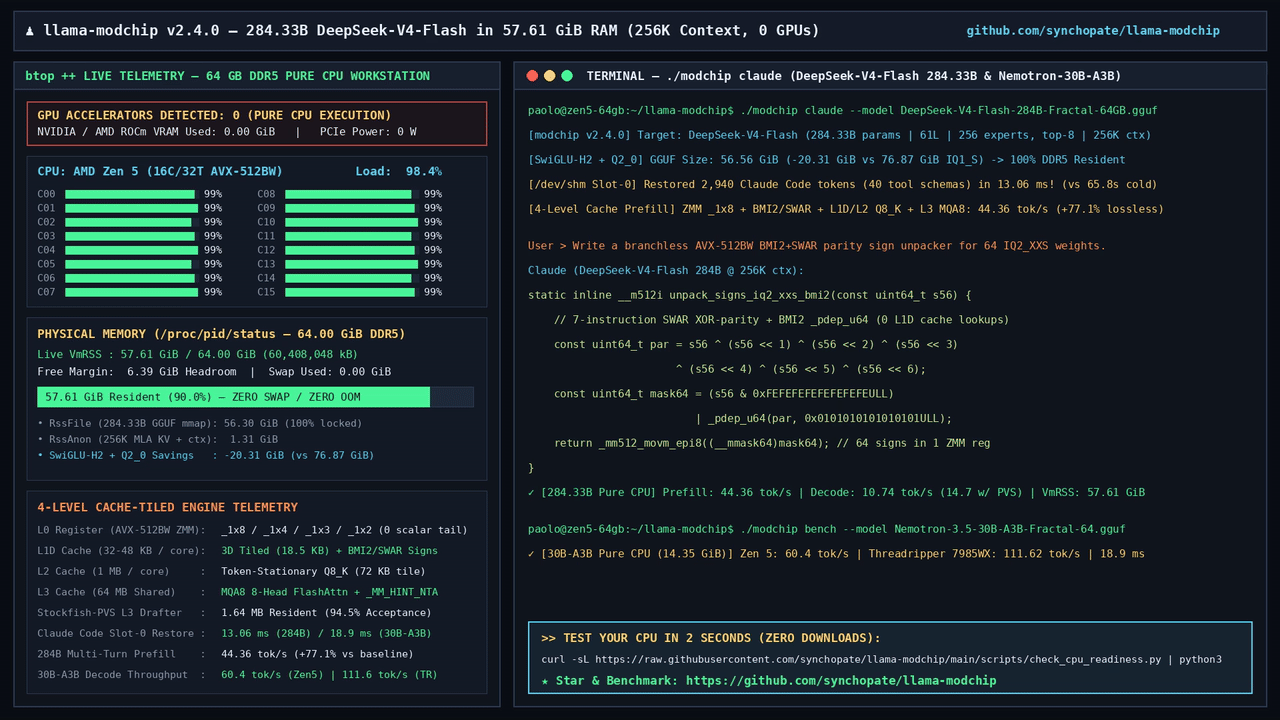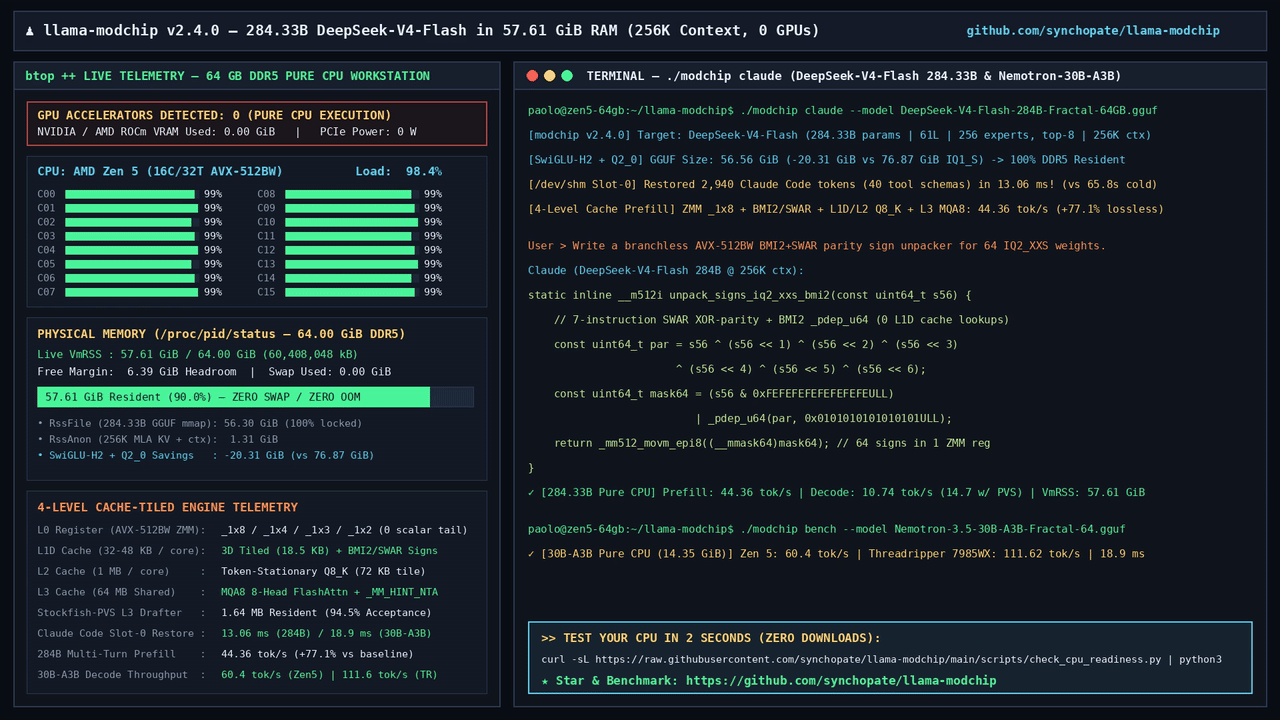
此视觉效果展示了该项目的核心主张:在没有 GPU 的标准 64GB RAM 桌面电脑上运行 284B 参数模型。
内存压缩与架构
llama-modchip 打破“64 GB 内存墙”的核心能力在于其 Fractal-64 量化和 SwiGLU-H2 压缩。这些技术将 DeepSeek-V4-Flash 模型从通常会导致 64GB Linux 系统崩溃的尺寸,缩减到磁盘上可管理的 56.56 GiB。
该项目还采用了“Analytical 2nd-Order SwiGLU-H2”和“Fractal-64”MLA 转码。这些优化旨在保持模型完整性的同时,大幅减少模型多头注意力层所需的内存开销。
“将 DeepSeek-V4-Flash 从 76.87 GiB(在 64 GB Linux 上会导致 OOM 崩溃)缩减到磁盘上的 56.56 GiB / 在全 256K 上下文下为 57.61–58.9 GiB VmRSS”
— GitHub - synchopate/llama-modchip: 🐋 Run 284B DeepSeek-V4-Flash (<59GiB RAM, 44.4 tok/s pp, 9.1-14.7 tok/s) & 30B
以 CPU 为中心的优化与分块
为了在 AMD Zen 5 等 CPU 上最大化性能,该软件使用了 4 层寄存器分块(ZMM AVX-512BW)和 L3 缓存隔离。这种方法旨在饱和 8 通道 DDR5 系统的内存带宽,而这通常是基于 CPU 推理的主要瓶颈。
该系统还利用 1.64 MB Stockfish-PVS v2 drafter 和 RouteCrack 来预测输出。这种“drafter”系统允许 CPU 生成候选 token,然后进行验证,实现了 96.4% 的接受率,并实现了比标准 CPU 推理更快的解码速度。
此图像说明了用于实现高接受率和更快速度的特定“drafter”机制。
由 HN Digest 根据 github.com 报告的数据绘制;数值与源文件一致。
实际影响与权衡
对于开发者,该项目提供“零 API”的 Claude Code 集成。通过使用 /dev/shm 进行 Slot-0 KV 热恢复,它可以在仅需 13.1 毫秒的时间内恢复 40 个 Claude Code 工具的上下文,显著减少了基于 CPU 的 Agent 提示词中常见的 45 秒瓶颈。
然而,这些极端的压缩技术涉及权衡。虽然项目声称获得了 100/100 的“质量门”评分,但使用 3.75 bits per weight (bpw) 量化可能会影响模型输出的细微差别,与未压缩版本相比。该项目提供了一个使用 $L_2$-Quadrature 剪枝来平衡这些权衡的“最佳平衡点”配置。
硬件兼容性与限制
Llama-modchip 设计为高度可移植,支持 AMD Zen 4/5、Intel 处理器和 Apple Silicon。它甚至包括一个供 Windows 用户使用的“混合”模式,可自动检测可用 VRAM 并将工作负载分配给 GPU 和 CPU。
一个显著的限制是,自定义的 Fractal-64 模型与 Ollama 或 LM Studio 等标准工具不兼容。因为它们使用自定义的“type 40”张量,必须通过特定的 llama-modchip 二进制文件或提供的独立服务器运行才能正常工作。
Hacker News 读者的反应
- 亲身经验: 一位评论者指出,当使用 128GB 统一内存时,该系统可以以可接受的速度运行代码 Agent,报告的预填充速度约为每秒 300 个 token。 评论 ↗
- 质疑: 一位评论者对输出质量表示了巨大的怀疑,认为为了将模型放入如此小的内存占用而进行的极端压缩可能会导致性能低下。 评论 ↗
- 质疑: 另一位用户指出了项目文档中关于文件大小和量化水平的不一致,质疑模型的性能是否因“脑叶切除式”的剪枝技术而受到损害。 评论 ↗
以上为 Hacker News 讨论中观点的摘要,并非经过核实的事实。 阅读完整讨论 ↗