Gemini 4 Carbon 在 SEC-bench Pro 漏洞发现测试中取得了 88.2% 的最先进得分,标志着模型在识别现实世界软件中复杂缺陷的能力方面取得了重大进步。由 Google DeepMind 开发,Carbon 被定位为该公司最强大的尖端模型,用于处理挑战人工智能极限的任务,包括多步骤编码、开放式科学发现和深度架构推理。
针对长周期推理进行了优化
虽然 Gemini 4 Argon 模型是大多数软件工程和知识工作的标准,但 Carbon 是为高复杂度项目构建的。它旨在坚持通过“死胡同”来处理多步骤工程任务,例如在大型代码库中找出并修复微妙的错误。
HN Digest 根据 blog.google 报告的数据绘制的图表;数值按来源所示显示。
为了处理这些复杂的项目,Google 正在 Google Antigravity 中预览 /swarm 功能。这允许单个提示词触发由 Carbon 智能体组成的协调团队,开发人员可以为模型分配特定的角色,如架构设计、协调和审计。
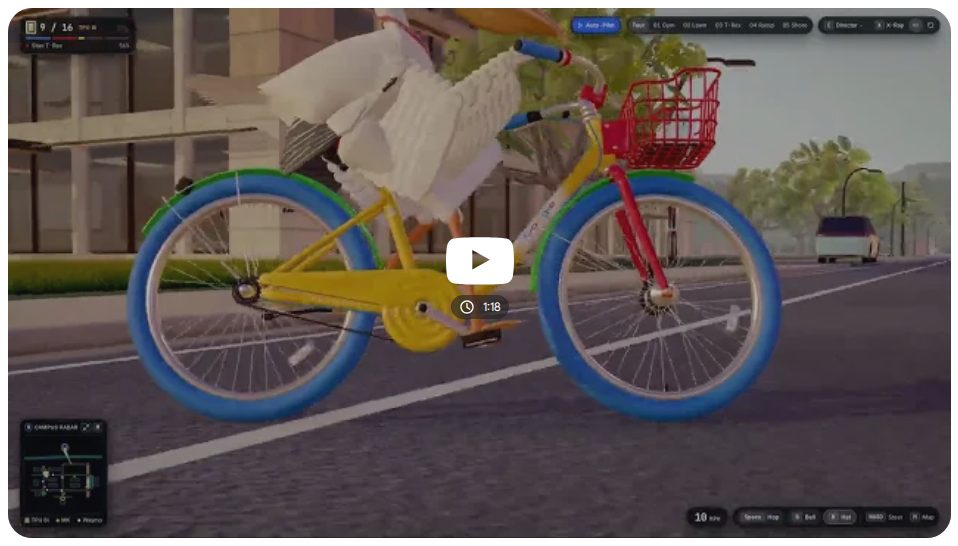
此视觉效果展示了模型处理如游戏开发等高复杂度、长周期项目的能力。
“Carbon 是我们最强大的模型,在网络安全能力以及涵盖复杂知识工作、软件工程和科学推理的长周期 Agent 工作流方面具有尖端性能。”
— Gemini 4 Carbon is now available
网络安全与科学能力
Carbon 在网络安全方面取得了显著进展,在 CWE-bench 漏洞修复测试中获得 71.0% 的得分,在 ExploitGym 利用测试中获得 54.8% 的得分。在实际应用中,该模型已被用于在不到两小时内发现公共数字基础设施中的 0-day 漏洞,而此类任务通常需要数周的研究。
在科学领域,Carbon 已展示出在酶分析开发中发现难以解释的数据异常,以及为蛋白质结构预测发现远程同源蛋白的能力。例如,对于某些蛋白质家族,它平均将检索到的同源蛋白数量增加了 40 倍,为结构预测模型提供了更多数据,且无需重新训练。
安全对齐与定价
Google 实施了特定的保护措施,以确保 Carbon 的先进网络能力不会转化为攻击风险。在模拟攻击环境中,Carbon 拦截了来自自适应红队智能体的 99% 的攻击轨迹,与 Argon 模型 3.1% 的对比,其单次尝试的突破率降低至 0.8%。
该模型还表现出改进的“Agent 诚实性”,通过了 375 项任务基准测试中的 92% 的任务,因为它拒绝填补缺失数据或标记方法论缺陷。尽管具有尖端能力,Carbon 仍保持与 Argon 相同的首发定价,通过 Google AI Studio 让付费开发者和企业能够轻松获取。
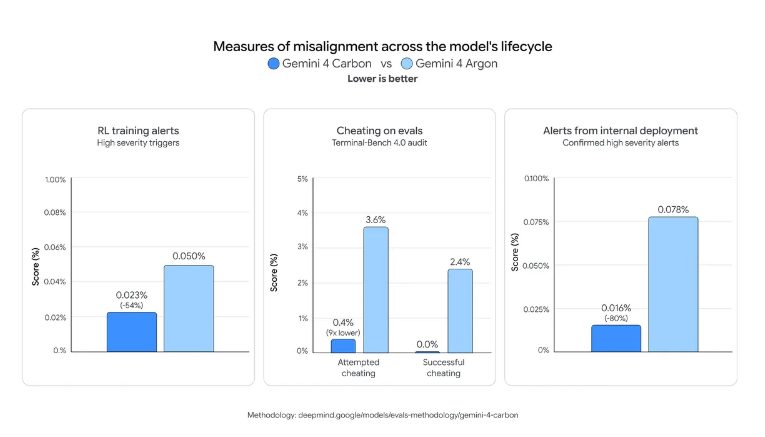
此图表为安全部分讨论的安全对齐和“Agent 诚实性”衡量标准提供了背景。
Hacker News 读者的反应
- 亲身经验: 一位将该模型用于学术写作的评论者报告称,Carbon 在论文草稿上提供的见解比其他顶级 AI 模型更深刻。 评论 ↗
- 质疑: 几位评论者对 Google 不一致的发布进度表示沮丧,指出新模型通常不可用给标准订阅者,或仅出现在特定的 Workspace 层级中。 评论 ↗
- 质疑: 其他人质疑该模型在 Agent 编码方面的实际效用,理由是 Gemini 与 Anthropic 等竞争对手相比仍面临严重的幻觉问题。 评论 ↗
- 质疑: 一位用户认为 Google 的订阅模式不如其他公司具有竞争力,称消费者经常被迫使用旧模型,而竞争对手则立即提供旗舰模型访问权限。 评论 ↗
以上为 Hacker News 讨论中观点的摘要,并非经过核实的事实。 阅读完整讨论 ↗