名为 GPT-6 Astra 的前沿 LLM 通过仅修改 0.016% 的权重,将 Qwen3.5-0.8B 模型的 MATH-500 准确率从 7.9% 提高到 48.1%。这一成就是通过“权重空间编程”实现的,这是一种 LLM 推理特定权重计算内容并直接修改它们的模型,而无需使用传统的训练循环或梯度下降。
思考循环问题
小型推理模型经常遭受“思考循环”的困扰,即它们无限重复相同的几行推理。在 Qwen3.5-0.8B 的案例中,其在 MATH-500 基准测试上的 93% 的答案达到了 32,768 个 token 的限制,而从未得出结论。
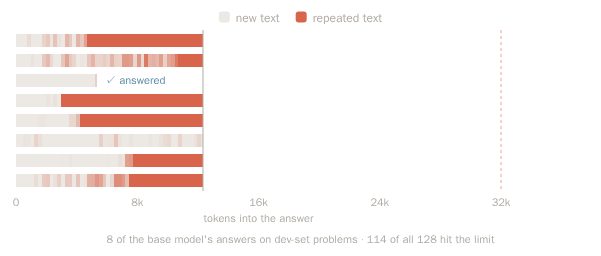
此图描绘了模型无限重复推理的“思考循环”问题。
权重空间编程通过识别负责这些行为的特定权重来解决此问题。通过编辑这些权重,开发人员可以移除模型现有能力的障碍,而不是试图在一个缺乏必要容量的模型中训练新的能力。
此图通过展示成功的导航任务来阐明权重空间编程的实际结果。
“Astra 仅更改了 0.016% 的权重,而 MATH-500 的准确率从 7.9% 跃升至 48.1%。”
— Can a Linear Program Do Weight-Space Programming?
权重编辑机制
Transformer 使用残差连接,其中每一层的输出都被添加到“残差流”中。当模型进入循环时,该流会朝着一致的方向偏移,研究人员称之为“循环方向” (u)。
编辑涉及修改 MLP 层的权重,使其将残差流推向与循环相反的方向。Astra 通过对第 15 层和第 19 层应用秩-1 变化来实现这一目标,有效地翻转了模型对于循环 token 的输出方向。
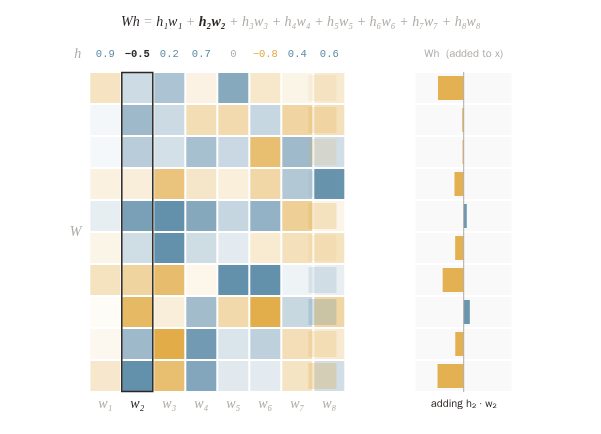
此图解释了修改 MLP 权重以抵消循环方向的机制。
Astra 的方法涉及试错搜索,花费了大约 8 小时和 28 次前向传播来确定要更改哪些权重以及更改多少。
从试错到线性规划
寻找最佳权重变化可以被建模为一个线性规划问题。通过将 token 标记为“循环”或“高效”并记录它们的激活值,问题变成了寻找一个向量 (v),该向量能将循环 token 推离循环方向,同时几乎不影响高效 token。
将其作为具有 L1 范数最小化的 LP 来求解,自然会产生稀疏解,仅选择最关键的权重列进行修改。虽然 Astra 的搜索耗时数小时,但 GPU 加速的 LP 求解器可以在大约一分钟内找到类似的解决方案。
测试显示,LP 衍生的编辑在 MATH-500 和 GSM8K 等基准测试上的表现与 Astra 一致,同时修改的权重显著减少(16,291 对比 Astra 的 130,188)。
由 HN Digest 根据 nathan.rs 报告的数据绘制;数值与源文件一致。
局限性与转向向量
当前的 LP 方法仍依赖 Astra 来识别特定的层和循环方向向量。它尚未能够自主选择干预的最佳层。
有趣的是,研究发现 LP 的推动力在不同 token 之间几乎是恒定的,这意味着修复也可以作为“转向向量”来实现——即在每个 token 处添加到残差流中的固定值。这在永久权重编辑和运行时推理修改之间提供了一种权衡。