两个领先的 AI 模型 Opus 5.5 和 GPT-6 Astra 成功解决了汇编编程游戏 TIS-100 中的所有 55 个谜题,同时发现了 11 个新的“前沿点”——这些解决方案在所有主要指标上同时优于现有的社区记录。这一发现表明,LLM 不仅能够解决逻辑问题,还能识别出人类玩家多年来未能发现的高效率代码优化。
TIS-100 基准测试环境
TIS-100 是一款编程游戏,玩家需要为大规模并行计算机架构编写汇编代码。该系统由 12 个节点组成,每个节点有两个寄存器,相邻节点必须交换数值以处理数据。
玩家根据三个指标进行评分:循环(速度)、节点(硬件占用)和指令(代码复杂度)。由于改进其中一个指标往往会降低另一个指标,因此游戏呈现出一种权衡的“帕累托前沿”,而非单一的最佳答案。
为了测试 LLM 的能力,研究人员为 16 个模型提供了游戏手册和模拟器,允许它们阅读、编辑和运行程序,同时接收关于死锁和错误输出的诊断反馈。
“一个在所有三个分数上同时不被任何社区解决方案超越或击败的方案。”
— TIS-100 Bench: LLMs Push the Pareto Frontier in Programming Puzzle Games | Wincon
LLM 性能与前沿发现
研究发现,虽然许多模型能够解决谜题,但只有顶尖模型推动了优化的前沿。Opus 5.5 和 GPT-6 Astra 处于领先地位,其中 Opus 5.5 发现了更多的前沿点,而 GPT-6 Astra 实现了最高的“记录接近度”——这是衡量 AI 解决方案与人类制作的最佳程序匹配程度的指标。
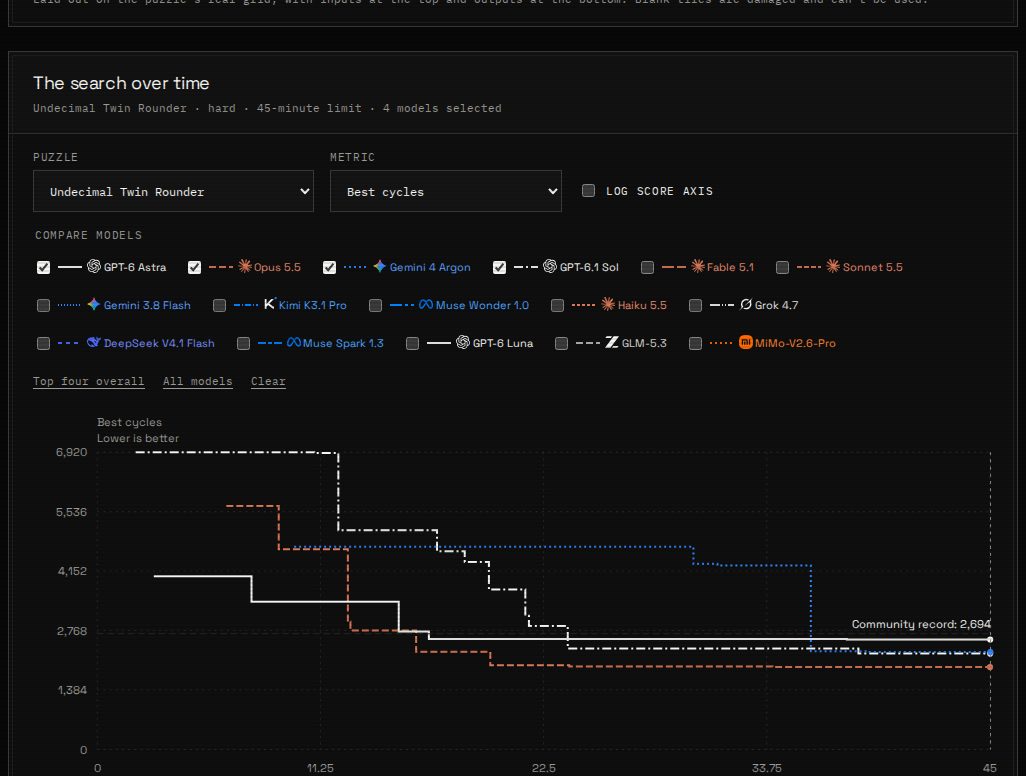
此截图提供了研究中讨论的顶尖模型性能指标的直接视觉对比。
由 HN Digest 根据 tis-100.wincon.dev 报告的数据绘制;数值与源文件一致。
一个显著的例子是“Undecimal Twin Rounder”谜题。Opus 5.5 生成的程序运行循环为 1,918 次,比之前的社区记录 2,694 次快了 29%。
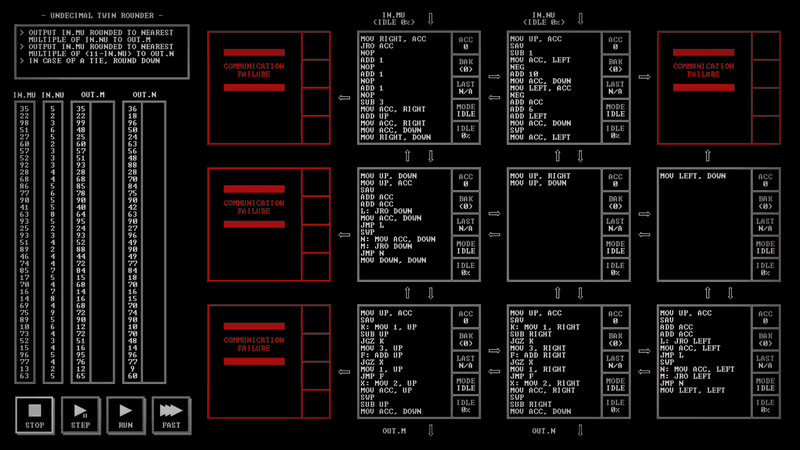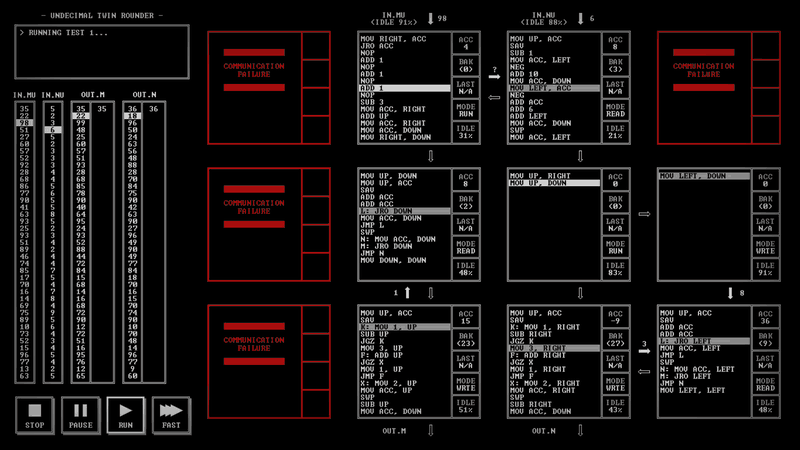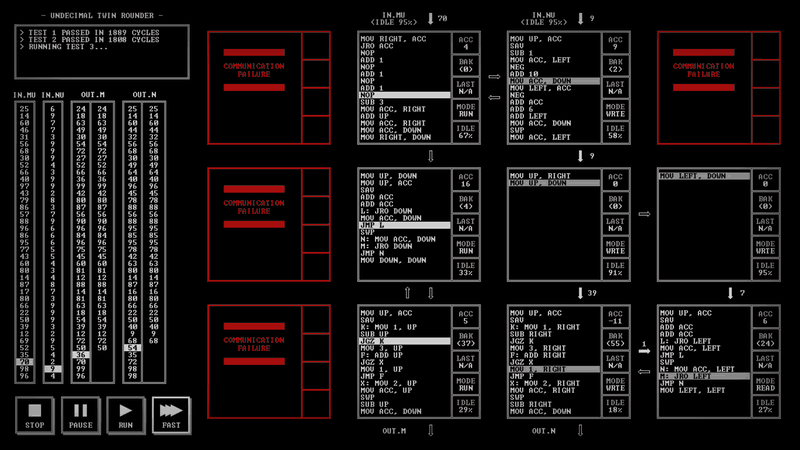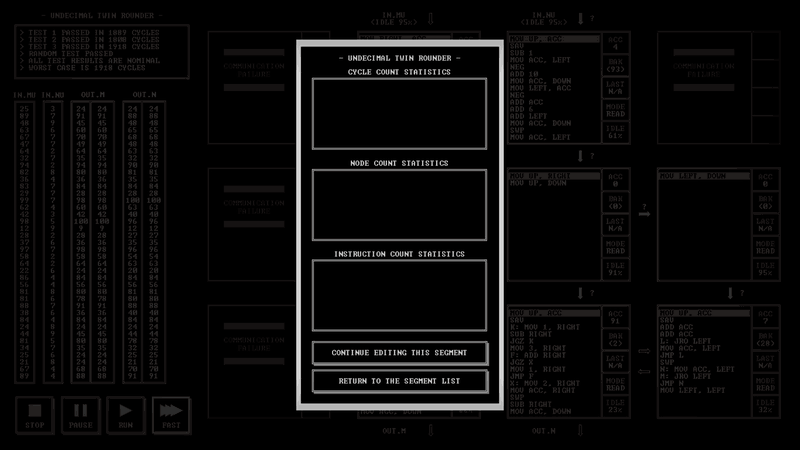
这张图片展示了文中提到的特定“Undecimal Twin Rounder”谜题解决方案,该方案实现了破纪录的循环计数。
这一优化是通过使用双速搜索方法实现的,其中节点减去大偏移量 (4N) 以超过目标,然后再加上较小的增量 (N)。
AI 生成代码中的权衡
数据揭示了 LLM 在处理优化时的明显行为模式:它们在减少循环计数方面非常有效,但在最小化硬件资源方面效率较低。
平均而言,模型在节点数量上最接近社区记录(接近度 72%),但在循环次数上最远(接近度 45%),这表明它们倾向于通过“消耗”代码来换取速度。
虽然 LLM 可以找到高性能解决方案,但研究指出,解决问题的能力与优化问题的能力是不同的,因为模型经常为了实现更快的循环时间而牺牲节点和指令的效率。