大语言模型中的推理可以被重新定义为路径规划问题,模型在高维的“令牌空间”中导航以达到有效的结论。这种视角的转变超越了简单的下一个令牌预测,将推理链框架化为一种旨在避免逻辑死胡同的动态导航策略。
作为令牌路径规划的推理
在这个框架中,推理不是文本的线性进展,而是通过可能令牌空间的导航任务。模型将正确答案视为目的地,将推理链视为到达那里的路径。
通过将推理视为路径规划,目标变成了识别通往解决方案的最可行路线。这涉及评估令牌空间中的多个潜在方向,并选择那些能够保持逻辑一致性的方向。
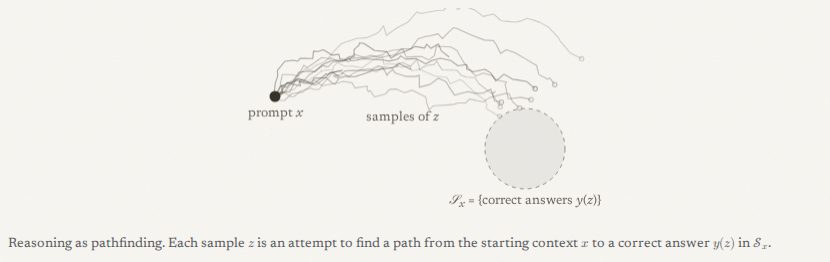
此图说明了文章的核心概念:推理作为通过令牌空间导航以达到目的的任务。
爬山算法与逻辑规避
导航过程表现得像爬山算法,模型向正确性的“巅峰”移动。这一过程的一个重要部分涉及识别并避开会导致错误结论的逻辑谬误。
这种机制的主要优点是防止“绝对愚蠢”的逻辑缺陷。通过及早识别这些错误,模型可以在错误传播到其余输出之前转变其推理路径。
纠错机制
暴露其内部“思考”过程的模型经常显示出自我纠正的模式,例如“等等!”时刻。这些作为内部标记,信号化偏离预期的逻辑路径,允许模型绕过障碍。
虽然模型在导航令牌空间以解决特定提示词的同时,在训练期间还会发生一个并行过程,即模型的权重被优化。这创造了一个双重路径规划叙事:一个通过词序,另一个通过底层参数。
权衡与不确定性
这种模型中的一个关键权衡是暴露通往解决方案的路径与标记问题的能力之间的平衡。有效的推理要求模型不仅要知道正确的方向,还要在偏离航线时能够识别出来。
如何精确衡量这些“爬山”移动的效率仍然是一个开放性问题。虽然这个概念框架提供了一种可视化推理的方法,但关于模型如何权衡“逻辑缺陷”与“正确路径”的具体指标仍在探索中。
Hacker News 读者的反应
- 替代方案: 一位评论者建议,推理应该通过识别解决方案的能力和标记问题的能力共同衡量,并指出防止基础逻辑缺陷似乎是一个主要优点。 评论 ↗
- 质疑: 一位读者认为,作者的框架与“智能必然通过更多推理而提高”的观点相矛盾,这可能会削弱关于递归自我改进的假设。 评论 ↗
以上为 Hacker News 讨论中观点的摘要,并非经过核实的事实。 阅读完整讨论 ↗