Anthropicでは、Claude Codeチームにおいて、コードベースの約90%がAIエージェントによって執筆およびレビューされる規模に達しています。このボリュームで品質を維持するために、チームは人間中心のレビューサイクルから「検証ループ」へと移行しました。これは、人間がプルリクエストを確認する前に、エージェントが特定の証拠に基づいて自身の作業を検証する自動プロセスです。
検証ループのメカニズム
検証ループとは、AIエージェントが自身の作業をチェックし(テスト、リンター、またはカスタムチェックを実行)、失敗を自動的に修正しようとする反復サイクルです。これらのステップを自動化することで、チームは数十から数百のエージェントを並列で実行できます。一方、手動でのチェックでは開発者が一度に監視できるのは1つか2つのエージェントに限られます。
チームは、エンドツーエンド(E2E)テスト、プロパティテスト、および差分テストという3つの特定のテストタイプを優先しています。E2Eテストは最も効果的であると考えられており、カートへの商品追加などの実際のユーザーフローを記述し、エージェントが回避することが困難な決定的な「完了」基準を提供するためです。
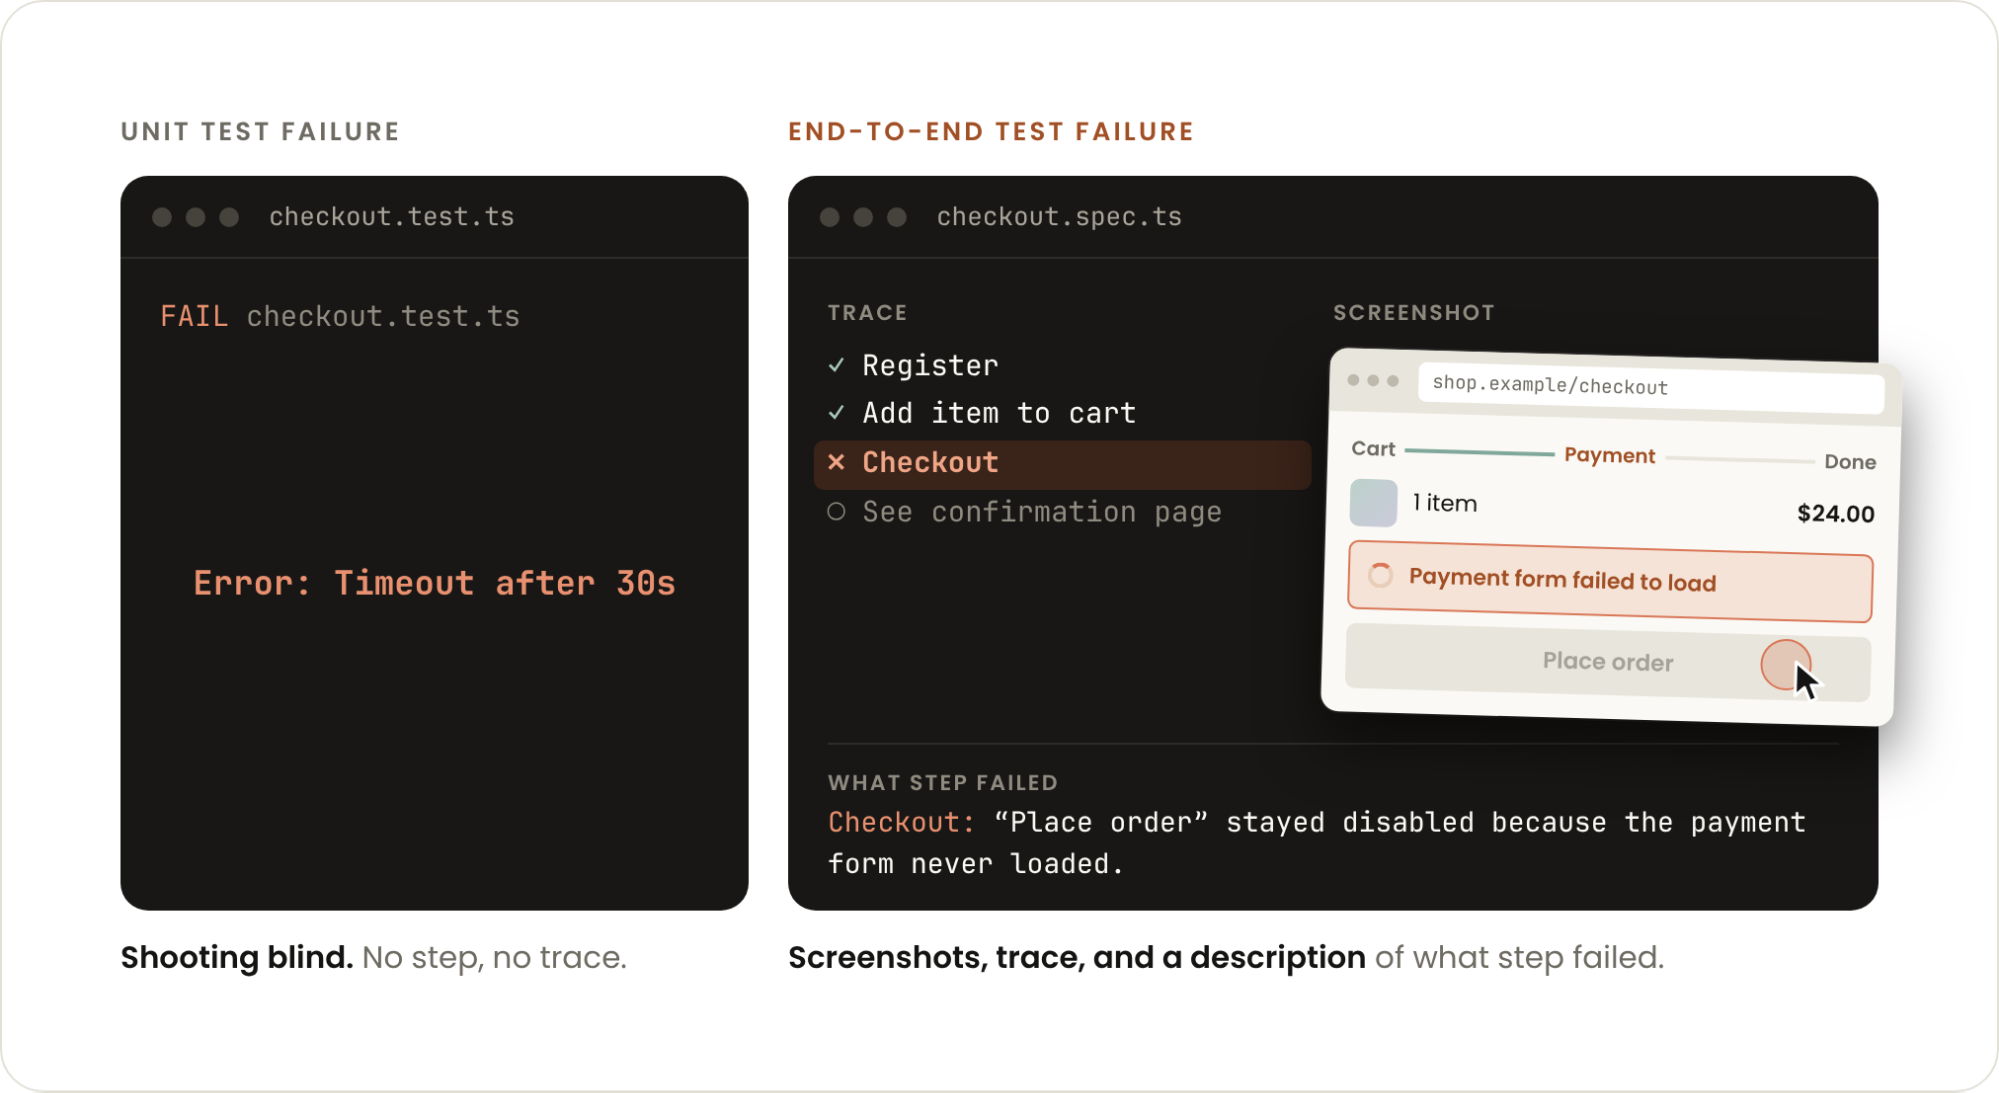
この画像は、なぜチームがエンドツーエンドテストを優先するのかを示しています。それらはエージェントが無視したり「欺いたり」することが難しい具体的な失敗の証拠を提供するからです。
この図は、E2Eテストが決定的な「完了」基準と視覚的証拠を提供するため最も効果的であるという主張を裏付けています。
「検証ループは、Claudeにより多くの仕事を委ねるためのビルディングブロックです。これらがないと、すべてを自分でチェックしなければならないため、実際には一度に1つか2つのClaudeしか実行できません。」
— How the Claude Code team thinks about verification / claude.dev Blog
エッジケースと不変性のテスト
標準的なプロンプティングでは見逃される可能性のあるエラーを捉えるために、チームはプロパティテストを採用しています。これらは`fast-check`や`Hypothesis`などのライブラリを使用して数千の入力を生成し、「アカウント残高は決してマイナスにならない」といった不変性が、不明瞭なエッジケースにおいてさえ維持されていることを証明します。
機能が同一に保たれる必要がある大規模な移行では、チームは差分テストを使用します。これは旧システムと新システムの両方を同じ入力で実行し、旧システムを「オラクル(正解)」として使用して、新しい実装におけるいかなる相違も特定する手法です。
ルールをスキルとしてコード化する
Anthropicはこれらの手動チェックを「スキル」としてコード化しています。これは`.claude/skills/`フォルダ内のMarkdownファイルであり、特定の動作と許可されたツールを定義します。例えば、「verify」スキルを使用してシミュレーターを起動しアプリを検査することで、エージェントに稼働中のシステムに対する「手と目」を提供することができます。
エージェントが自身の制約を回避するのを防ぐため、チームは検証ルールをプルリクエスト自体からではなくベースブランチから読み取るように徹底しています。これにより、エージェントが自身の出力を判定するチェックそのものを修正することを防いでいます。
人間の介入と信頼性
自動化が目標ではありますが、システムには「ヒューマン・イン・ザ・ループ」のトリガーが含まれています。もしエージェントが3回の反復試行の後にチェックを解決できなければ、処理を停止し人間の対応を要求します。これにより、複雑な障害が無視されることなく引き上げられることが保証されます。
また、チームは39項目の信頼性チェックリストを維持しており、それぞれがdiff(差分)から読み取れるトリガーを持っています。Claudeはdiffを読み取り、トリガーが一致する項目のみを確認します(通常は3〜10項目)。これにより、誰も過去の障害内容を暗記する必要はありません。
Hacker Newsの読者の反応
- 疑問: あるコメント投稿者は、多数の並列検証ループを実行することの高いコストについて懸念を表明し、わずか数人のエージェントに対する現在のトークン費用ですでにかなりの額になっていると指摘しました。 コメント ↗
- 疑問: 別のコメント投稿者は、チームがコードの90%がAIによって執筆されていると主張している一方で、残りの10%のコードベースの性質について理解することに強い関心があることを示しました。 コメント ↗
Hacker Newsのスレッドで出た意見の要約です。事実として検証されたものではありません。 議論の全文を読む ↗