AnthropicとTheoremは、大規模言語モデル(LLM)が、以前は非現実的と考えられていた規模で、実世界のソフトウェアに対する形式的な正当性の証明を生成できることを実証した。Claudeを使用して、100以上のオープンソースライブラリに対してアセンブリコードレベルでのセキュリティプロパティを証明することにより、チームはAIが複雑なソフトウェアと形式検証に必要な厳格な数学モデルとの間のギャップを埋められることを示した。
この画像は、複雑なソフトウェアと厳格な数学モデルの間のギャップを埋めるためにLLMを使用するという、この記事の核心的な前提を説明している。
LLMによる証明のスケールアップ
歴史的に、形式検証は膨大な人的労力を必要としたため、航空機などのミッションクリティカルなシステムに限定されていた。例えば、seL4オペレーティングシステムカーネルを形式的に検証するのに20人年を要した。Anthropicの研究は、LLMがこのプロセスの大部分を自動化し、プログラムがメモリ安全性のエラーなしに正常に終了することを保証するために、RISC-Vアセンブリコードの証明を生成できることを示している。
この変化により、以前は複雑すぎて取り組めなかったプロダクショングレードのライブラリの検証が可能になる。AIを使用して実行環境の一般的なモデルに対する証明を生成することで、開発者は証明されたセキュリティ保証を開発ライフサイクルに統合するワークフローへと移行できる。
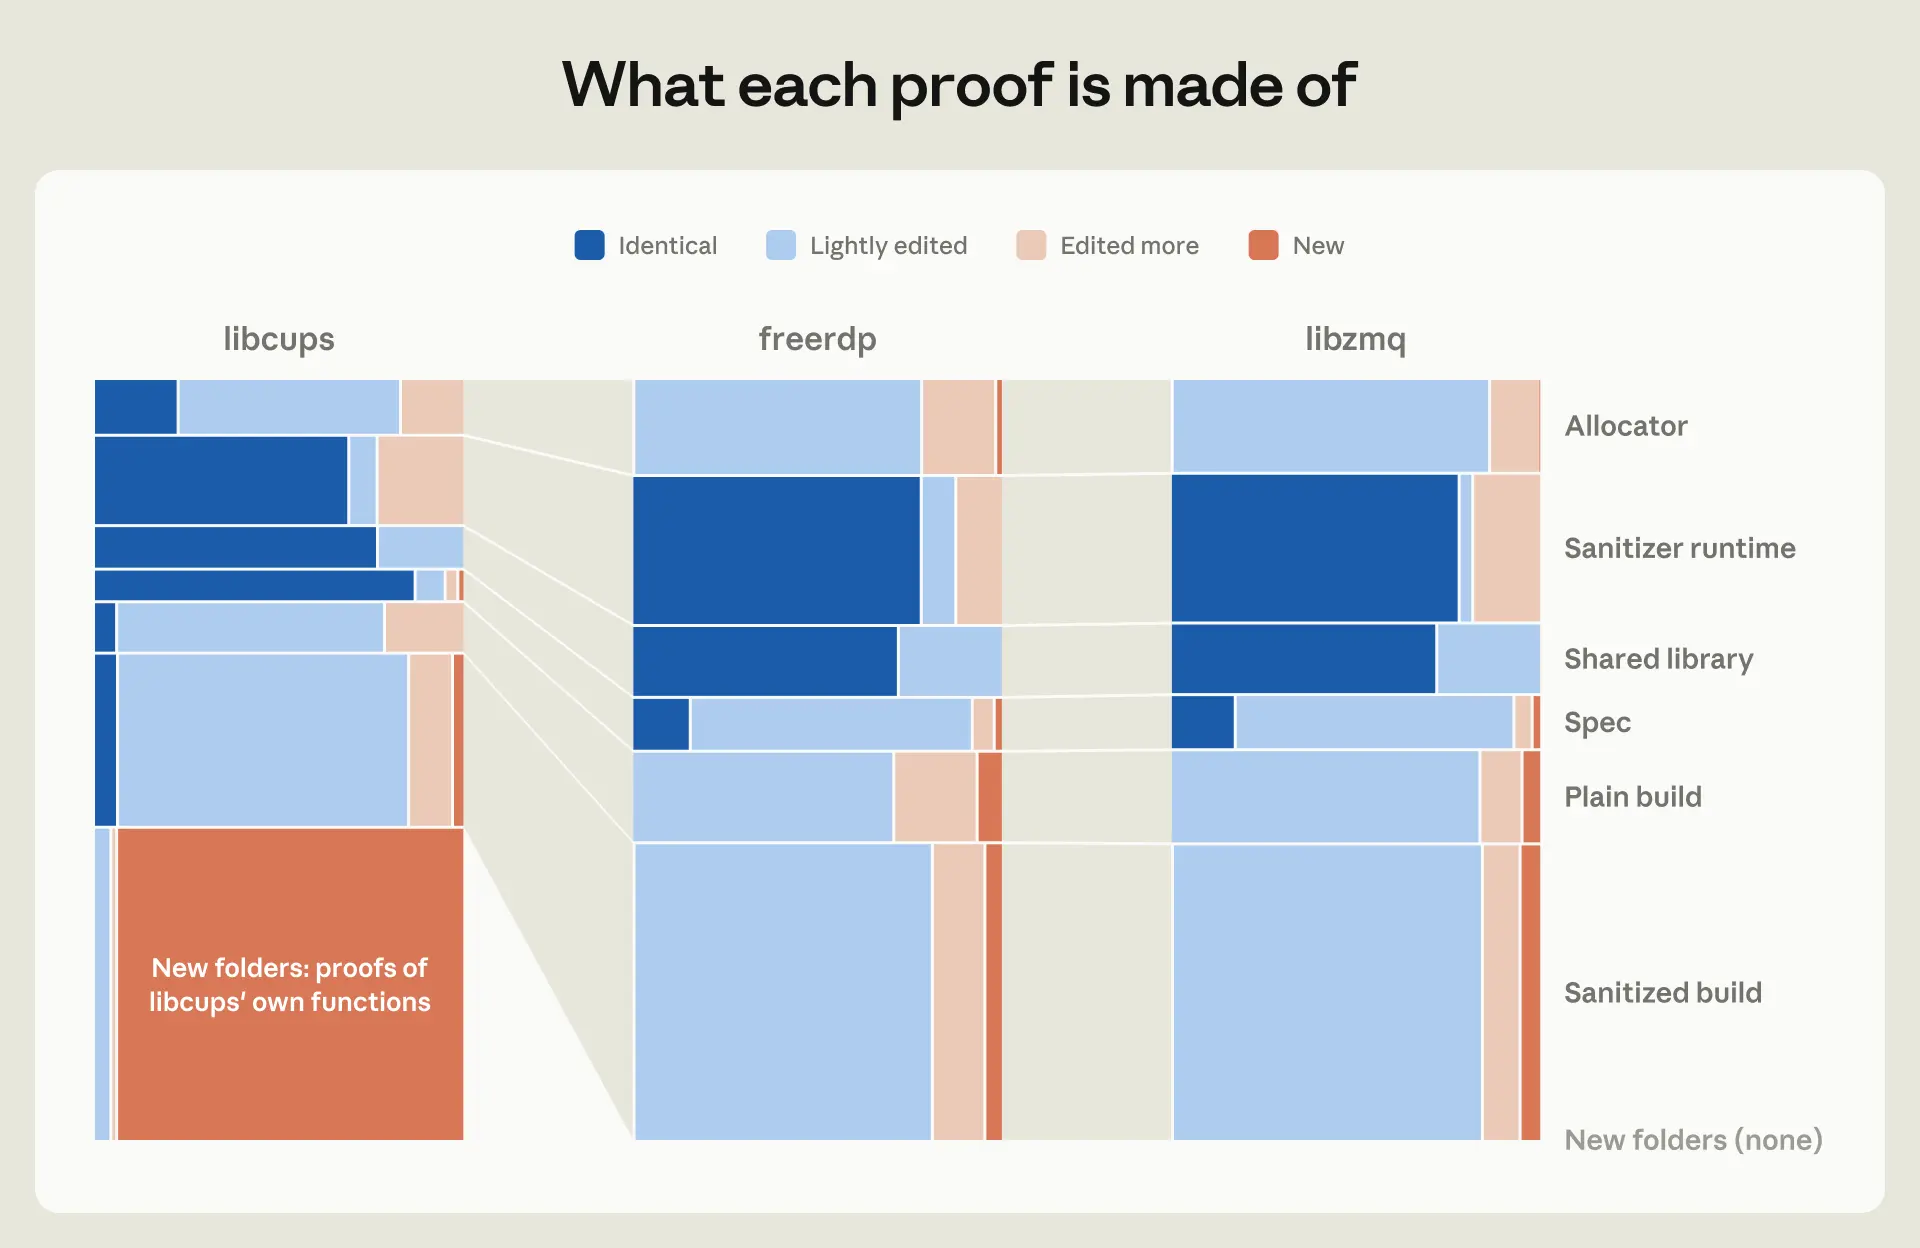
このチャートは、AIによって生成された証明を使用して現在検証可能なプロダクショングレードのライブラリの具体的な例を提供している。
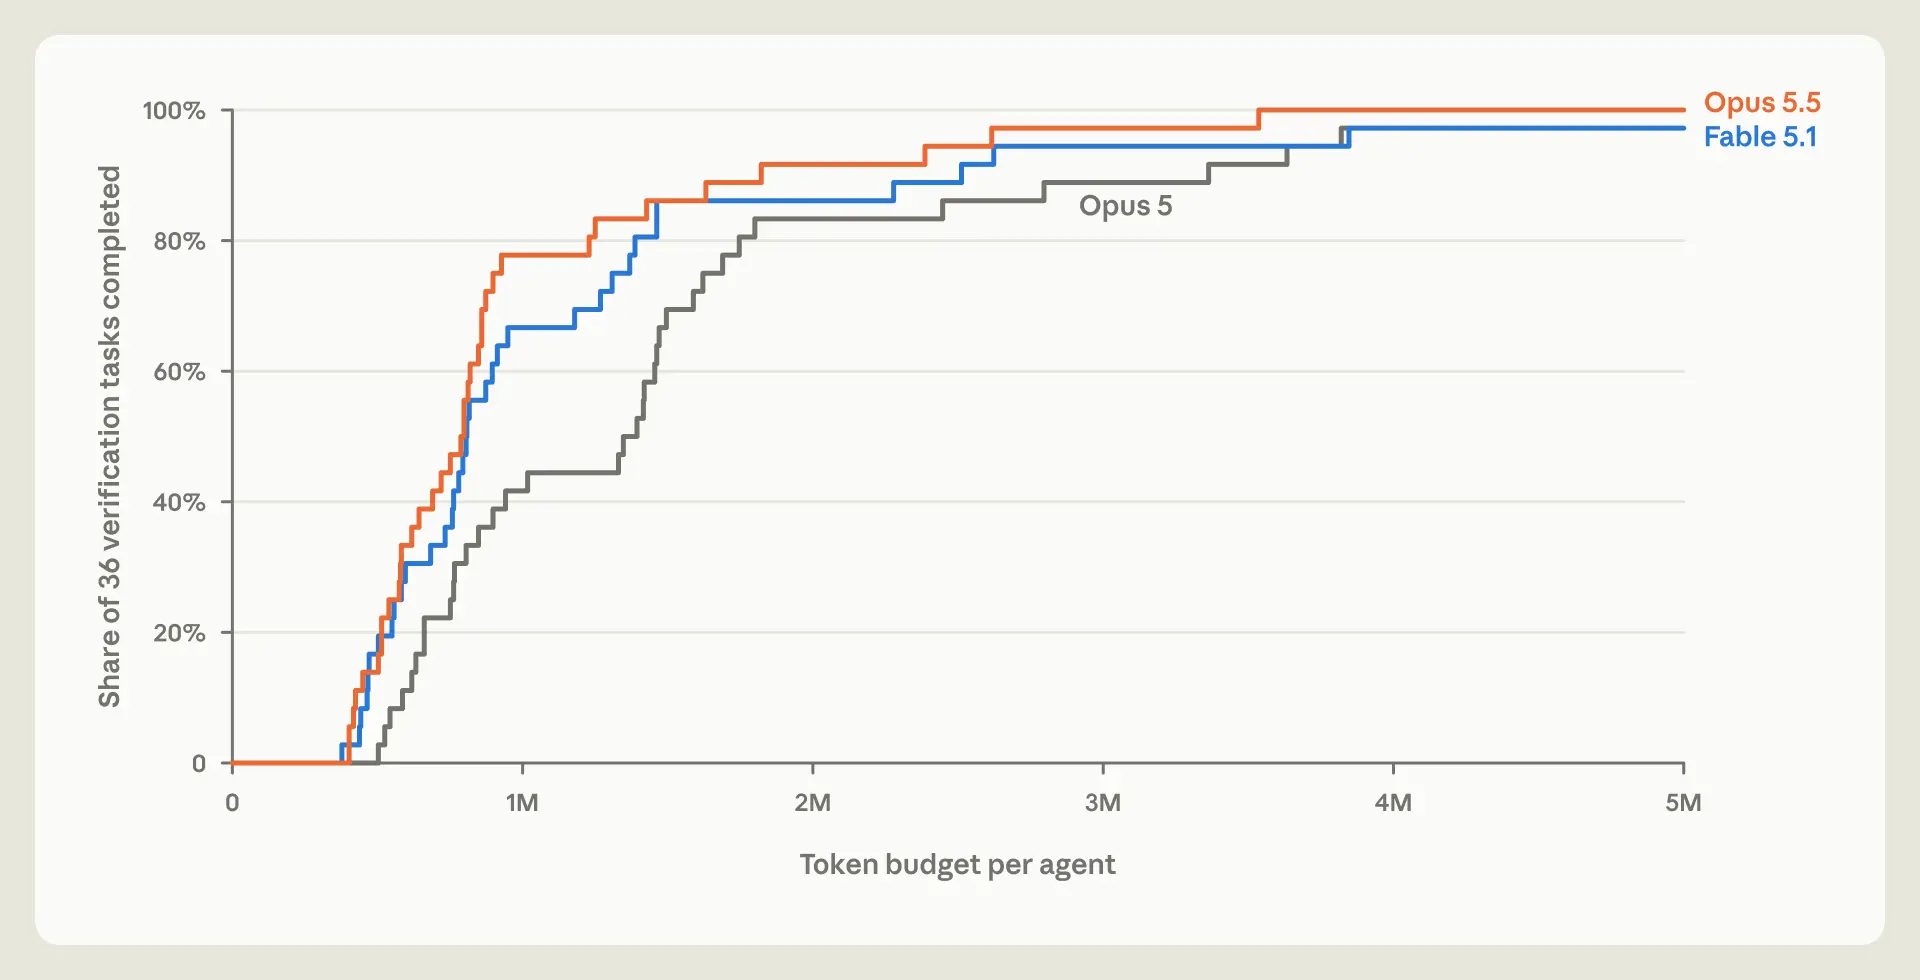
このチャートは、検証タスクを完了するための異なるモデルの効率を定量化し、証明のスケールアップに関する議論を裏付けている。
「形式検証はforall(すべての)主張を行い、テストはexists(存在する)主張を行う。検証が困難なコンポーネントのいずれかの間違いが、証明の崩壊につながる可能性がある。」
— Formal Verification is Not Verifiable
信頼されるコンピューティング基盤(Trusted Computing Base)
形式検証の核心的な制限は、証明が成立するために正しいと仮定しなければならないコンポーネントである「信頼されるコンピューティング基盤」に依存していることである。これには、基礎となるマシンのセマンティクス、オペレーティングシステムのプロセスセマンティクス、および証明器自体が含まれる。
これらの検証が困難なコンポーネントのいずれかにバグが含まれている場合、得られる証明が無効になる可能性がある。これを緩和するために、研究者たちは高レベルプログラミング言語のセマンティクスをモデル化するのではなく、より単純なマシンのセマンティクスをモデル化する「バイナリ検証」を模索している。
プロパティ vs. 絶対的な正当性
専門家は、「形式的に検証済み」という用語がしばしば曖昧に使われており、「形式的に検証されたプロパティ」に置き換えられるべきだと主張している。ソフトウェアは本質的に複雑であるため、システムのすべてのレイヤーに対して一様な正当性の概念を作り出すことは多くの場合不可能である。
エンジンやデータベースは数学的に明確に定義されているかもしれないが、ユーザー向けのコンポーネントはしばしば審美的な要求や主観的な要求によって動かされる。目標は、マルチスレッドや分散システムが今後数年間大きな課題として残ることを認めつつ、バイナリレベルで特定の一次プロパティが証明された、検証可能なコンポーネントのスタックへと移行することである。
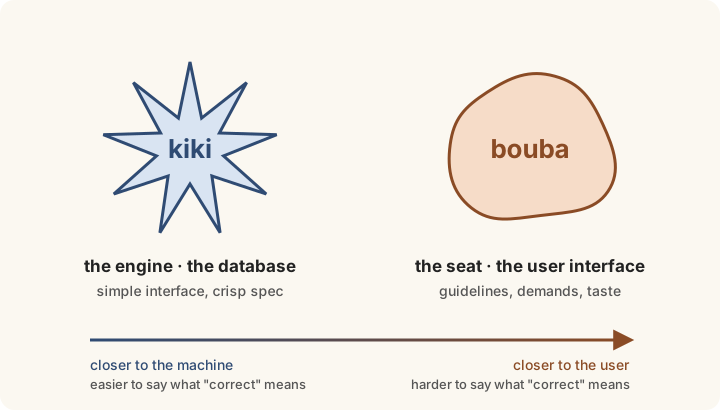
この図は、ユーザー向けコンポーネントの複雑さを考慮し、「形式的に検証済み」という用語を「形式的に検証されたプロパティ」というニュアンスに置き換えるべきであるという主張を支持している。