1型糖尿病の研究者が、15種類の異なる予測アーキテクチャをテストするための「モデル・ズー」を開発した。その結果、XGBoostやLightGBMのような古典的な機械学習モデルは、現在、2時間先の血糖レベルを予測する際にディープラーニングモデルよりも優れた性能を発揮することが判明した。
モデルの性能とベンチマーク
評価では、古典的な回帰(ARIMA、SARIMAX)、ディープラーニングアーキテクチャ(LSTM、GluNet)、および大規模な基盤モデル(Chronos-2、TimesFM 2.5)を含む幅広いモデルを比較した。テストは、115日間の持続血糖測定(CGM)データの個人データセットと、公開されているMetaboNetデータセットの2つの異なるデータセットで実施された。
個人データセットでは、XGBoostが60分先の予測でRMSE 22.2 mg/dLを記録し、首位となった。著者のカスタムTransformerであるT1DMAI D16 DILATEは、RMSE 22.8 mg/dLで僅差の3位となった。MetaboNetデータセットでは、XGBoostが引き続き首位を維持した一方で、T1DMAIモデルは90分時点でテストされたすべてのモデルの中で最も低いRMSEを達成した。
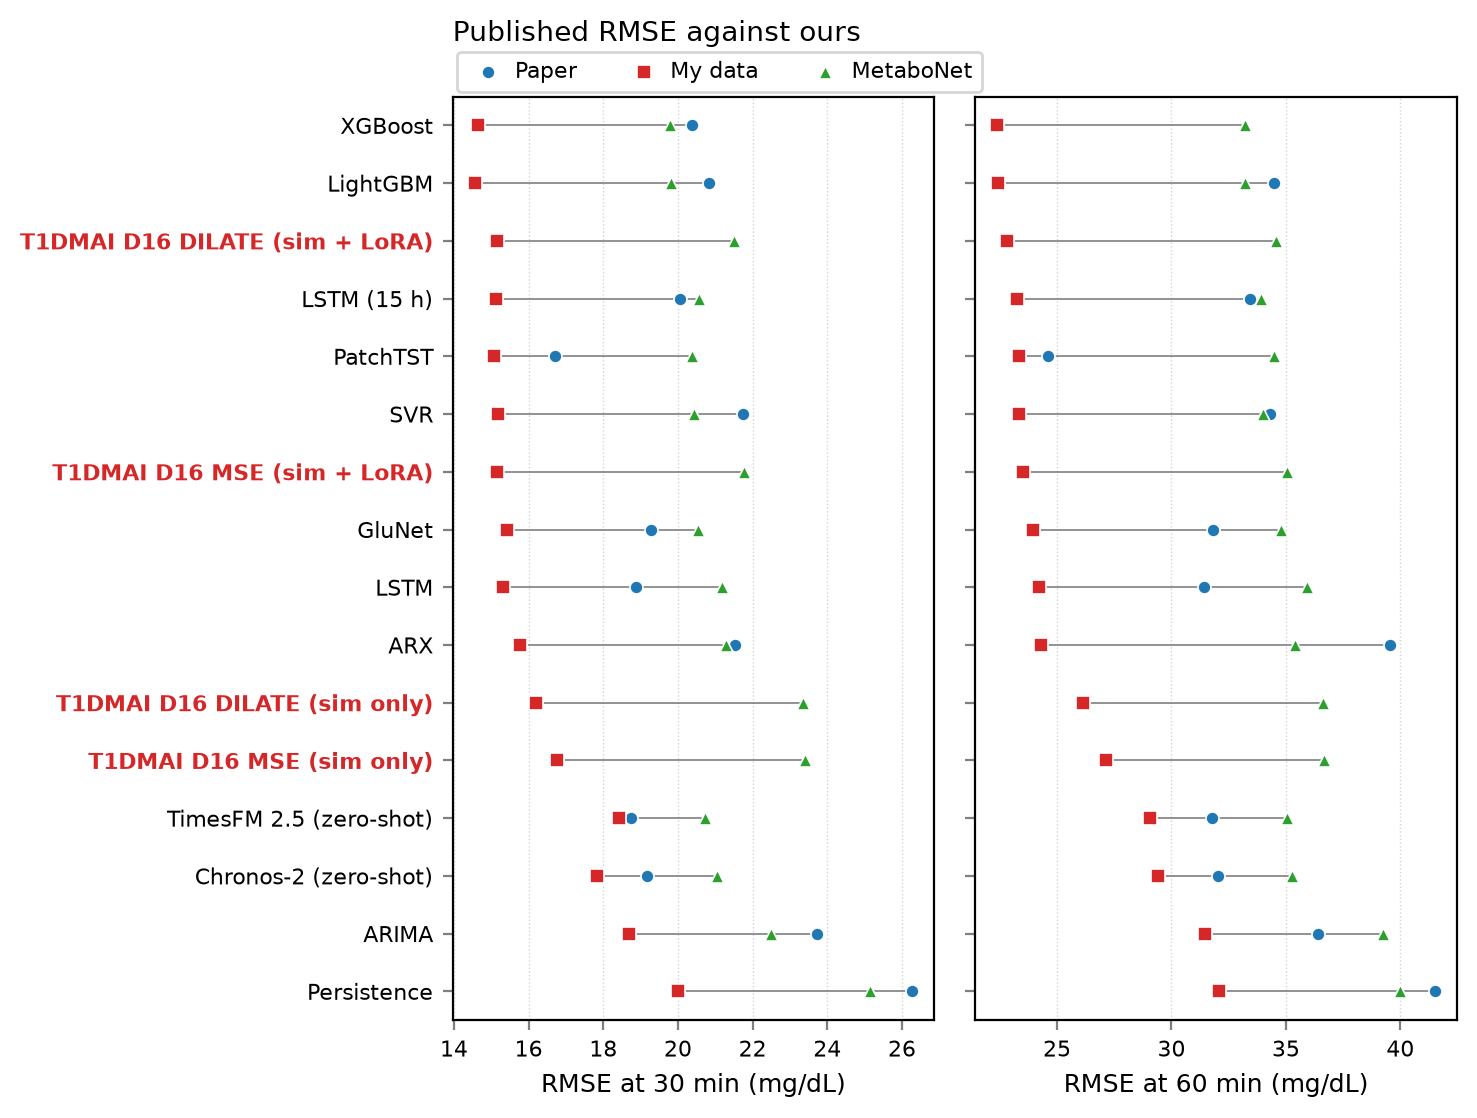
この図は、XGBoostとカスタムのT1DMAIモデルを他のアーキテクチャと比較した主要なベンチマーク結果を示している。
「すべてのモデルはひどい。XGBoostが最高だが、自分のモデルもそれに近い。」
— GitHub - 0xdeadf1sh/T1DMAI: A model zoo of blood glucose forecasters trained & tested on my own data
アーキテクチャとトレーニング手法
T1DMAIモデルは、効率を重視して設計されたエンコーダーのみのTransformerであり、幅16の16レイヤーと合計31,253のパラメータを使用している。このモデルはCGMデータ、炭水化物の吸収曲線、インスリンの作用曲線を処理し、2時間のウィンドウにおける毎5分ごとのステップに対して、7つの分位数(5%から95%の範囲を表す)を出力する。
性能を向上させるために、研究者はLow-Rank Adaptation(LoRA)アダプター(3,771のパラメータを持つ小さなコンポーネント)を使用して、実際のトレーニングデータでモデルを微調整した。このアダプターにより精度が大幅に向上し、個人データセットにおける60分先のRMSEは26.1 mg/dLから22.8 mg/dLに減少した。
HN Digestによる図表(github.comの報告数値に基づく)。数値はソースの表記通り。
複雑さと速度のトレードオフ
基盤モデルの計算コストと古典的モデルの速度の間には、大きなトレードオフが存在する。Chronos-Bolt miniのような基盤モデルは2,100万以上のパラメータを含み、1回の予測に数秒を要するのに対し、T1DMAIモデルは約5.6〜7.3ミリ秒で推論を実行できる。
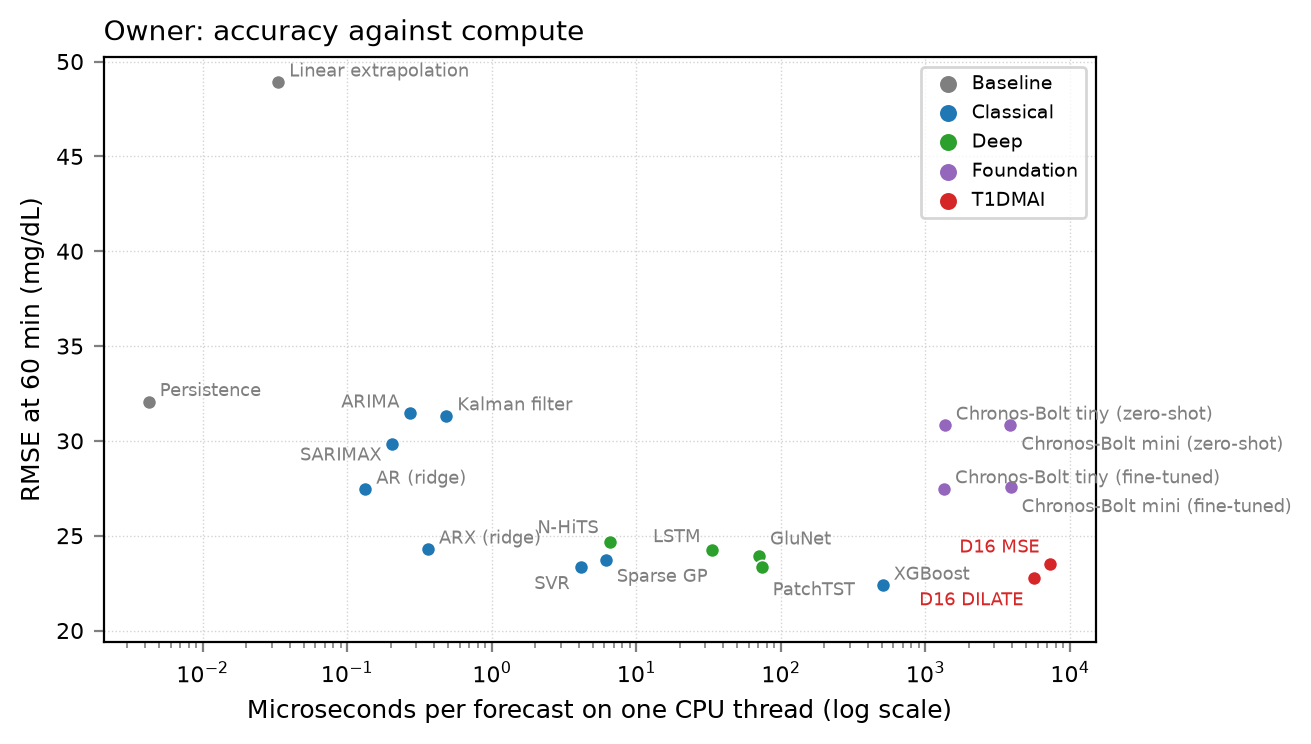
この画像は、大規模な基盤モデルと比較したT1DMAIモデルの効率に関する議論を裏付けている。
一部のディープラーニングモデルの高い精度にもかかわらず、研究者は、多くの低RMSEモデルがMetaboNetデータセットにおいて「低血糖(hypoglycemic events)」を捉えられなかったことを指摘した。そのデータセットでは、線形外挿の方が特定の事象を捉える上で実際に優れた性能を示した。このことは、一般的な精度と、重要で稀な臨床的事象の検出を両立させることの難さを浮き彫りにしている。
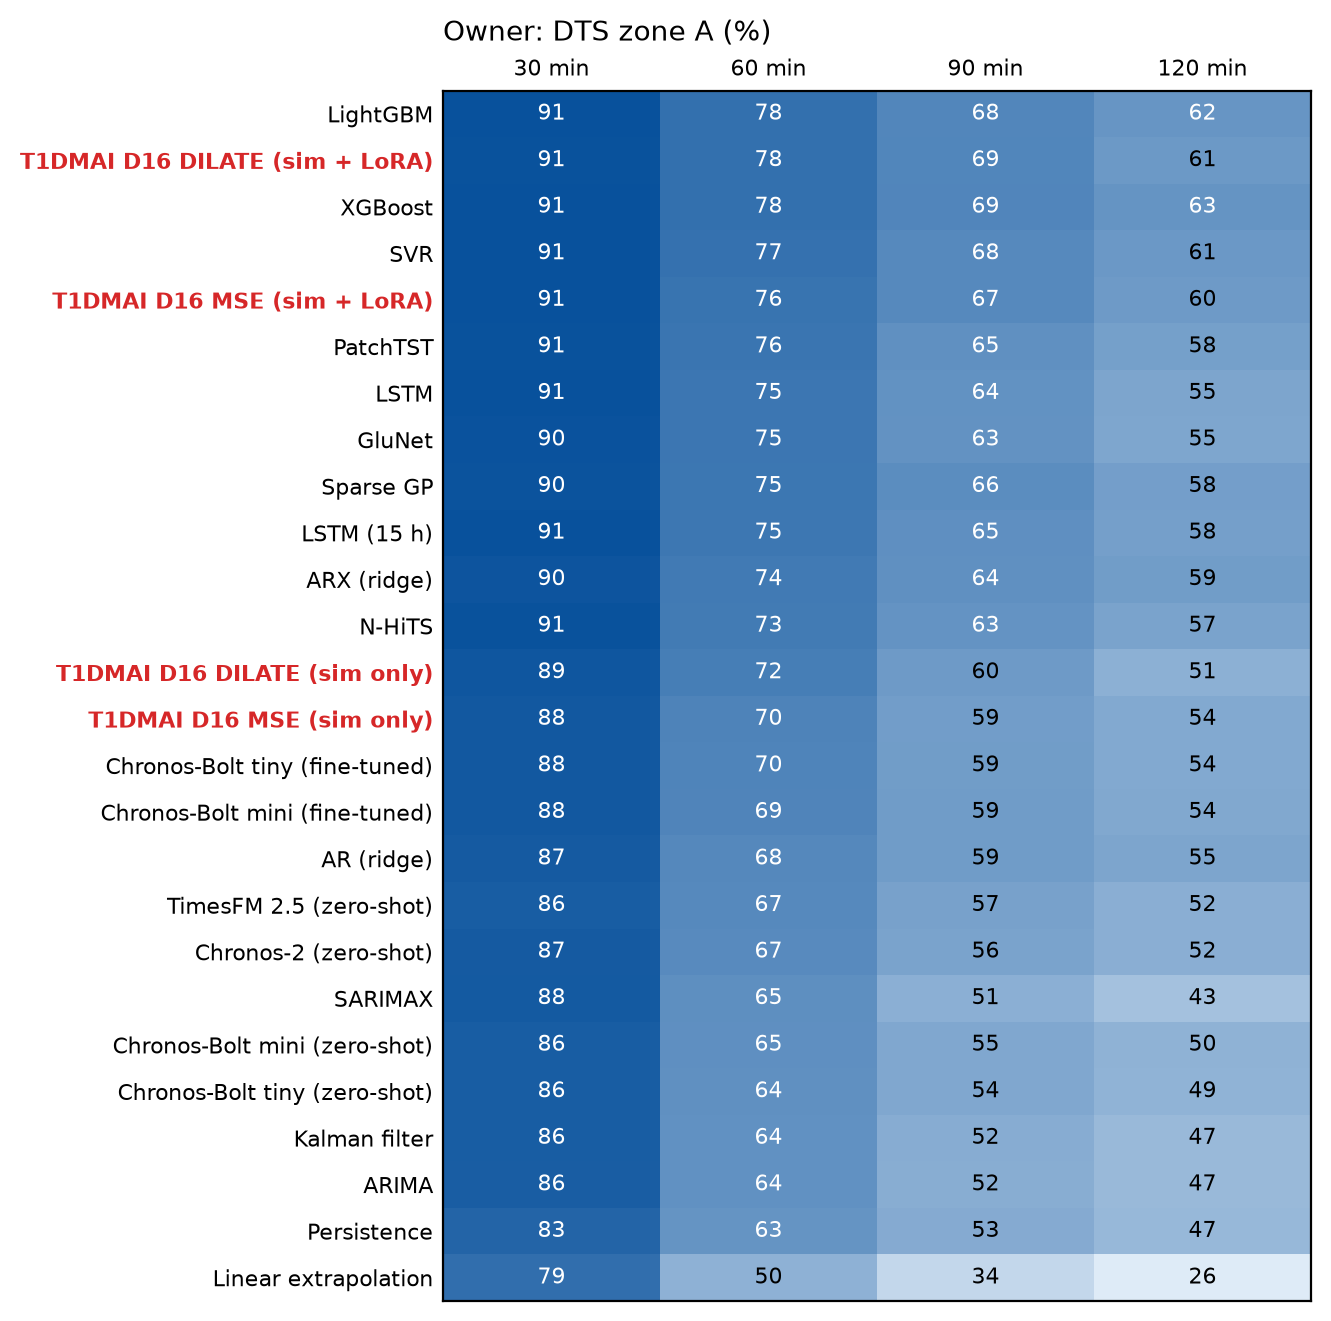
この視覚資料は、一般的な精度と低血糖などの特定の臨床的事象の検出を両立させることの難さを説明するのに役立つ。
研究の限界と安全性
この研究は、現在、個人データのサンプルサイズが小さく(35日間にわたりN=1)、モデルが研究用アーティファクトであるという点に制限がある。研究者は、このソフトウェアは臨床的に検証された医療機器ではなく、医療、診断、または治療の決定に使用してはならないことを明示している。
また、結果はモデルの性能が被験者によって大きく異なることも示している。例えば、MetaboNetデータセットでは、一部のモデルにおいて90%の予測帯が75〜78%の確率で真値を保持していたのに対し、LoRAアダプターを使用した場合は81〜85%に達した。
Hacker Newsの読者の反応
- 代替案: あるコメント投稿者は、自身の健康を管理するために、炭水化物、インスリン、睡眠、および運動のデータを相関させるためのカスタムダッシュボードを構築した個人的な経験を共有した。 コメント ↗
- 疑問: ある読者は、モデルに特定の食事情報が含まれているか疑問を呈し、そのデータがどのように処理されるかについての説明を求めた。 コメント ↗
Hacker Newsのスレッドで出た意見の要約です。事実として検証されたものではありません。 議論の全文を読む ↗