Qwen3-1.7B言語モデルにおいて、単一の会話は単一のデータポイントではなく、各トークンが2,048個の数値のベクトルで表される内部状態のシーケンスです。研究者たちは、これらの状態の数千を3次元投影にマッピングすることで、英語の会話が極めて平坦な幾何学的形状を占めており、その変動の99.3%が単一の3D平面内に含まれていることを発見しました。
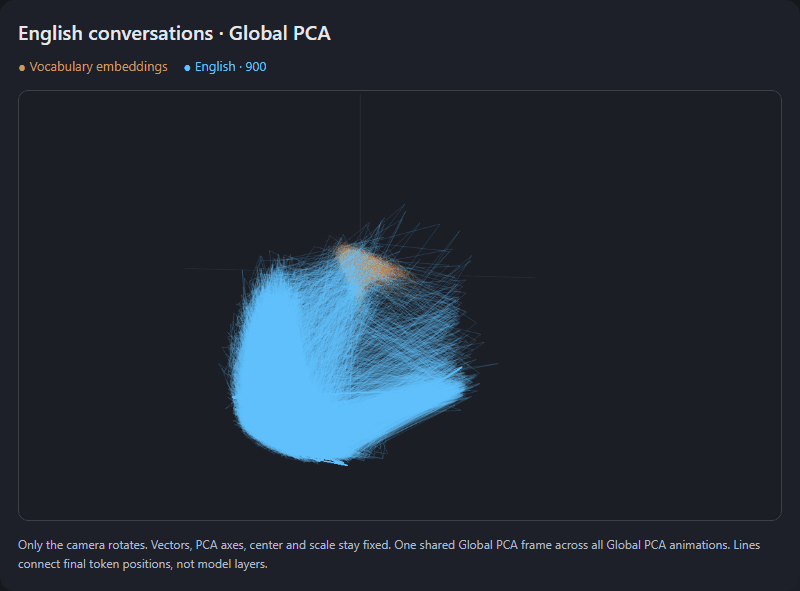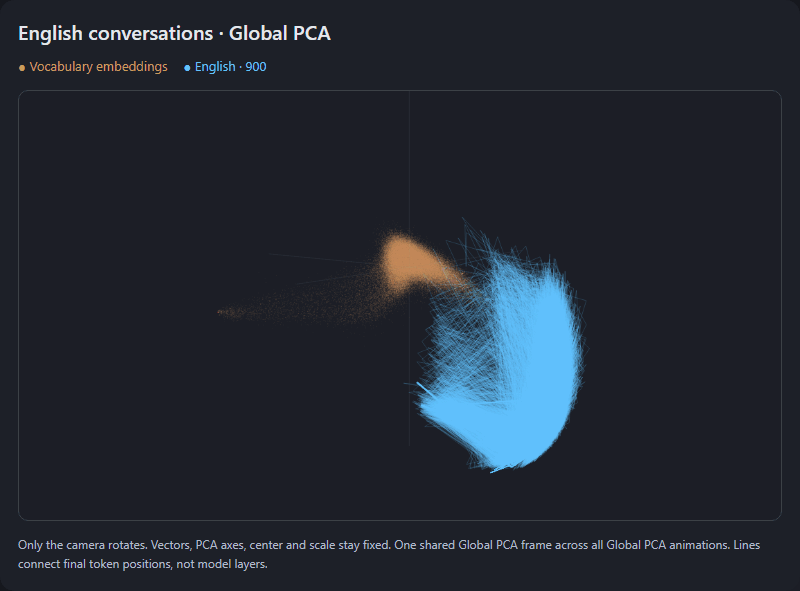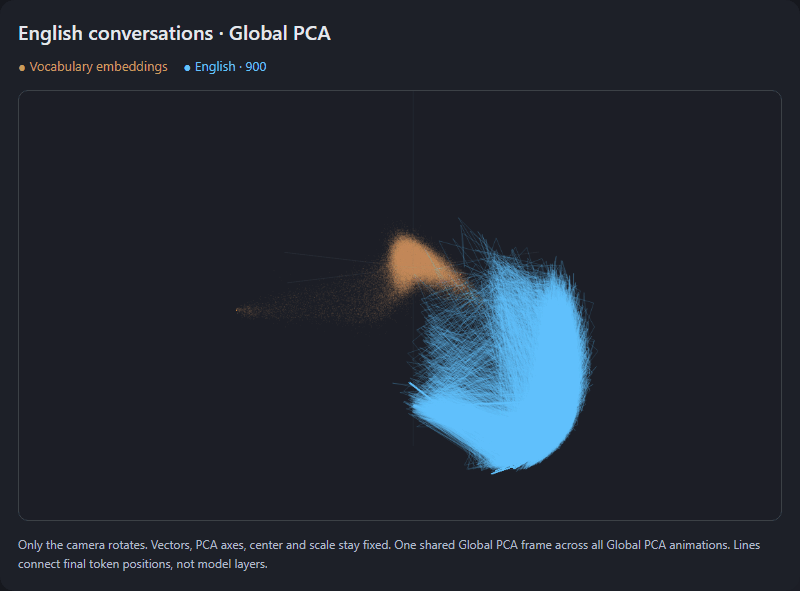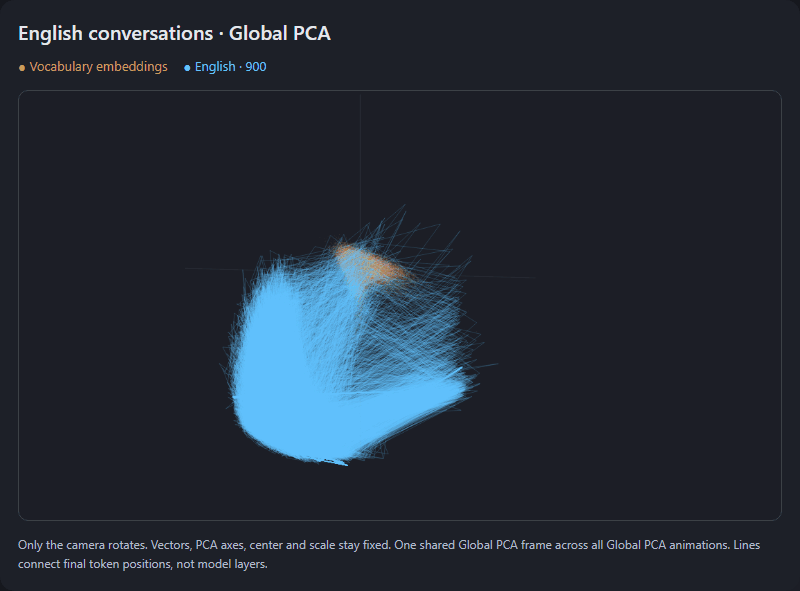
このアニメーションは、英語の会話状態が薄い幾何学的シートに高度に圧縮されているという発見を説明している。
共有ワークスペースとしての残差ストリーム
この研究は、言語モデルがテキストを処理する中心的な共有ワークスペースとして機能する「残差ストリーム」に焦点を当てています。単語、単語の一部、あるいは句読点である各トークンは、埋め込みテーブルからの学習済みベクトルとして始まり、周囲のコンテキストに基づいてモデルの層によって洗練されていきます。
これらの最終的なトークン状態を記録し、その長さを正規化することで、研究者たちは会話がモデルの内部表現を通じて辿る「経路」を可視化することができました。これらの経路は、モデルが初期の埋め込みをどのようにコンテキストを考慮した状態へと変換するかを明らかにしています。
「幾何学だけでは、それらの可能性を解きほぐすことはできなかった。」
— What thousands of conversations look like inside a language model
言語的幾何学と言語の分離
マッピングにより、異なる言語ごとに異なる空間的挙動が明らかになりました。英語の状態が薄いシートを形成する一方で、中国語の状態は隣接する領域に現れ、英語のクラスターから目に見えてオフセットされていました。これは、モデルの内部表現が、主題とそれを表現するために使用される特定の言語形態の両方の情報を保持していることを示唆しています。
ドイツ語とクロアチア語は英語と重なる広い近傍を占めており、これらのラテン文字言語の間で共有された幾何学的構造があることを示唆しています。しかし、研究者たちは、これらの領域の密度はデータの構築に影響されることに注意しました。例えば、クロアチア語の回答にはより多くのトークンが含まれていたため、より密な点のパッチが生じましたが、これは必ずしもモデルの容量が大きいことを示すものではありません。
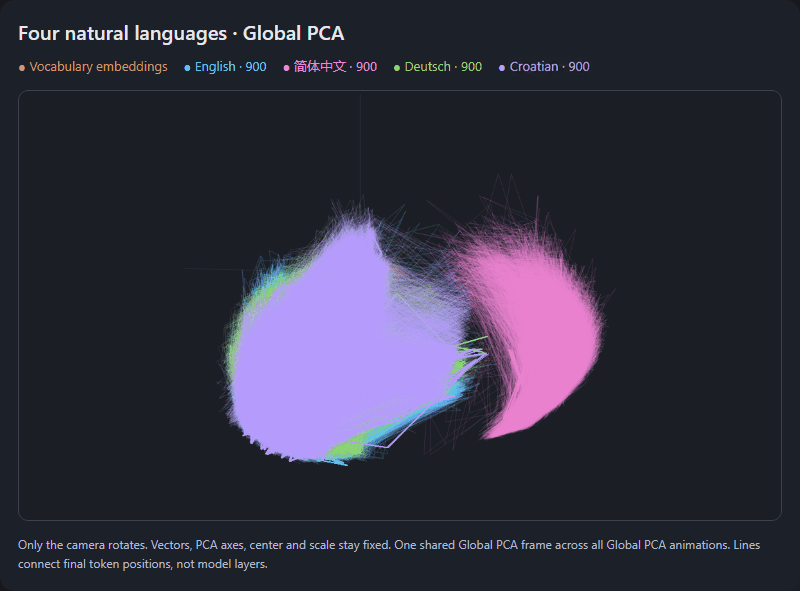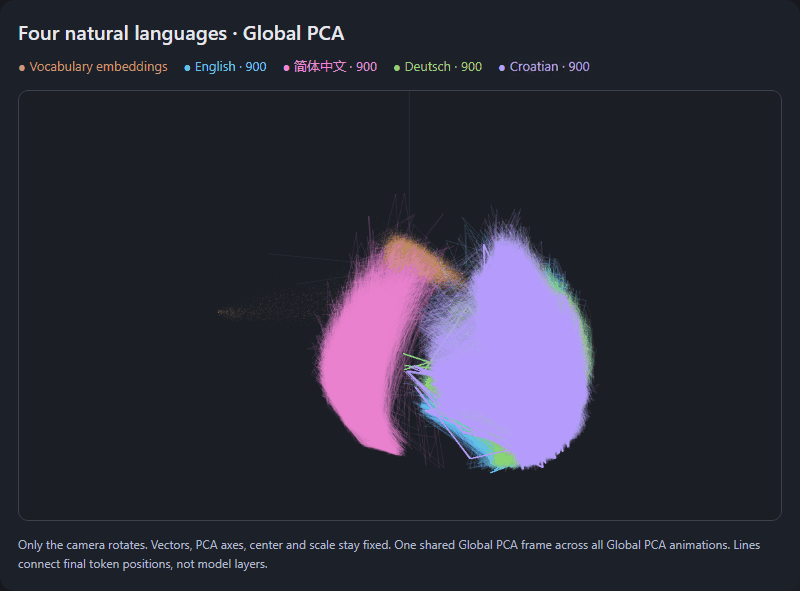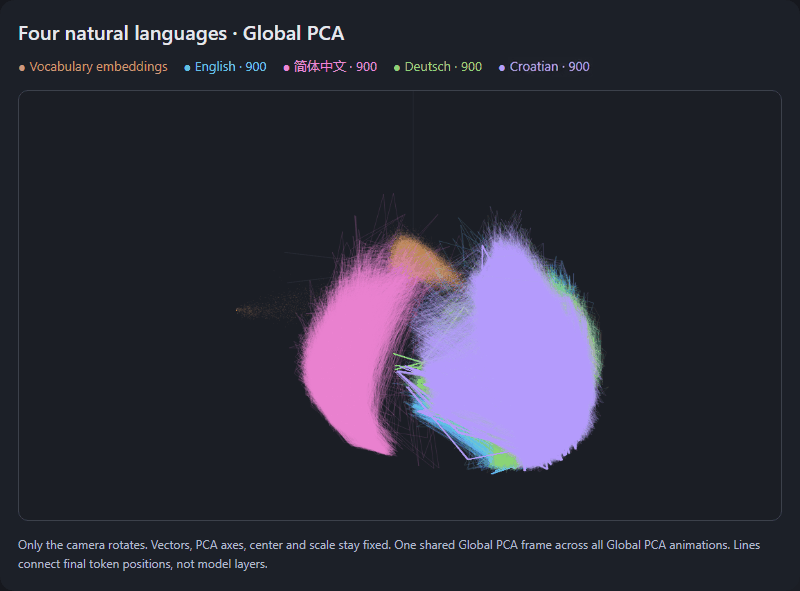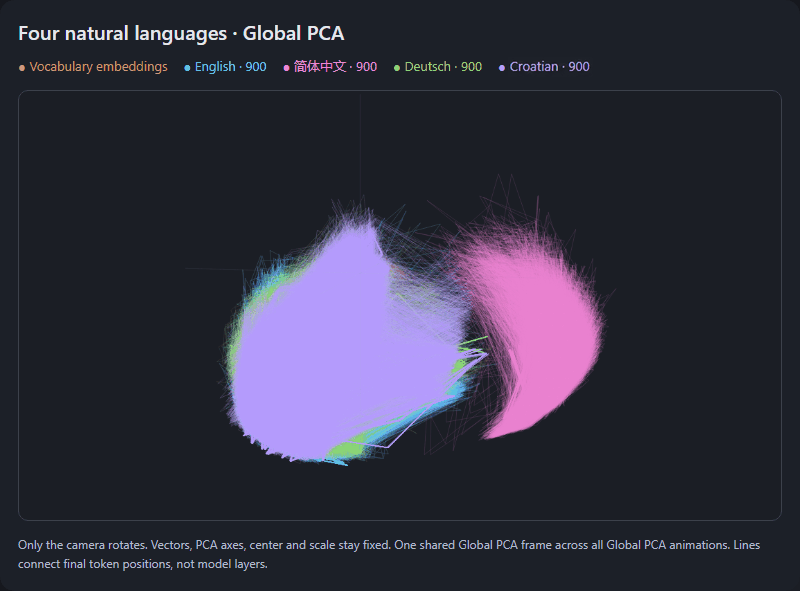
このアニメーションは、モデルの残差ストリームにおける異なる言語間の明確な空間的挙動と重なりを実証している。
コードと語彙志向のフレーム
Pythonのコーディング例が導入されると、それらは自然言語のデータセットと同じ広い近傍に現れました。興味深いことに、単純な距離比較では、コードと英語の両方が同様のキーワードや構造を共有しているにもかかわらず、コーディングデータセットは英語よりもドイツ語やクロアチア語に数値的に近いことが示されました。
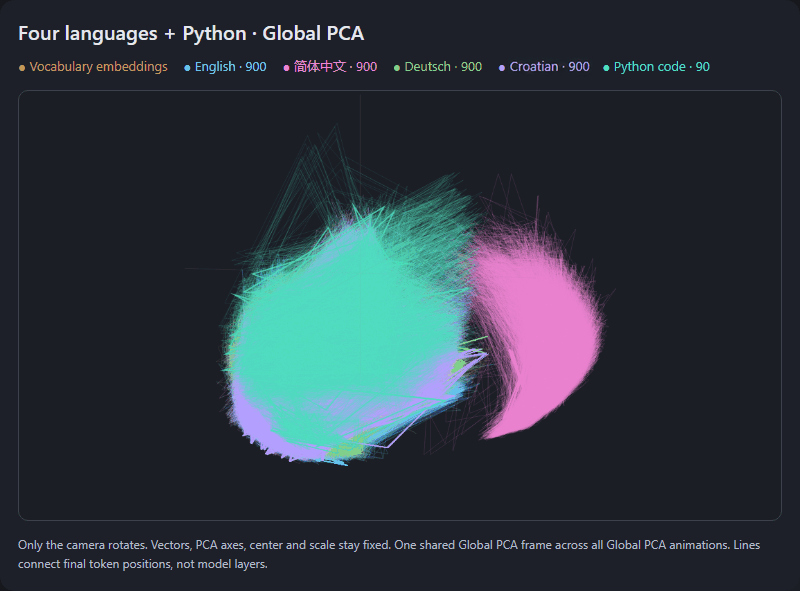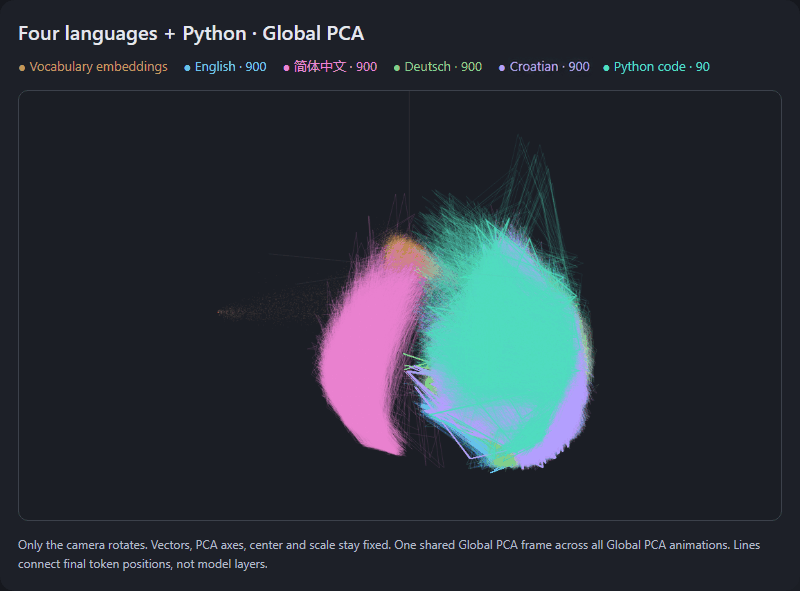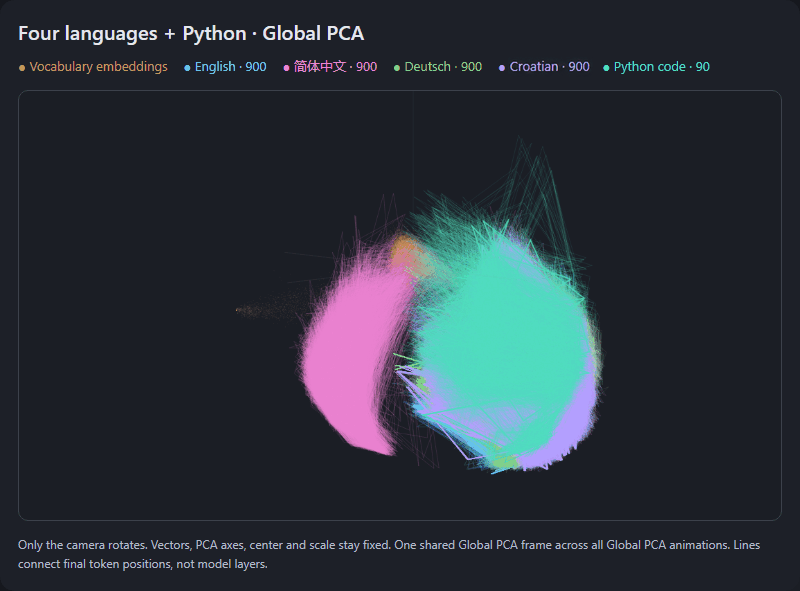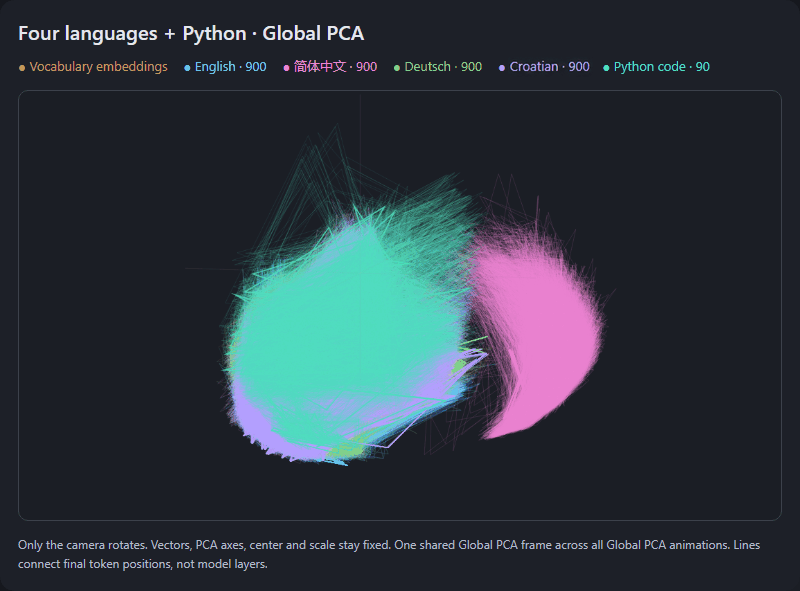
この視覚資料は、Pythonのコーディング例が自然言語データセットと同じ広い近傍に位置していることを説明するのに役立つ。
この研究ではまた、これらの内部状態の「マップ」が観察者の視点に高度に依存することも示されました。「会話PCA(Conversation PCA)」を使用すると(これは会話の平均間の変動に最適化される)、151,936の語彙埋め込みに強く影響される「グローバルPCA(Global PCA)」フレームよりも、ドイツ語とクロアチア語のより区別可能な領域が明らかになりました。
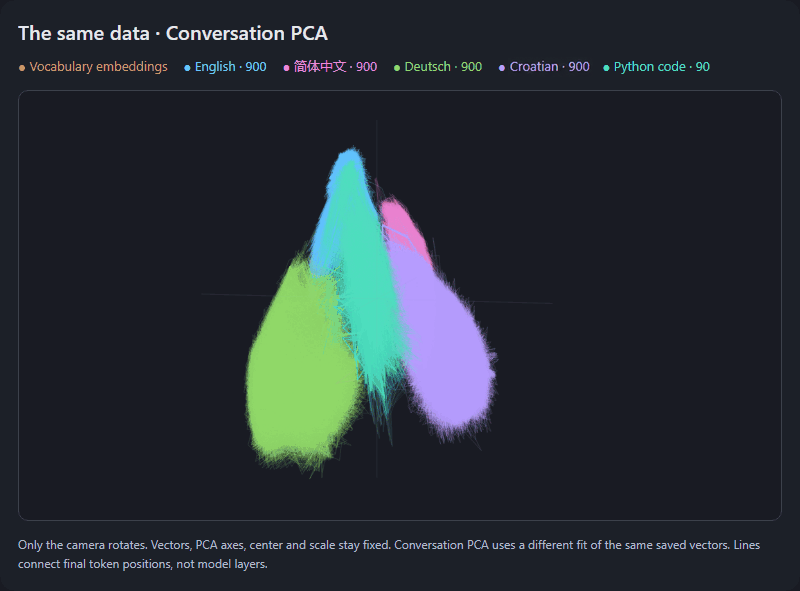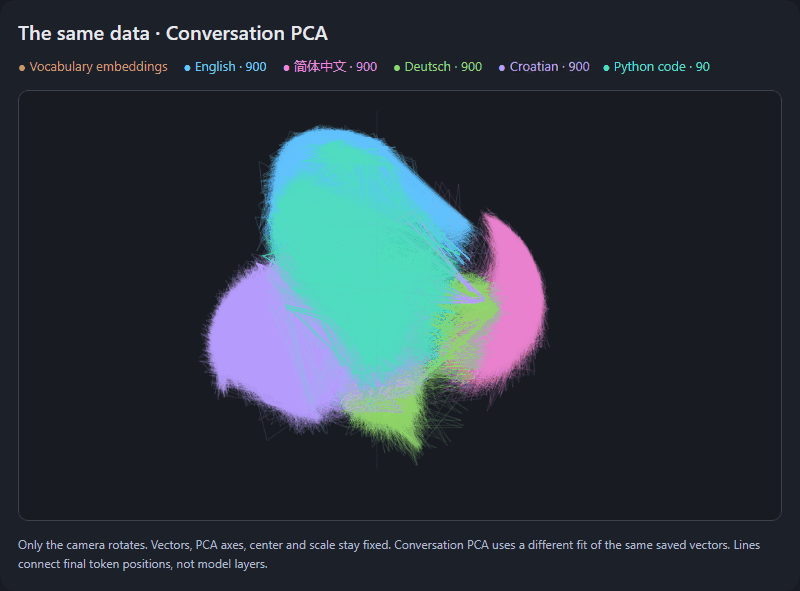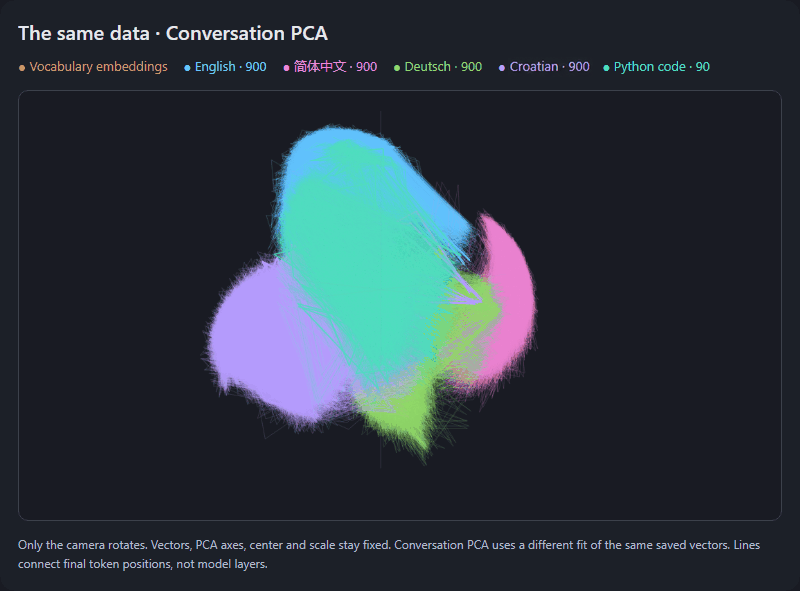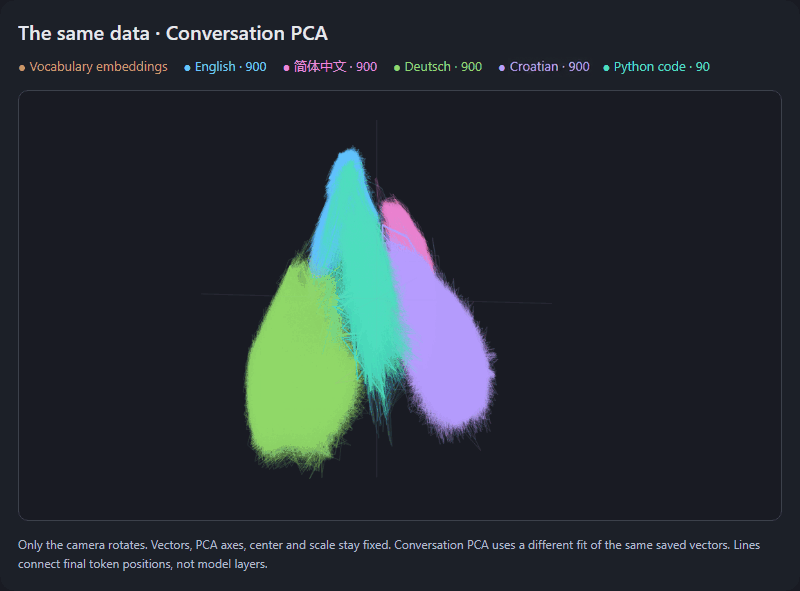
この可視化は、観察者の視点がConversation PCAにシフトしたときに、内部状態の「マップ」がどのように変化するかを実証している。
HN Digestによる図表(operator0x.comの報告数値に基づく)。数値はソースの通りに表示。
3D投影の限界
3Dの可視化はモデルの内部幾何学を明確に捉えるものですが、実際のデータの大部分を大幅に削減したものです。研究者たちは、3Dビューでは2,048次元のトークン状態の全変動のうちわずか17.6%しか捉えられていないことを発見しました。つまり、モデルの内部変動の82%以上は投影内では不可視のままです。
さらに、この研究では100のトピックと90のコーディング例という、意図的に構築された小さなサンプルを使用しました。これにより言語的幾何学を観察するための制御された環境は提供されましたが、人間のあらゆる知識や会話のタイプにわたるモデルの能力の広大な多様性を完全に捉えきれていない可能性があります。