DeepSeek、Moonshot AI、MiniMax、およびAnt Groupから公開されたAIモデルのフォレンジック分析により、NVIDIAのBlackwell GPUアーキテクチャと一致する数値パターンが明らかになった。これらの発見は、米国の輸出規制が高性能な計算リソースへの中国のアクセスを制限することを目的としている一方で、いくつかの主要な中国の開発者が、最新の最先端モデルのトレーニングにこれらのチップを統合することに成功したことを示唆している。
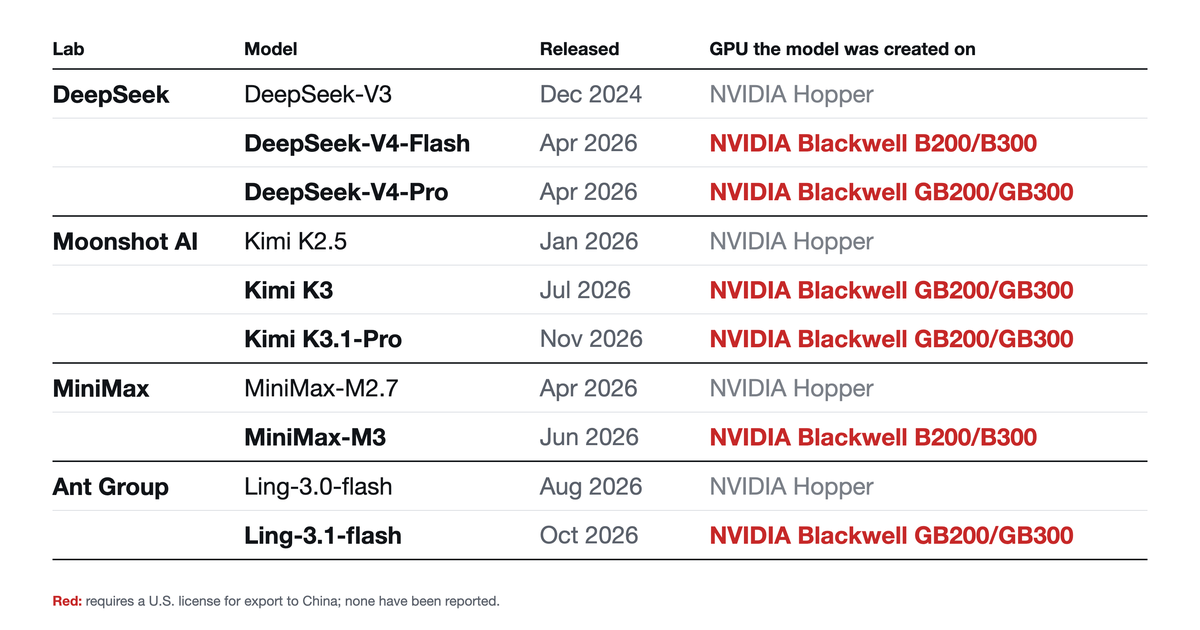
この画像は、フォレンジック分析で特定された特定のモデルと研究所の視覚的な要約を提供している。
ハードウェア指紋のメカニズム
証拠は、AIが情報を処理する方法を決定する数十億の数値であるモデルの「重み(weights)」から導き出されている。初期のトレーニングフェーズでは、これらの重みにはPhiloxと呼ばれる決定論的な擬似乱数生成(PRNG)アルゴリズムを使用して初期値が割り当てられる。
ソフトウェア(PyTorch)がこの作業をGPU上の並列スレッドに分割するため、特定の処理ユニット(ストリーミングマルチプロセッサ、またはSM)の数が、それらの数値がどのように分散されるかを決定する。異なるSM数を備えたチップは、同じ乱数を重み行列の異なる位置に配置する。
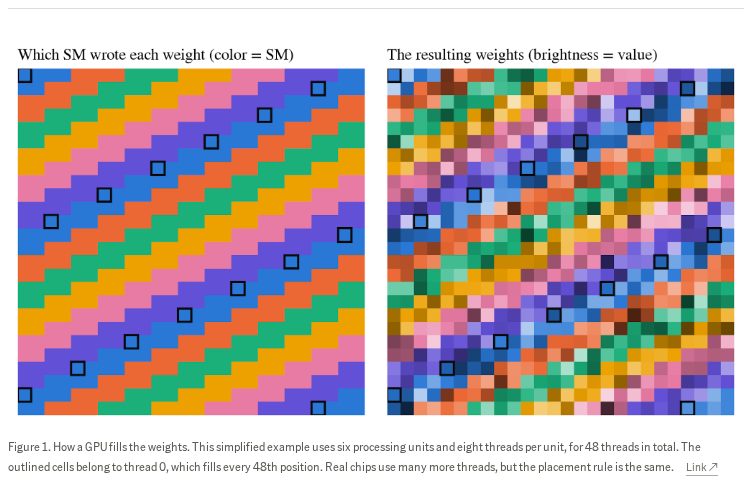
この図は、ハードウェア構成が重みの分布にどのように影響するかという基本的なメカニズムを説明している。
公開された重みを数千の潜在的な構成と比較することで、研究者は正確なハードウェアレイアウトを特定することができる。例えば、Blackwell B200/B300チップは148のSMを使用し、GB200/GB300チップは152のSMを使用する。問題となっているモデルは、高い統計的有意性をもってこれらの特定の数と一致した。
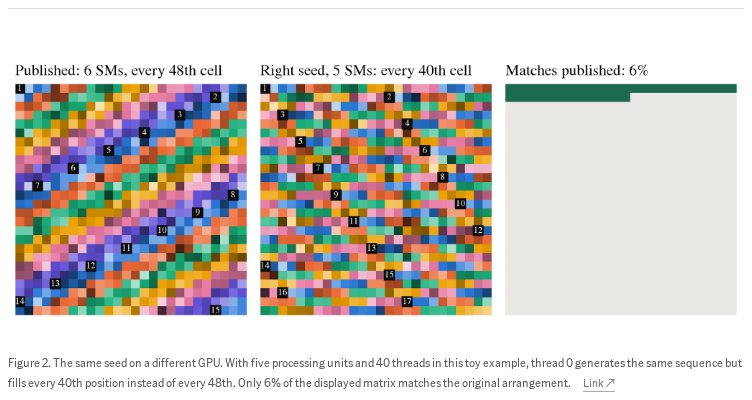
この視覚資料は、ハードウェアレイアウトの変更がいかに結果としての重み分布を変化させるかを示している。
「これらの発見は、いくつかの主要な中国のAI開発者が、最新モデルのトレーニングにBlackwellを使用し始めていることを示唆している。」
— Top Chinese Frontier AI Models Carry the Fingerprint of Export-Controlled NVIDIA Blackwell GPUs
ハードウェア移行のタイムライン
フォレンジックデータは、中国の研究所で使用されるハードウェアの明確な変化を明らかにしている。例えば、DeepSeekのV3モデル(2024年12月リリース)はHopper時代の指紋と一致するが、そのV4-FlashおよびV4-Proモデル(2026年4月リリース)はBlackwellアーキテクチャと一致する。
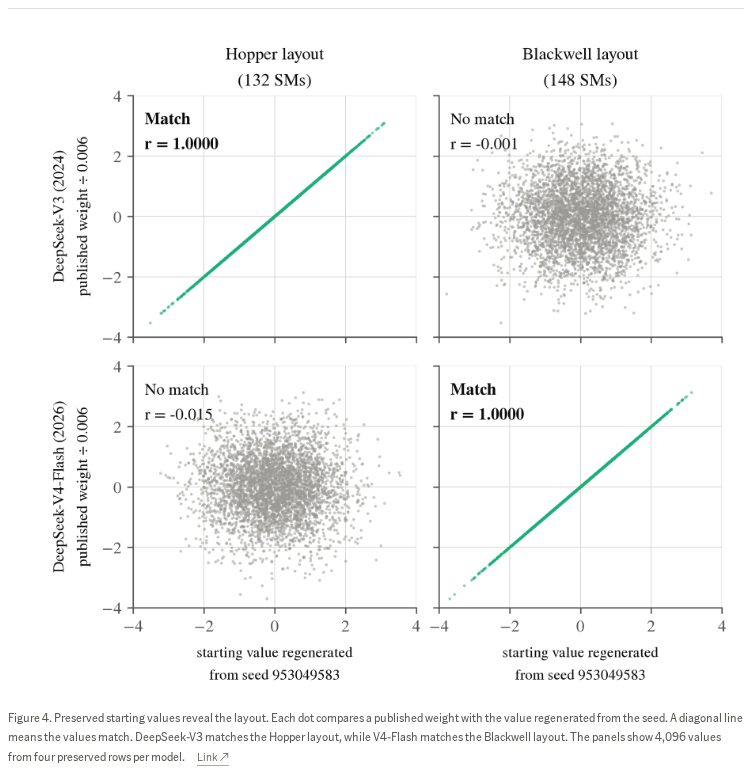
この画像は、研究で使用されたハードウェア指紋特定技術の主要な証拠を提供している。
Moonshot AIでも同様のパターンが観察され、モデルは2026年1月から2026年7月の間にHopperからBlackwellへと移行した。Ant Groupも、Ling-3.0-flashモデルでのHopperから、Ling-3.1-flashリリースでのBlackwellへの移行を示した。
HN Digestによる図(unemploymentlabs.comの報告数値に基づく)。数値はソースの表記通り。
注目すべきことに、すべての中国の研究所がこの移行を行ったわけではない。Alibaba、Zhipu、およびTencentのモデルは依然としてHopper時代の指紋を示しており、MeituanはNVIDIAのハードウェアシグネチャを全く示さない「AI ASICスーパーポッド」の使用を報告している。
規模と経済的影響
分析は、これらのトレーニング実行が大規模なデータセンター規模で行われたことを示唆している。モデルのサイズとトレーニングデータの量に基づくと、研究者は各実行に2〜3ヶ月の期間で500から3,000個のBlackwell GPUが必要であったと推定している。
GPU1個あたりの推定コストを70,000ドルとすると、これらのクラスターのうち最大のものでも、初期化に1億5,000万ドルから2億ドルの費用がかかることになる。特定された5つのBlackwellトレーニングモデルの総投資額は、初期のトレーニング実行費用を除いても、おそらく5億ドルを超えるだろう。
これらの発見はハードウェアへのアクセスの技術的な証拠を提供するものであるが、チップがどのように入手されたか、どこに位置していたか、あるいは特定の輸出法が違反されたかについては立証していない。
Hacker Newsの読者の反応
- 代替案: あるコメント投稿者は、政府が地政学的な安定を維持するため、あるいは市場を機能させながらコンプライアンスの戦略的な外見を作り出すために、特定の輸出を意図的に容認している可能性があると示唆した。 コメント ↗
- 懐疑的: 別のユーザーは、広大な転売者のグレーマーケットが存在するため、輸出規制は根本的に効果がないと主張し、同様の制限が他の制限地域への欧米製チップの流入を防ぐことに失敗してきたことを指摘した。 コメント ↗
- 技術的な指摘: あるコメント投稿者は、指紋特定方法の堅牢性について技術的な懐疑論を表明し、PyTorchの並列philoxベースのPRNGの特定の動作を検証する必要があると述べた。 コメント ↗
Hacker Newsのスレッドで出た意見の要約です。事実として検証されたものではありません。 議論の全文を読む ↗