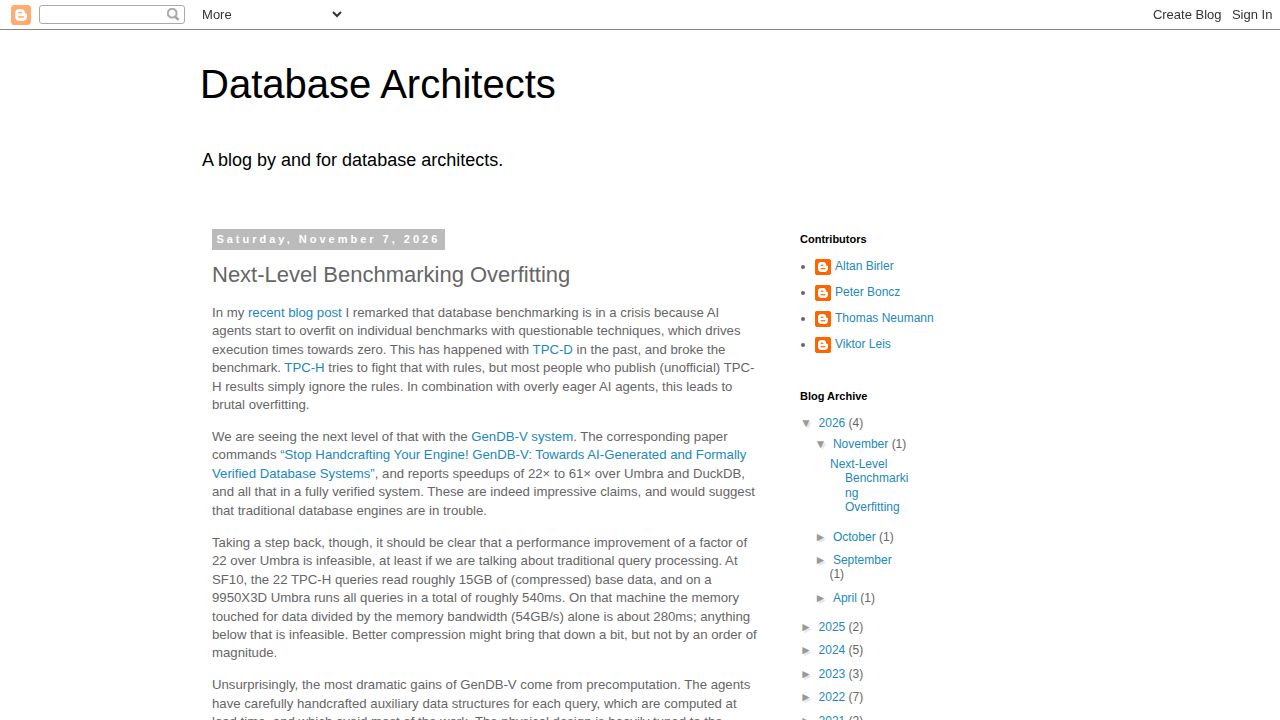
大規模言語モデル(LLM)をソフトウェア開発に統合することで、エンジニアは以前は手動で管理するにはコストがかかりすぎた複雑な「ホットパス」の特殊化を維持できるようになっています。これにより、特定のグラフ・コミュニティ・ベンチマークで記録的なスコアを出すことが可能になる一方で、システムが特定のテストに過度に調整されることで、より広い文脈においてパフォーマンスが予測不可能になる「ベンチマークの過学習」というリスクも生じています。
エージェントによる最適化の台頭
Thomas Neumann氏の投稿は、AIエージェントが特定のパターンに対するホットパスの特殊化を最適化するために使用されるという変化を強調しています。コメントのlmeyerov氏は、LLMによってこれらの複雑な特殊化を維持するコストが許容範囲内になり、特定のグラフ・コミュニティ・ベンチマークにおいて「超人的な」パフォーマンスが可能になると指摘しました。
このアプローチは、データフレーム用のオープンソースのベクトル化されたCPU/GPU CypherであるGFQLのようなツールを構築するために使用されています。目標は、ユーザーの主要なクエリに基づいてシステムが自らチューニングを行う、実行時およびロード時の特殊化へと移行することです。
ベンチマークの過学習の問題
この議論で提起されている主な懸念は、AIエージェントに特定のデータベース・ベンチマークに合わせて最適化を任せると、そのベンチマークが汎用的な有用性の不適切な測定基準になってしまうということです。コメントのperching_aix氏は、もしベンチマークがAIによって「操作」される可能性があるなら、それは時代遅れと見なされるか、あるいは重大な免責事項を付記すべきであると主張しました。
これにより、特定のテストに基づいて製品が市場のリーダーのように見える一方で、わずかに異なるデータアクセスパターンにおけるパフォーマンスが不明なままという状況が生じます。コメントの投稿者たちは、クエリのパフォーマンスは実行時のアクセスパターンに大きく依存するものであり、特定のプログラミングタスクに対して正しいデータ構造を選択するのと同様であると指摘しました。
トレードオフと「破綻させない」基準
この最適化トレンドにおける大きな技術的障壁は、リグレッション(退行)のリスクです。コメントのartrax氏は、あるクエリに対して10倍の改善を提供する最適化が、わずかに異なるクエリを100倍遅くする可能性があると指摘しました。
このため、信頼性の高いデータベース最適化の主な目標は、狭いテストケースのピークパフォーマンスを追い求めることではなく、クエリの99パーセンタイルにおいてシステムが「破綻」しないことを保証することであることが多いです。
議論は、これらの最適化には役割があるものの、顧客は最終的に欺瞞的な数値を無視することを学び、ソリューションが実際に自分たちの特定の課題を解決しているかに焦点を当てるべきであるという見解で締めくくられました。
AI駆動の厳密性における不確実性
AI駆動の最適化によって引き起こされる問題の優先順位付け(トリアージ)を誰が責任を持つべきかについて、継続的な議論があります。コメントのxyzzy_plugh氏は、厳密性の負担は最終段階のピアレビューではなく、ループ内の最初の人間が負うべきであると提案しました。
これらのシステムがデプロイされる前に、どの程度効果的に「過学習」を監査できるのか、あるいはパフォーマンスの向上が真のアーキテクチャの改善によるものなのか、それともテストスイートに対する狭い最適化によるものなのかは、依然として不透明なままです。
pull_quote
AIエージェントに特定のデータベース・ベンチマークに合わせて最適化をさせることは、そのベンチマークを無意味にします。それは良いことです!それは、そのベンチマークが常に操作や誤認の対象になりやすく、廃止または無視されるべきであり、少なくとも重大な免責事項を付記されるべきであることを意味します。
source_id": "perching_aix" (hn-50452496) (注:プロンプトはディスカッション・ダイジェストのhn-idをsource_idとすることを求めていますが、source_packetはコメントの著者名を使用しています。提供されたソーステキストに従い、著者名を識別子として使用します。)