Simon Fraser University (SFU)の研究者たちは、BlenderやUnreal Engineのような3Dグラフィックスツールと同様の精度で、写真内の照明を操作できる手法を開発しました。プロンプトに基づいて照明を推測する「ブラックボックス」型の生成AIモデルから脱却することで、このシステムはクリエイターがスポットライト、ポイントライト、または環境照明といった特定の光源をシーン内に直接配置し、調整することを可能にします。
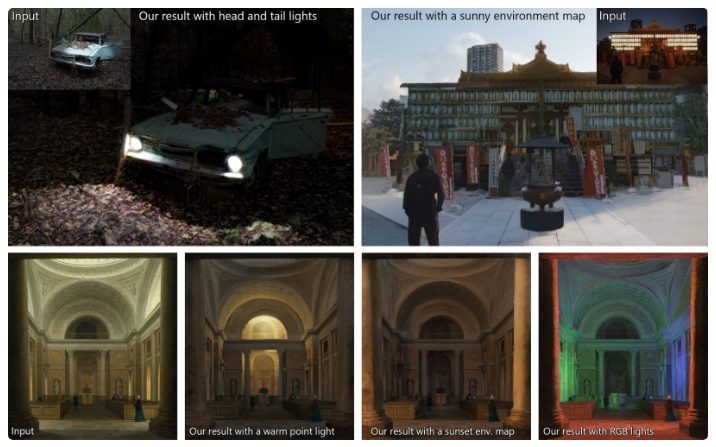
この画像は、物理的な正確さを維持しながら照明を操作するというシステムの核となる能力を説明しています。
生成AIの「ブラックボックス」を超えて
現在の生成AIツールは、光がシーンとどのように相互作用するかを予測するために大規模なニューラルネットワークに依存しているため、再照明において苦戦することがよくあります。これは、AIが元の写真の内容から逸脱する予測不可能な結果を招くことが多く、ユーザーはプロンプトエンジニアリングと試行錯誤のサイクルを強いられることになります。
SFUのアプローチは、この推測を明示的な物理制御に置き換えます。光の物理をシミュレートすることで、研究者たちは再照明の結果が、ユーザーの特定のクリエイティブなビジョンに対する物理的に正確な再現であることを保証します。
「照明をシミュレートすることで、私たちの結果がユーザーの望む照明の物理的に正確な再現であることを保証します。」
— CS Researchers Develop A New Tool That Brings Blender-like Lighting Control to Any Photograph
再構成とレンダリングのパイプライン
プロセスは、単一の写真からシーンのカラーメッシュ表現を推論することから始まります。この3Dモデルは、オブジェクトの形状と表面の色を捉えつつ、元の照明情報を意図的に取り除きます。
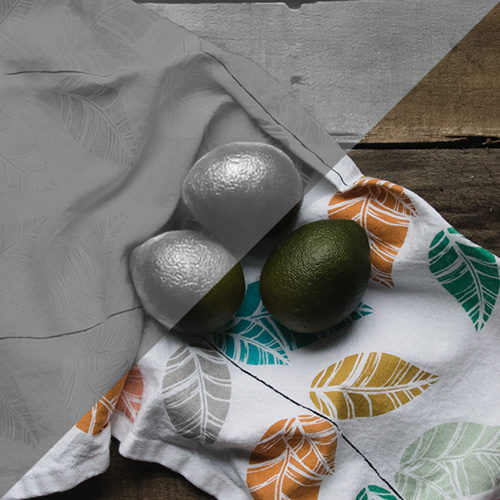
この視覚資料は、3Dモデルが確立される再構成フェーズの技術的な説明をサポートするものです。
3Dシーンが確立されると、ユーザーは仮想の光源を環境内に配置できます。次に、パス・トレーシングエンジンがこれらの光をシミュレートしてシーンの粗いプレビューを作成します。最後に、フィードフォワード・ニューラルレンダラーがその粗いプレビューをフォトリアルな写真へと変換し、物理的な正確さと高忠実な外観を融合させます。
学習と将来の応用
システムが多様な実世界の画像で機能するように、チームは自己教師あり学習手法を開発しました。これは微分可能レンダリングを使用してシーンの照明を再構成するもので、手動でラベル付けされたデータが必要なく、生の画像コレクションでニューラルレンダラーをトレーニングすることを可能にします。
このツールは現在は静止画像に限定されていますが、研究者たちはビデオへの拡張を意図しています。これにより、シーンの撮影後に照明を調整できるようになるため、高価な照明機材や何度も撮影し直す必要がなくなり、独立系映画制作者やコンテンツクリエイターのコストを大幅に削減できる可能性があります。