LeWM(Latent World Model)を用いた600件の実験により、長期間のタスクにおけるJEPA世界モデルの成功は、物理を予測する能力よりも計画アーキテクチャによって制限されていることが明らかになった。バニラ(標準)の状態では、モデルは75ステップのタスクを22%の成功率でしか解決できなかったが、研究者たちはこれらのタスクを25ステップの小さなセグメントに分割することで、基礎となるモデルを再学習することなく成功率を80%まで高められることを発見した。
JEPAアーキテクチャと予測のギャップ
Joint-Embedding Predictive Architecture(JEPA)は、視覚的な観察を埋め込みと呼ばれるコンパクトなベクトルに変換することで動作する。将来のフレームのすべてのピクセルを予測しようとする生成モデルとは異なり、JEPAはエンコーダを使用して関連する特徴を抽出し、予測器を使用してアクションに基づいて次の埋め込みを予測し、プランナーを使用して潜在的なアクションシーケンスを評価する。
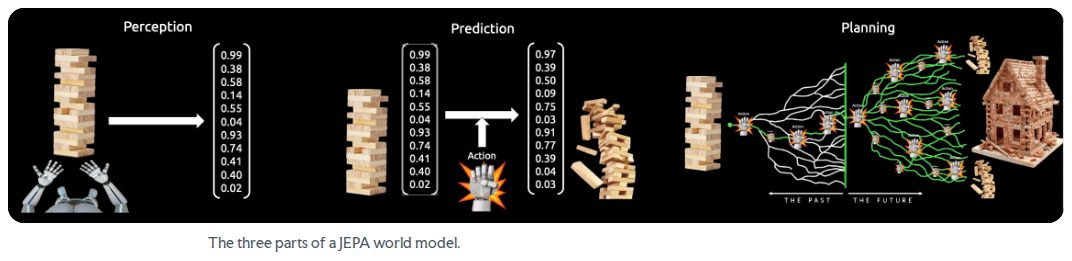
この図は、エンコーダ、予測器、プランナーを使用するJEPAモデルの基本的なアーキテクチャを説明している。
Push-Tベンチマーク(ロボットがT字型のブロックをターゲットまで移動させるタスク)でLeWMモデルをテストした際、研究者たちは、25ステップの短い期間においてはモデルの予測がほぼ完璧な物理に近い精度であることを発見した。これは、長期間のタスクにおける主なボトルネックが世界モデル自体の不正確さではなく、プランナーが75ステップにわたって累積する誤差をどのように処理するかにあることを示唆している。
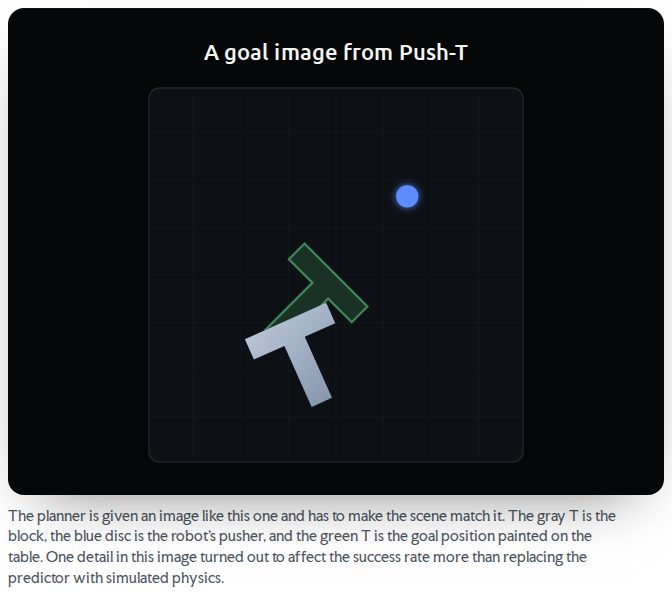
この画像は、モデルの計画および予測能力を評価するために使用されるPush-Tベンチマークを例示している。
HN Digestによる図(haddyalchaer.comの報告数値に基づく)。数値はソースの表記通り。
「LeWMの有用な計画範囲は約25ステップであるため、さらに先へ進むための方法は、その長さのセグメントを連結させることであることが明らかになった。」
— After 600 experiments, here's what I discovered about JEPA world models
階層的計画とメモリグラフ
重要な改善の一つは階層的計画である。75ステップの目標を3つの25ステップのセグメントに分割することで、モデルは次の状態を正常に予測できる「正確性のゾーン」内に留まることができる。この手法は、バニラモデルを58パーセンテージポイント上回り、完璧な専門家サブゴールを与えられたプランナーの性能にほぼ匹敵した。
別の手法では、過去の専門家デモンストレーションの460,000個の埋め込み状態から構築された潜在メモリグラフを利用する。これらの状態を地図として扱い、異なるデモンストレーション間の「ジャンプ」にコストを加えることで、プランナーは過去の成功した行動のセグメントを連結させることで目標に向かってナビゲートできる。このアプローチは、長期間のタスクにおいて85%の成功率を達成した。
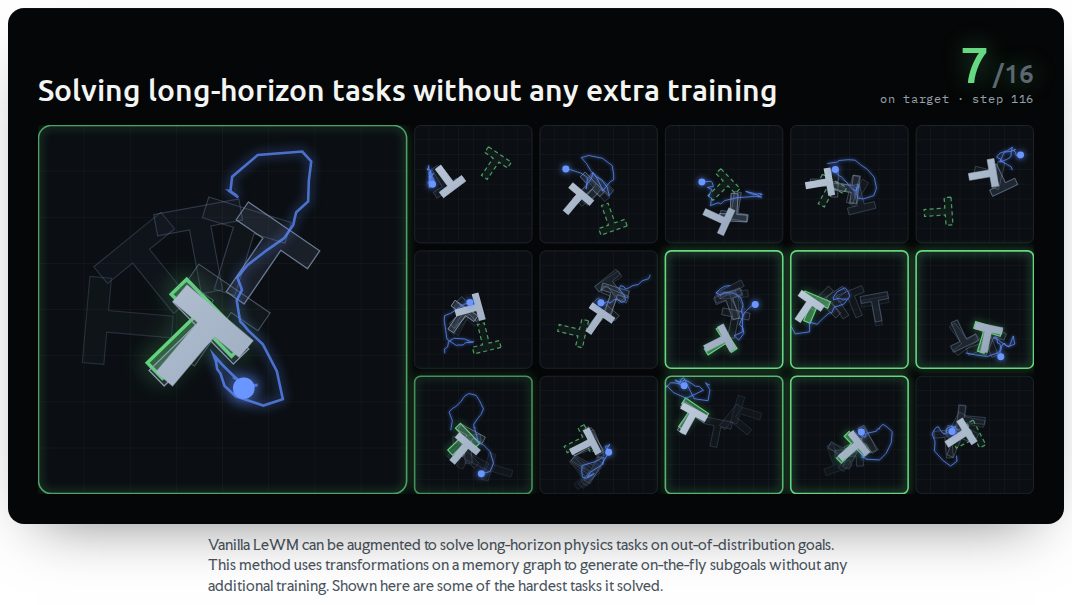
この視覚資料は、過去の行動を連結させることで目標に向かってナビゲートするための潜在メモリグラフを使用する方法を実演している。
目標スコアリングの洗練と限界
研究では、目標のスコアリング方法における欠陥も浮き彫りになった。目標画像にはロボットの腕が含まれているため、プランナーはブロックの位置に集中するのではなく、腕の位置を完璧に再現しようとして失敗することが多かった。スコアリングを調整して腕を無視するようにすることで、特定のタスクにおける成功率は30ポイント向上した。
これらの進歩にもかかわらず、大きな課題が残っている。それは、完璧な専門家デモンストレーションがないタスクへの汎用性である。メモリグラフや変換(過去のデータの回転や反転など)はギャップを埋めるのに役立つが、目標がデモンストレーションで一度も捉えられたことのない状態を経由する必要がある場合、モデルは依然として苦戦する。