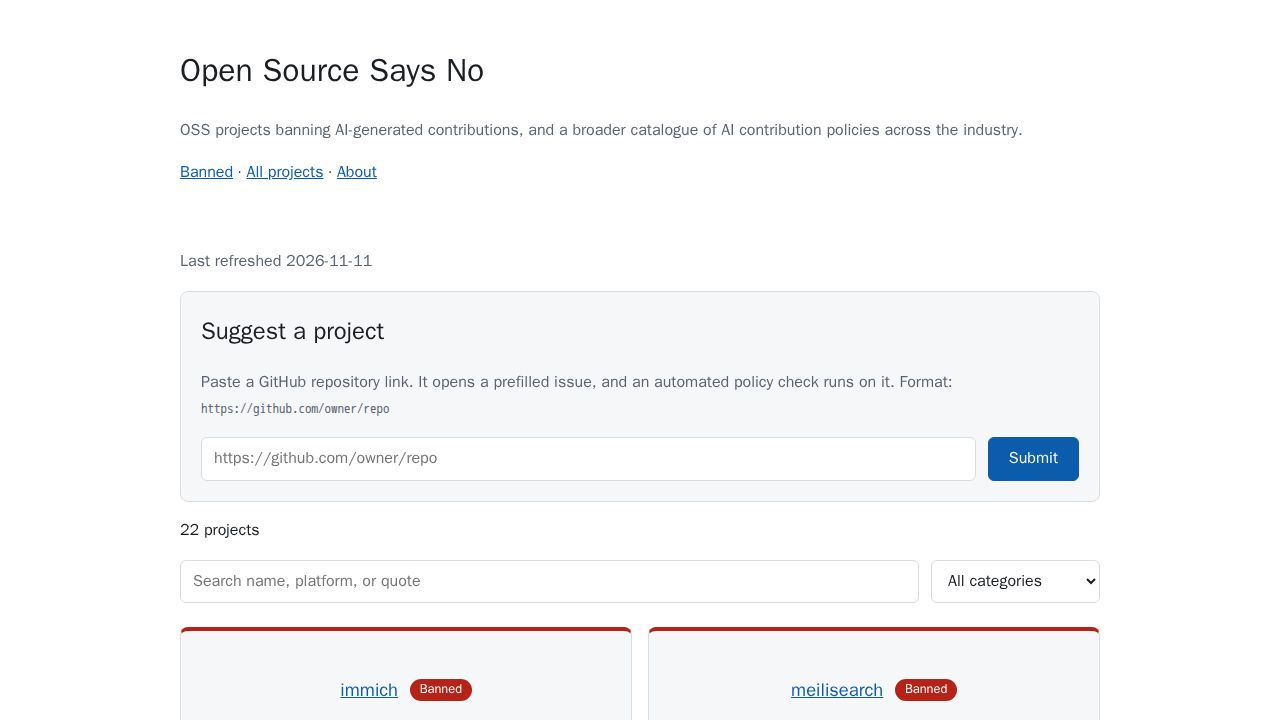
オープンソースプロジェクトにおいて、コードベースの完全性と保守性を守るために、人工知能によって生成されたコントリビューションを明示的に禁止するプロジェクトが増えています。この変化は、「バイブ・コーディング」による提出物の急増によって引き起こされています。これは、一見すると機能し、見た目も正しいように見えるものの、プロダクションソフトウェアに不可欠な厳格なテスト、セキュリティ監査、および深いアーキテクチャの理解を欠いているコードのことです。
「バイブ・コーディング」によるゴミの台頭
プロジェクト「osssaysno.com」は、メンテナが大規模言語モデル(LLM)によって生成されたと思われるコントリビューションを拒否している傾向を浮き彫りにしています。あるコメント投稿者(koalalorenzo)は、これらを「バイブ・コーディング」されたプロジェクトと表現しました。そこでは「見た目」や「感触」に焦点が当てられ、セキュリティの問題は「LLMは常に正しい」という理由で放置されていると述べています。
別の視点では、問題はAI自体ではなく、人間の責任の欠如にあると示唆されています。Hacker Newsのコメント投稿者たちは、真の問題は、人間が書いたかAIが書いたかに関わらず、コントリビューターが提出するコードを読み、テストし、理解することに対する責任を負わなくなったことにあると主張しました。
メンテナの精神的健康を守る
メンテナは、イシューやプルリクエストを含むコミュニティとのやり取りの件数が大幅に増加しており、プロジェクトを管理する人々の燃え尽き症候群のリスクに直面しています。あるコメント投稿者(Arbortheus)は、問題の難しさは、問題領域を理解しているコントリビューターと、「LLMに誘発されたダッチ・カレッジ」を持つコントリビューターを区別することにあると指摘しました。
AI生成のコントリビューションを禁止することで、メンテナは「価値の付加」に対する高い基準を設けようとしています。あるコメント投稿者(Systemerror7A69)は、かつては機能するソリューションがコントリビューターの思考プロセスの証拠であったのに対し、LLMを用いることでその思考が外部委託されることが多くなり、メンテナが高品質な入力を識別することが難しくなっていると主張しました。
取引条件と強制の課題
AIを禁止する動きには論争も伴います。一部のコメント投稿者は、これらの禁止措置は「怠慢」であり、特に資金不足のコミュニティ主導のプロジェクトにおいて潜在的なコントリビューターを遠ざけてしまう可能性があると主張しました。彼らは、使用されたツールよりも、コントリビューションの品質自体に焦点を当てるべきだと提案しました。
また、強制に関する実用的な懸念もあります。あるコメント投稿者(ChrisRR)は、AIコードを禁止すると、コントリビューターが使用状況について嘘をつく可能性があると示唆しました。彼らは、AIを使用することは許可するが、人間のコントリビューターが最終的な出力に対して完全な責任を負わなければならないという中間案を提案しました。
さらに、バグ探しにおいてAIを避けることは、ソフトウェアをより脆弱にする可能性があるという主張もあります。あるコメント投稿者(jonathanstrange)は、攻撃者が脆弱性を見つけるためにAIを使用する以上、人間のみによるコードは最終的に安全性が低いと見なされる可能性があると警告しました。
AI統合におけるニュアンス
すべてのプロジェクトが一律の禁止を採用しているわけではありません。一部のメンテナは、ボットや非専門家がコードを提出する「外部」のAIコントリビューションと、「人間が誘導するエージェンティック・コーディング」を区別しています。あるコメント投稿者(jdzikowski)は、プロジェクトのアーキテクチャを深く理解している人物によって承認されたものであれば、プロジェクトはAIコードをより信頼する可能性があると指摘しました。
この議論では、いくつかのプロジェクトが中間的な道を見出していることも明らかになりました。例えば、あるコメント投稿者は、プロジェクトがLLM生成のプルリクエストを受け入れない一方で、共同執筆されたコミットや特定のタスクのために内部的にAIエージェントを使用する可能性があることを指摘しました。