Claude Fable 5.2 (Max)は、Artificial Analysis Intelligence Indexで65点を獲得し、同クラスのモデルの中央値である40を大きく上回りました。これは高い知能レベルを示していますが、モデルのパフォーマンスには効率面での顕著なトレードオフがあり、類似モデルの中央値である12.9分に対し、単一のIntelligence Indexタスクの完了に45.0分を要しています。
知能とパフォーマンスの指標
Claude Fable 5.2 (Max)モデルは、知識労働、コーディング、科学、一般知識を含む一連の評価において高い知能を示しています。このモデルは、AA-Briefcase v1.1やFrontierCode 2.0など、9つの異なる評価を組み込んだArtificial Analysis Intelligence Indexで65点を獲得しました。
高い知能スコアにもかかわらず、モデルのパフォーマンスは大幅なレイテンシによって妨げられています。最初の回答トークンまでの時間は171.16秒を記録し、出力速度は毎秒101トークンであり、これが全体的なタスク完了時間の遅さにつながっています。
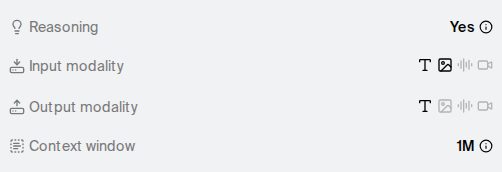
このスクリーンショットは、パフォーマンス指標セクションで言及されているトークン速度や知能スコアなどの具体的な技術データを提供します。
「Claude Fable 5.2 (Max, Default Fallback)はArtificial Analysis Intelligence Indexで65点を獲得し、同等のモデル(中央値:40)の中で平均を大きく上回っている。」
— Claude Fable 5.2 (max) - Intelligence, Performance & Price Analysis | Artificial Analysis
コストと冗長性のトレードオフ
このモデルの運用コストは、同クラスの業界平均よりも大幅に高くなっています。入力トークン100万件あたり8.00ドル、出力トークン100万件あたり40.00ドルかかり、Intelligence Indexタスクあたり平均26.54ドルのコストが発生します。
HN Digestによる図表(artificialanalysis.aiの報告数値に基づく)。数値はソースの表記通り。
これらのコストの主な要因は、モデルの極端な冗長性です。Intelligence Indexの評価中、このモデルは2億7500万の出力トークンを生成しました。これは、同等のモデルが使用する中央値の7280万トークンの約4倍に相当します。
モデルのバリエーションと制限
Claude Fable 5.2のリリースには、異なるニーズに合わせて調整された5つの異なるモデルが含まれています。例えば、「Low」バリエーションは、タスクあたり6.5分という最高の速度と、タスクあたり3.10ドルという最低のコストを提供しており、このリリース内での幅広いパフォーマンス特性を物語っています。
Maxバリエーションは最高の知能を提供しますが、同等のモデルと比較してなぜこれほど冗長で完了時間が遅いのかという具体的な理由は、現在の分析では明らかにされていません。さらに、「Low」バリエーション以外の、リリースに含まれる他の3つのモデルの具体的な名称や指標は、現時点では詳細に記載されていません。
Hacker Newsの読者の反応
- 代替案: あるコメント投稿者は、出力トークンの大幅な増加により、モデルのタスクあたりのコストが前モデルの2倍になったと指摘した。 コメント ↗
- 懐疑的: 別のユーザーは、モデルのパフォーマンスがベンチマークへの早期アクセスに影響されている可能性を示唆し、公開リリースまでに実行が完了していなかった可能性があると述べた。 コメント ↗
- 体験談: あるコメント投稿者は、「Max」バージョンは収穫逓減の領域にある可能性があり、パフォーマンスのすべてが厳格に必要とされる場合にのみ使用すべきだと主張した。 コメント ↗
Hacker Newsのスレッドで出た意見の要約です。事実として検証されたものではありません。 議論の全文を読む ↗