Anthropicは、ソフトウェアの移行、ロボット工学の評価、複雑な数学的証明など、手強い技術的課題に対処するために特別に設計されたモデル、Claude Fable 5.2およびClaude Mythos 5.2をリリースしました。リリース前のテストにおいて、これらのモデルはフェルマーの最終定理の証明をわずか30時間で形式化する能力を示しました。これは、以前のClaudeの研究版では完了するのに11日を要したタスクです。
アーキテクチャと安全性のプロファイル
Claude Fable 5.2とClaude Mythos 5.2は同じ基礎モデルアーキテクチャを共有していますが、安全性のガードレールが異なります。Fable 5.2には、悪用を防ぐための強力なサイバーセキュリティおよびバイオロジーの保護策が含まれており、一般公開されています。
対照的に、Mythos 5.2はサイバーセキュリティおよび生物医学研究における特殊なアプリケーション向けに設計されています。Mythosへのアクセスは、Anthropicのライフサイエンスおよびサイバー検証プログラムを通じて申請する組織に限定されています。
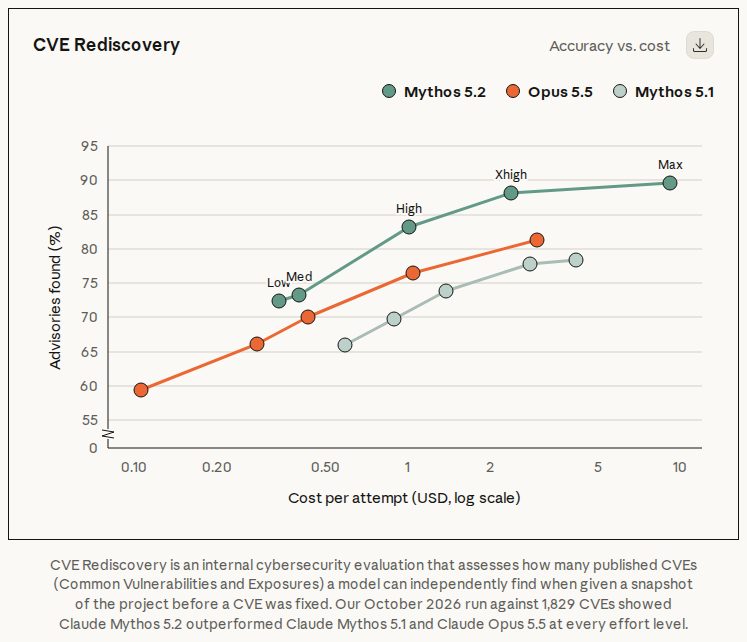
この画像は、記事で言及されているサイバーセキュリティ能力と脆弱性特定に関する視覚的な証拠を提供します。
「Claude Fable 5.2は、103のデータエンジニアリングタスクからなる当社のオープンソースベンチマークであるdata-eng-benchにおいて、測定した中で最も強力なモデルです。」
— Introducing Claude Fable 5.2 and Claude Mythos 5.2
パフォーマンスと効率の向上
5.2のアップデートは効率において大きな飛躍をもたらし、5.1バージョンと比較して出力速度を30%向上させました。Anthropicはまた、オプションの「高速モード」を導入しました。これは、入力トークンあたり16ドル、出力トークンあたり80ドルの高価格設定で、トークン生成を最大2.5倍加速させることができます。
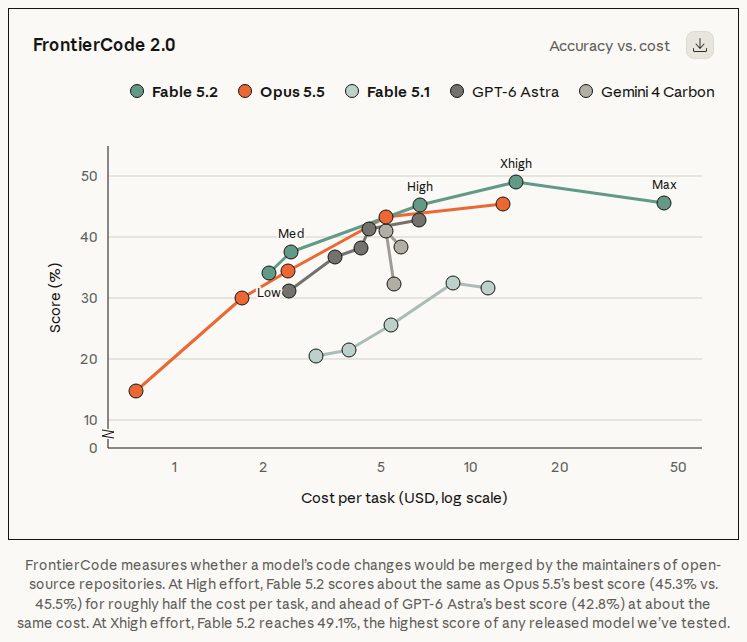
このチャートは、5.2アップデートの効率向上とコスト対パフォーマンスの比率に関する議論を裏付けています。
HN Digestによる図表(anthropic.comの報告数値に基づく)。数値はソースの表記通り。
ベンチマークデータは、Fable 5.2がいくつかのカテゴリーでOpus 5.5を上回っていることを示しています。例えば、ハードウェアエンジニアリング(BenchCAD 2.1)において、Fable 5.2はMax effortで83.5を記録し、Opus 5.5のスコアである65.3を大幅に上回りました。
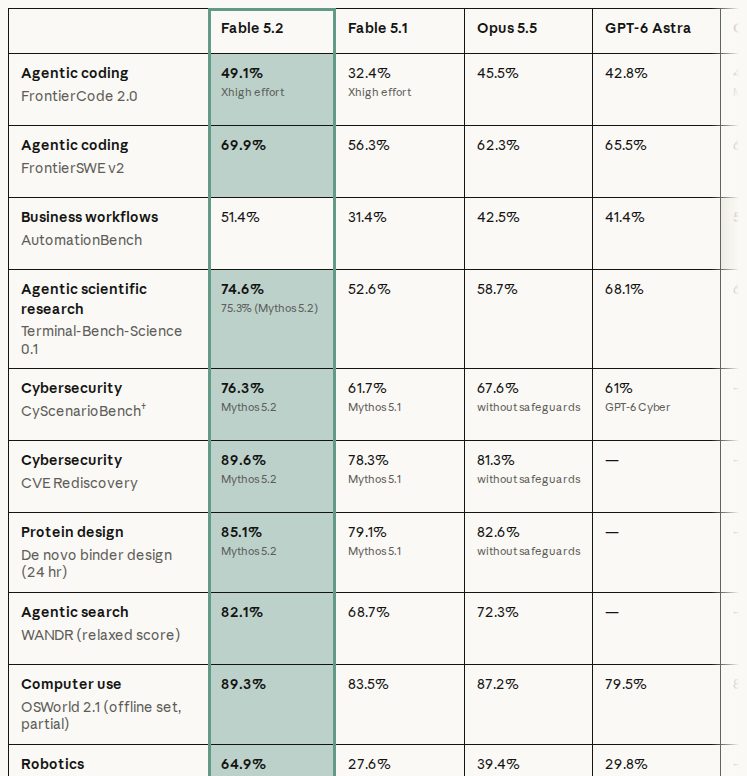
この図は、本文で言及されているパフォーマンスの向上とベンチマークスコアを視覚化しています。
技術的能力とユースケース
Anthropicは、これらのモデルが「野心的でオープンな技術的作業」を処理できる能力を強調しています。ある実験では、Fable 5.2が8日間にわたり1,000以上のサブエージェントを調整し、ドライバーとログイン画面を備え、ノートパソコン上で起動する動作可能なオペレーティングシステムを生成しました。
企業ユーザーにとって、これらのモデルは複雑なSQL生成やソフトウェアエンジニアリングに優れています。あるユーザーは、Fable 5.2が国レベルの債務概要を正しく計算した一方で、他のモデルは予想量の5〜8倍の誤差を生成したと報告しました。さらに、このモデルはプロダクションサービスのPythonからRustへの移行に使用され、結果として26倍高速に起動するサービスを実現しました。
モデルの階層と制限
Anthropicはユーザーに対して階層的なアプローチを推奨しており、ほとんどのコーディングや知識タスクについてはClaude Opus 5.5を主要な「デイリードライバー」として使用することを提案しています。ユーザーは、作業の範囲と複雑さが標準モデルの能力を超える場合にのみ、FableまたはMythosにスケールアップすべきです。
Fable 5.2は「Xhigh effort」レベルで高いパフォーマンスを示しますが、それは小型モデルと併用することを意図しています。それは、小型モデルがより困難な問題を解決するのを助けるアドバイザーとして、あるいは単純なタスクを委任するオーケストレーターとして機能し、コストと能力のバランスを最適化します。
引用
"Claude Fable 5.2は、103のデータエンジニアリングタスクからなる当社のオープンソースベンチマークであるdata-eng-benchにおいて、測定した中で最も強力なモデルです。" (主要)
Hacker Newsの読者の反応
- 体験談: 材料科学の仕事にこのモデルを使用したあるコメント投稿者は、大規模で難解なFortranコードベースをうまくナビゲートし、計算タスクにおいて36倍の高速化を達成したと報告しました。 コメント ↗
- 体験談: モデルのゲーム能力をテストしたあるユーザーは、グラフィックスは大幅には改善されなかったものの、モデルはゲームデザインにさらなる機能的な深みと論理的一貫性を加えたと指摘しました。 コメント ↗
- 懐疑的: あるコメント投稿者はモデルの費用対効果に疑問を投げかけ、タスクあたりの価格が競合モデルよりも大幅に高く、パフォーマンスの差を正当化できない可能性があると主張しました。 コメント ↗
- 懐疑的: 数人のコメント投稿者がベンチマークの透明性について疑問を呈し、特に努力と知能の曲線の背後にある論理や、比較のために選ばれた特定のモデルについて疑問を投げかけました。 コメント ↗
Hacker Newsのスレッドで出た意見の要約です。事実として検証されたものではありません。 議論の全文を読む ↗