生成AIモデルは、英語と比較して非英語の言語でテキストを生成する際に、1.4倍から180倍のエネルギーを消費することがあります。この格差は、ラテン文字を使用しないヒンディー語やベンガル語などの言語で最も顕著であり、これらは同等のプロンプトを処理するのにそれぞれ7.9倍および15.3倍のエネルギーを必要とします。この知見は、現在の大規模言語モデル(LLM)のアーキテクチャが、数十億人の非英語話者に対して重大なエネルギーおよびコストの障壁を生み出していることを示唆しています。

このチャートは研究の核心的な知見を視覚化しています。非英語の言語、特に複雑な文字体系を持つ言語におけるエネルギー消費の大幅な増加です。
トークン消費のメカニズム
このエネルギー格差の主な要因は、AIモデルがテキストを「トークン」——モデルによって使用されるデータの基本単位——に処理する方法にあります。デバナガリ文字(ヒンディー語、ネパール語、マラーティー語で使用)やベンガル語のような文字体系では、主要な文字が形状を変え、アクセントと組み合わさることで、数百万もの固有の文字を生成することがあります。
HN Digestによる図表(news.umich.eduの報告数値に基づく)。数値はソースの表記通り。
より多くのトークンはより多くのコンピュータメモリを消費するため、モデルが情報を処理できる利用可能なスペースが少なくなります。これにより、システムはトークンをより小さなバッチで処理せざるを得なくなり、トークンあたりの消費エネルギーが大幅に増加します。
この複合的な効果により、文字体系が複雑であればあるほど、推論プロセスの効率が低下することになります。この格差は、異なるモデルサイズや異なる種類のコンピュータプロセッサを横断して持続します。
「ミシガン大学工学部の研究者によれば、非英語のテキストを処理および生成する際、生成AIはより多くのエネルギーを消費し、時には精度の低い回答を提供することがあり、既存のグローバルな不平等を助長する可能性があるという。」
— Generative AI uses more energy on non-English text
グローバルユーザーへの二重のペナルティ
物理的なエネルギーコストに加え、この研究では、高いエネルギー要件を持つ言語は、より精度の低い回答を生成する傾向があることも判明しました。これにより、非英語話者が高いコストと低品質な出力の両方に直面するという「二重のペナルティ」が生じています。
この格差は潜在的なデジタルデバイドを生み出します。多くの企業は生成されたトークン数に基づいてAIアクセスの価格を設定しているため、非英語の言語を使用するユーザーは、より高い直接的なコストを負担する可能性があります。
さらに、これらの言語に対する精度の低さは、企業が特定の市場へのサービス提供を躊躇する要因となり、非英語を第一言語とする数十億の人々を排除してしまう可能性があります。
提案される解決策と限界
これらの不平等に対処するため、研究者は開発者に対し、汎用的なモデルに頼るのではなく、特定の言語に合わせてサービスを最適化することを推奨しています。これには、特定の文字体系に合わせて調整されたモデルにクエリをルーティングすることや、処理前にプロンプトを英語に変換するための信頼性の高い翻訳パイプラインを使用することが含まれます。
3つのオープンソースモデル(AlibabaのQwen 3、GoogleのGemma 3、MetaのLlama 3.1)を測定したこの研究は、ネイティブスピーカーの関与をさらに高める必要性を強調しています。過小評価されている言語のために、ネイティブスピーカーをクラウドソーシングして高品質のトレーニングデータやリソースを作成することは、これらのシステムの効率と正確性を向上させるのに役立つ可能性があります。
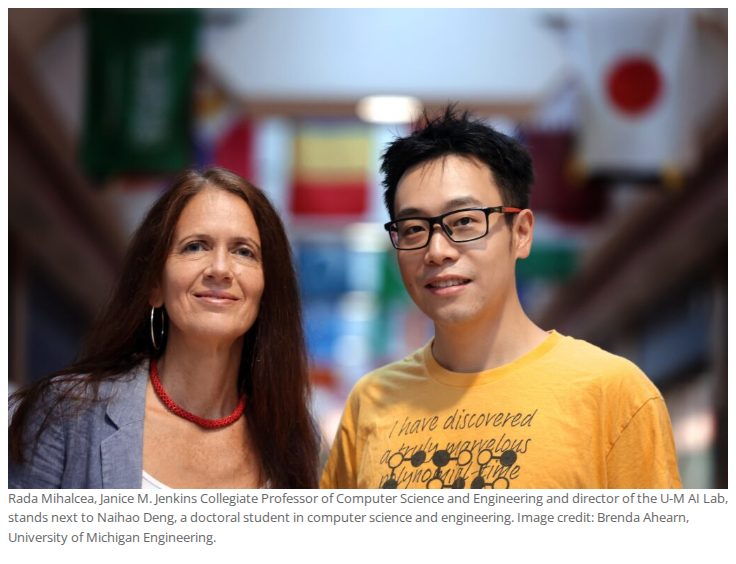
この画像は、LLMにおける言語ベースのエネルギー消費に関する研究を実施したミシガン大学の主要な研究者を特定するものです。
研究の範囲と不確実性
これらの知見は、3つの特定のオープンソースモデルと、ベンチマーク作成に使用された特定の翻訳ツール(No Language Left Behind)の測定に基づいています。GPT-4やClaudeのようなプロプライエタリなモデルが、この研究のオープンソースモデルと比較して、インド系文字のトークン化をどのように処理しているかは依然として不明です。
さらに、翻訳ツール自体の特定のエネルギー消費はこの測定の主な焦点ではなかったため、エンドユーザーにとっての最終的な効率計算に影響を与える可能性があります。
Hacker Newsの読者の反応
- 代替案: あるコメント投稿者は、効率を測定するために使用された指標が英語を不当に罰している可能性があると指摘しました。なぜなら、非ネイティブスピーカーによって書かれた膨大なトレーニング資料が結果を歪めている可能性があるからです。 コメント ↗
- 懐疑的: ある読者は、テストされたモデルが約18ヶ月前のものであり、その結果が現在のモデルにも一般化されるかどうかを疑問視しました。 コメント ↗
- 体験談: 数人のコメント投稿者が、AIツールがデフォルトで非英語の言語を使用したり、特定の指示がない限り英語での回答を拒否したりした個人的な経験を共有しました。 コメント ↗
Hacker Newsのスレッドで出た意見の要約です。事実として検証されたものではありません。 議論の全文を読む ↗