機械学習の研究エージェントは、標準的な教科書の予測に反する現象である過学習の罠に陥ることなく、固定されたベンチマークに対してモデルを正常に最適化することができます。Amazon Scienceの研究者は、これが起こる理由として、成功する戦略が戦略空間の「低複雑度領域」を占有しており、少数のトークンに集約できるためであることを特定しました。
過学習のパラドックス
標準的な機械学習理論では、モデルを固定された検証セットに対して繰り返し評価すると、最終的に過学習に至るはずです。これは、トレーニング手順が検証データを「見て」しまうため、モデルが基礎となるパターンを学習するのではなく、特定の回答を記憶してしまうことが起こるためです。
しかし、より広い機械学習コミュニティは、長年続くベンチマークでモデルを評価し、反復的に改善するという分散型のループの中で動作しています。同じデータに対して絶えず「山登り」を行っているにもかかわらず、モデルは真の進歩を示し続け、新しい未学習のデータセットにも良好に転移します。
「短い説明はズルをすることができません。なぜなら、そのためのスペースがないからです。」
— Why don’t machine learning research agents overfit?
圧縮仮説
このパラドックスの解説は、形式化されたオッカムの剃刀にあります。データを等しくよく説明する仮説の中で、最も単純なもの、つまり最も少ないビット数で記述できるものが、より汎用性が高い可能性が高いということです。もし戦略がトレーニングデータを記録するには小さすぎるものであれば、それを記憶することでズルをすることはできません。
研究者は、成功するML戦略は本質的にコンパクトであると仮定しています。勝利する戦略は通常、特定のアーキテクチャファミリー、オプティマイザー、または学習率スケジュールなど、いくつかの馴染みのある選択肢で構成されます。これらの選択肢は少数であるため、モデルのベンチマークに対する真の依存度は、それを発見するために使用された長い実験の記録よりもはるかに小さくなります。
情報ボトルネックのテスト
これをテストするために、研究者はLLMを含む3つのエージェント構成を使用しました。「探索者」エージェントは検証セットを使用して高パフォーマンスなモデルを反復的に探索しました。次に、「圧縮者」エージェントは探索者の仕事を非常に短いプロンプト(数トークン)に集約しました。最後に、検証セットや探索者の記録にアクセスできない「再現者」エージェントが、その短いプロンプトのみを使用して結果を再現しようと試みました。
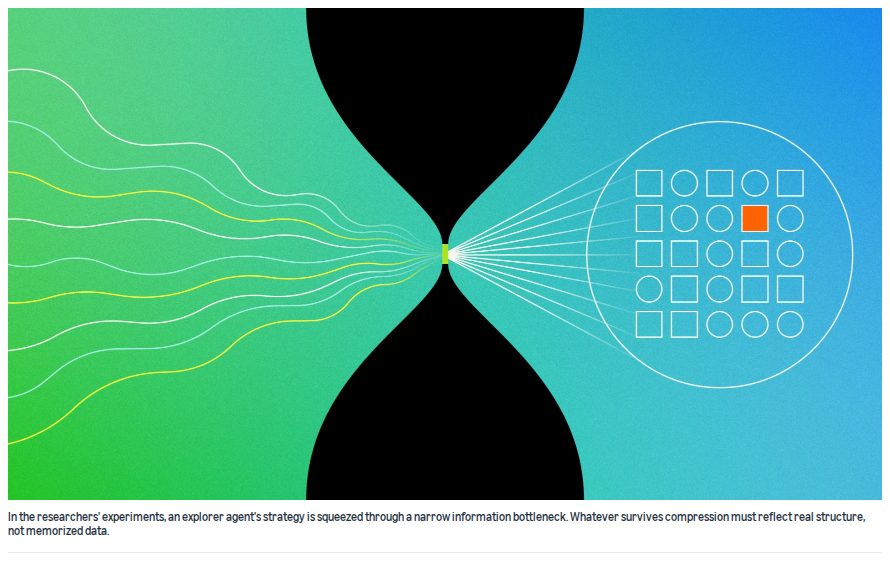
この視覚資料は、探索者の戦略を圧縮して、記憶されたノイズなしで性能を維持できるかを確認する核心的な実験メカニズムを説明しています。
結果として、再現者はビジョンおよび言語モデリングを含む8つの異なるデータセットにわたって探索者の性能を一致させることができました。これは、成功する戦略を指定するために必要な情報が極めて細いチャネルを通過できることを示唆しており、戦略が記憶されたノイズではなく、実際の構造を捉えたことを裏付けています。
知識デコーダーとしてのLLM
この研究は、なぜLLMがこのプロセスにおいて特に効果的なのかを明らかにしています。LLMはMLツールや標準的なアルゴリズムに関する広大な「世界知識」を所有しているため、簡潔な専門家間メッセージを展開することができます。短いプロンプトで詳細が指定されていない場合、LLMはその内部知識に基づいて妥当なデフォルト値を補完できます。
この画像は、専門レベルのML戦略が非常に少数のトークンで伝達できるという概念を説明しています。なぜなら、受信者はすでに必要なコンテキストを所有しているからです。
これはLLMが複雑な推論を可能にする理由を確認する一方で、明確な境界も確立します。研究者が意図的に過学習を誘発した場合、その結果として得られる戦略は圧縮テストに失敗します。これらの過学習したモデルは、その「知識」が圧縮不可能な特定のデータポイントに結びついているため、短いプロンプトを介して再現することはできません。
Hacker Newsの読者の反応
- 技術的な指摘: あるコメント投稿者は、機械学習モデルが過学習を避ける主な要因は、データポイントの数がパラメータの数を大幅に上回っている場合であると示唆しました。 コメント ↗
- 懐疑的: ある読者は、現代のAIモデルは実際には過学習の典型的な例であると主張し、高いベンチマークスコアにもかかわらず、しばしばハルシネーションやコンテキストの劣化を示すことを指摘しました。 コメント ↗
- 懐疑的: 数人のコメント投稿者は、この記事の質に対して懐疑的な見方を示し、「AI slop(AIによる質の低いコンテンツ)」と表現し、AI生成の執筆スタイルの多用を批判しました。 コメント ↗
- 技術的な指摘: 別のユーザーは、機械学習は根本的に汎用性に関するものであり、パターンを記憶することは丸暗記と同じではないと指摘しました。 コメント ↗
Hacker Newsのスレッドで出た意見の要約です。事実として検証されたものではありません。 議論の全文を読む ↗