Más del 80 por ciento de los servidores de puerta de enlace de red de Microsoft dejaron de responder durante una interrupción masiva que impidió a los usuarios globales acceder a Exchange Online y Outlook. El fallo fue provocado por un defecto de software latente introducido en una actualización de julio de 2026, que permaneció inactivo hasta que una combinación específica de alta carga y capacidad de servidor reducida empujó al sistema hacia un colapso en cascada.
El mecanismo del fallo
La interrupción tuvo su origen en un defecto de software que causó una contención de bloqueos dentro de un proceso interno de Windows. Esta contención provocó el agotamiento de recursos críticos del sistema, específicamente CPU y memoria, en los servidores de puerta de enlace de red.
Esta figura ilustra el mecanismo específico del defecto de software que causó que los servidores de puerta de enlace de red dejaran de responder.
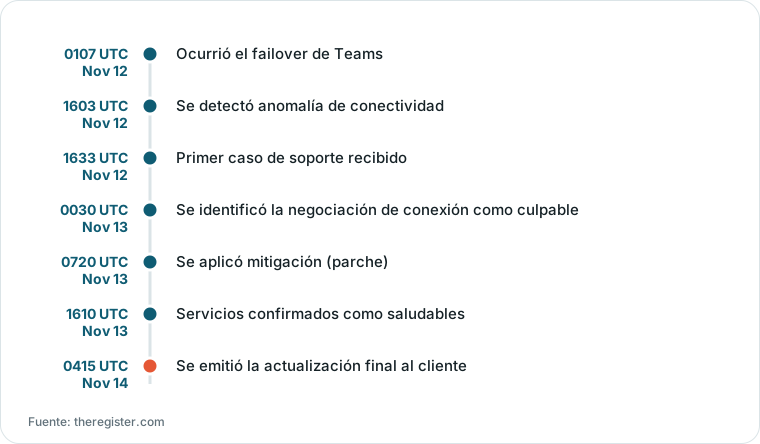
Gráfico elaborado por HN Digest a partir de cifras reportadas por theregister.com; los valores se muestran como escritos en la fuente.
Crucialmente, el defecto se comportaba de manera diferente dependiendo del hardware. El informe preliminar de Microsoft señaló que el problema de contención en realidad empeoraba en máquinas con más núcleos y hardware más nuevo, que son estándar en los entornos de producción modernos.
Esta imagen respalda la afirmación de que el defecto se comportaba de manera diferente dependiendo del hardware, empeorando específicamente en máquinas más nuevas con un alto número de núcleos.
“El problema de contención empeora en máquinas con más núcleos y hardware más nuevo.”
— Microsoft blames monster email outage on software defect introduced in July fix
Brechas de prueba y efectos en cascada
El defecto escapó a la detección durante el despliegue de julio porque las pruebas de carga de Microsoft tendían a centrarse en hardware más débil con menos núcleos. Debido a que el error solo se manifestaba significativamente en máquinas de altas especificaciones, la actualización parecía estable durante la fase inicial de pruebas.
Cuando comenzó la interrupción, siguió un patrón clásico de fallo en cascada. A medida que los servidores individuales perdían conectividad debido al agotamiento de recursos, el tráfico se redirigía automáticamente a los siguientes puntos finales sanos. Estos puntos finales luego encontraban el mismo defecto y fallaban, provocando finalmente que toda la flota dejara de responder en un plazo de dos horas.
Desafíos de recuperación y resolución
Los procedimientos de recuperación estándar fueron ineficaces porque los servidores se encontraban en un estado de falta de respuesta general que los sistemas automatizados no estaban diseñados para manejar. Además, una reversión directa era imposible porque el código defectuoso había estado en producción durante meses.
Para restaurar el servicio, los ingenieros tuvieron que desarrollar una actualización específica para devolver la ruta del código a un estado previamente conocido como bueno. El servicio se restauró gradualmente a medida que este 'parche para el parche' se aplicaba a grupos de servidores, estabilizando finalmente la infraestructura de Exchange Online.
Qué dicen los lectores de Hacker News
- Nota técnica: Un comentarista señaló que la discrepancia entre los entornos de prueba de gama baja y las máquinas de producción de gama alta probablemente ocultó un error de concurrencia, cuestionando si tal brecha de prueba es una concesión común o aceptable. comentario ↗
- Nota técnica: Un comentarista que analizó el hardware específico mencionó que si las máquinas de prueba tenían significativamente menos núcleos que los servidores de producción, la falla al detectar la contención de bloqueos sería un descuido importante. comentario ↗
- Escéptico: Un lector argumentó que el incidente resalta los riesgos de depender de sistemas automatizados y sugirió que, a medida que se reduce el trabajo humano, resolver interrupciones tan complejas se volverá cada vez más difícil. comentario ↗
- Escéptico: Otro comentarista sugirió que la interrupción podría ser un síntoma de una deuda técnica latente causada por ciclos de desarrollo rápidos y el uso creciente de código generado por IA. comentario ↗
Resumen de opiniones del hilo de Hacker News; no son hechos verificados. Leer el debate completo ↗