En un clúster de prueba de tres nodos, db-branch puede crear una rama de base de datos PostgreSQL en aproximadamente 0.5 segundos y una rama de MySQL en unos 3 segundos. Estas operaciones involucran 0 bytes de copia de datos porque el sistema aprovecha la tecnología de copia sobre escritura (CoW) de ZFS para crear clones de un conjunto de datos base.
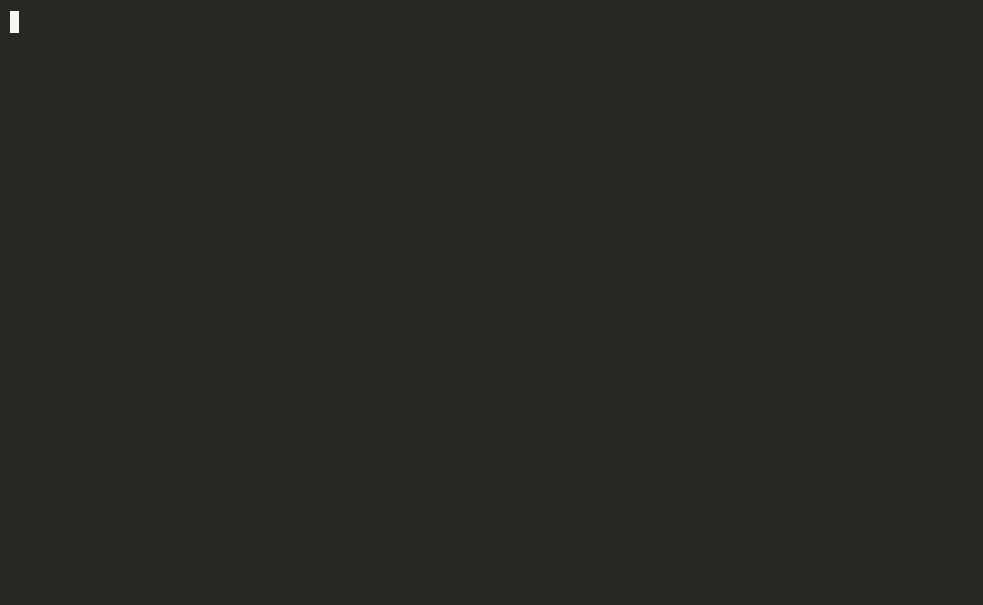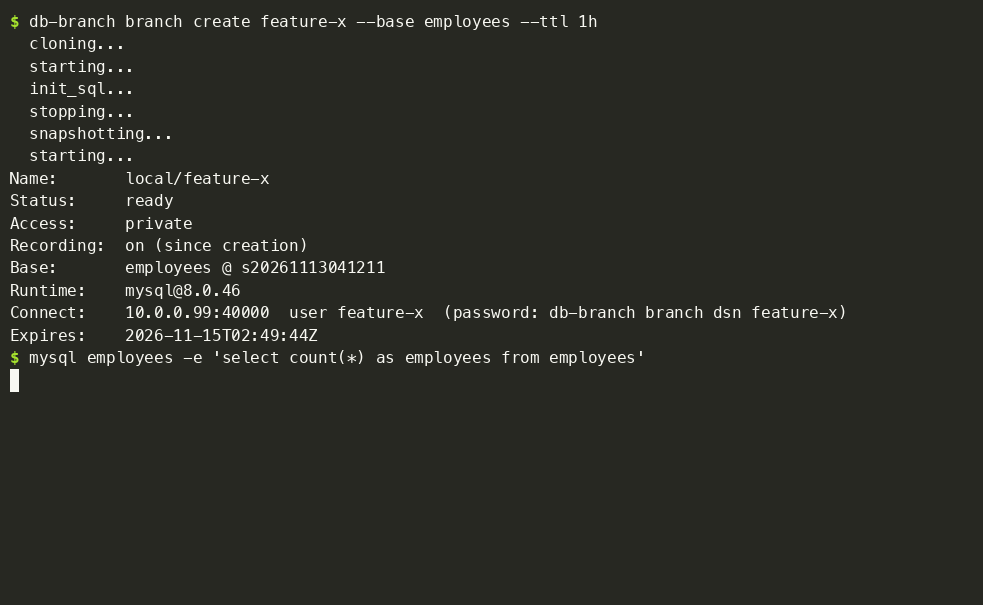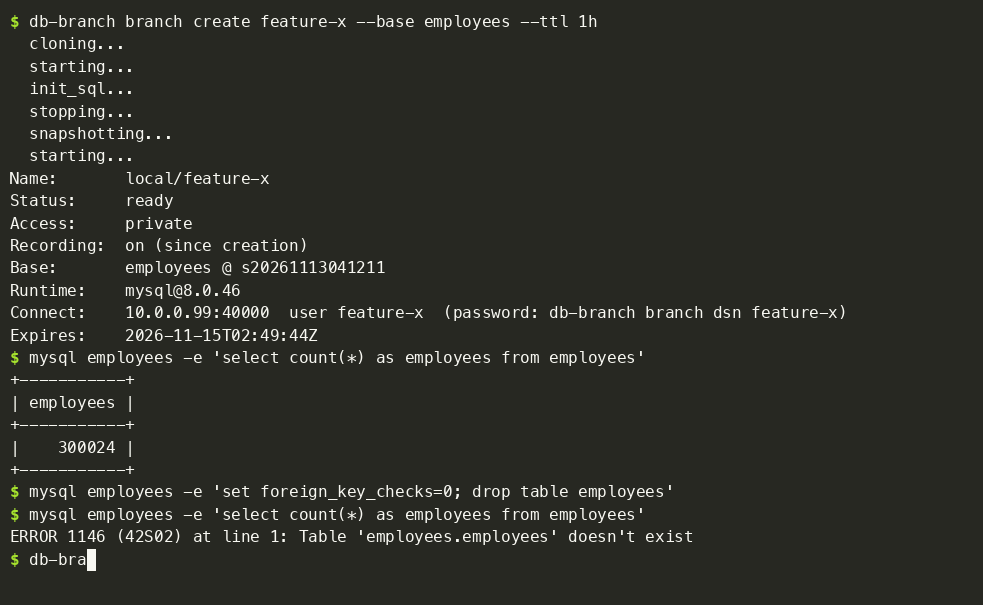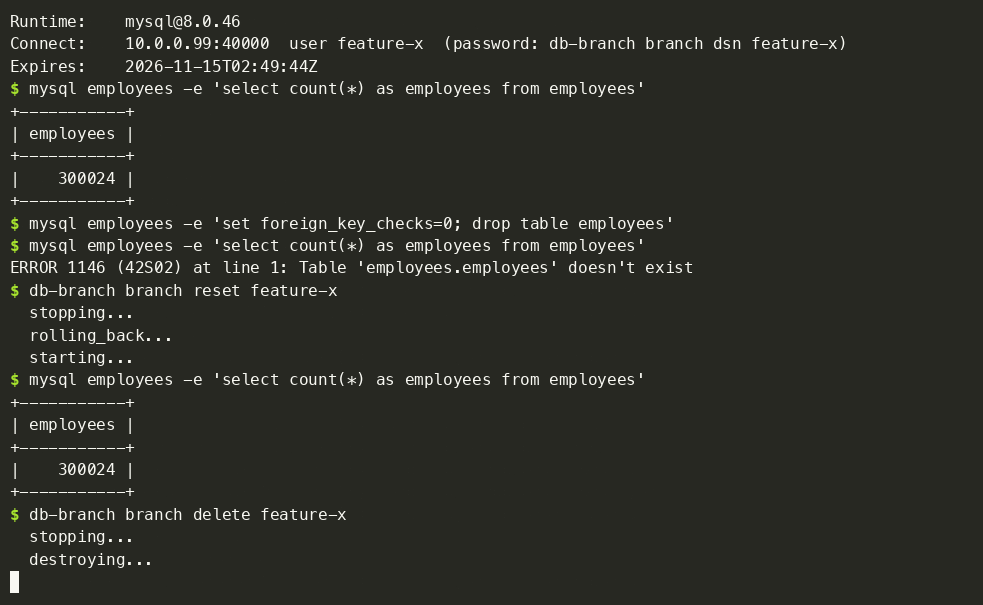
Este GIF demuestra la funcionalidad principal de db-branch, incluyendo la creación de ramas y la gestión de su ciclo de vida.
Mecanismo de ramificación de copia sobre escritura
La arquitectura central de db-branch se basa en conjuntos de datos ZFS. Una 'base' es un conjunto de datos ZFS que contiene una base de datos cargada, mientras que una 'rama' es un clon ZFS de una instantánea de esa base. Debido a que los clones de ZFS son de copia sobre escritura, la creación inicial de una rama es casi instantánea independientemente del tamaño de la base de datos.
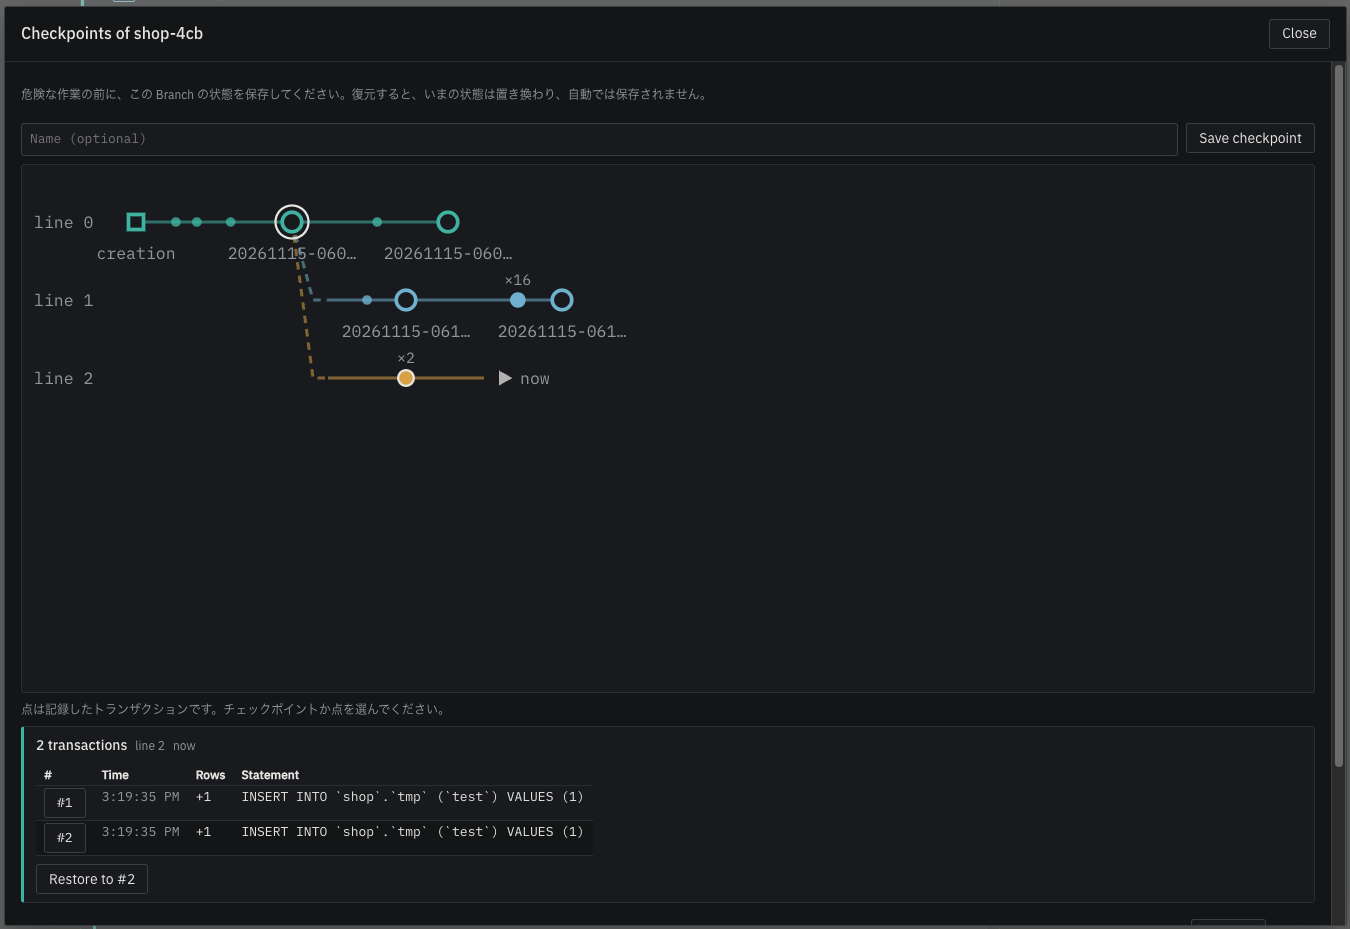
El gráfico de ramas representa visualmente cómo los clones se derivan de conjuntos de datos base utilizando la tecnología de copia sobre escritura de ZFS.
Cada rama ejecuta su propio servidor de base de datos en un puerto único. Para simplificar el acceso de las aplicaciones, el sistema puede utilizar el enrutamiento de ProxySQL para dirigir las conexiones de los clientes a la rama correcta basándose en nombres de usuario o comentarios de consulta específicos.
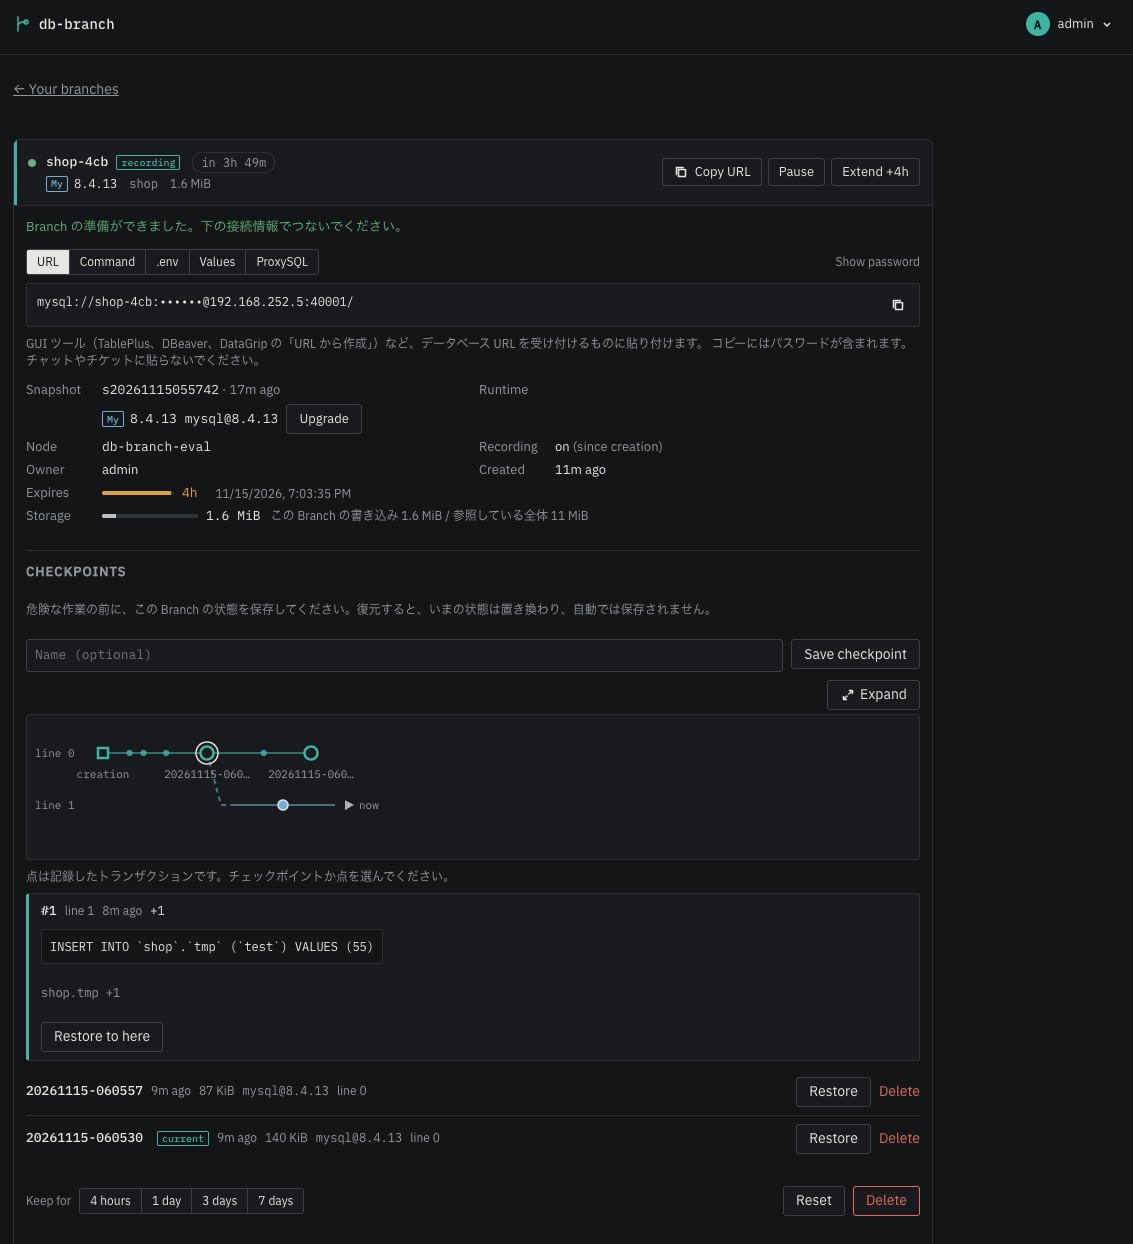
La consola web proporciona una interfaz unificada para gestionar las diversas ramas de bases de datos creadas por el sistema.
“db-branch crea una rama de copia sobre escritura de una base de datos grande en segundos, sin copiar nada.”
— GitHub - db-branch/db-branch: Instant MySQL database branches on ZFS clones, clustered across VMs with ProxySQL routing
Casos de uso para agentes de IA y CI/CD
db-branch está diseñado específicamente para resolver el problema de los entornos de bases de datos 'compartidos' en el desarrollo. Permite copias de bases de datos 'por solicitud de extracción' (per-pull-request), donde cada ejecución de CI obtiene una copia fresca y aislada que se elimina automáticamente después de un tiempo de vida (TTL) establecido.
Para los agentes de IA, el proyecto incluye un servidor MCP (Model Context Protocol) integrado. Esto permite que un agente LLM cree de forma autónoma una rama, ejecute consultas o migraciones de riesgo y luego elimine la rama, asegurando que los datos de producción permanezcan intactos durante las operaciones del agente.
Gestión de versiones y arquitectura de clúster
El sistema permite ejecutar múltiples versiones de MySQL y PostgreSQL simultáneamente. Los usuarios pueden realizar una actualización de 'solo comprobación' en una rama específica para identificar posibles problemas antes de aplicar la actualización a la base o a otras ramas.
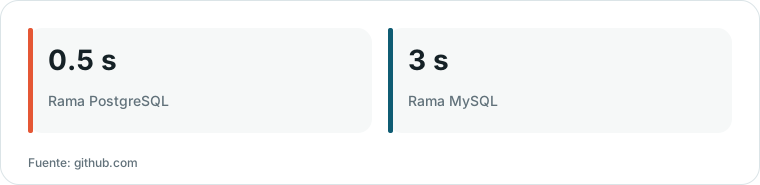
Gráfico elaborado por HN Digest a partir de cifras reportadas por github.com; los valores se muestran tal como aparecen en la fuente.
El software opera como un clúster Raft de máquinas virtuales, que comparte bases, ramas y configuraciones entre los nodos. Aunque el proyecto principal está bajo la licencia Apache-2.0, ciertas funciones avanzadas como SSO, auditoría e historial se ofrecen como módulos separados de código cerrado.
Requisitos de despliegue y limitaciones
db-branch es una solución autoalojada y no ofrece una versión gestionada en la nube. Requiere un entorno Linux (específicamente Ubuntu 24.04 o 26.04 LTS) y un pool de ZFS para funcionar.
Debido a que el sistema depende de funciones específicas de ZFS, no es compatible con volúmenes de almacenamiento estándar nativos de la nube que no admitan clones de ZFS. Además, aunque el núcleo es de código abierto, el proyecto utiliza una combinación de módulos de código abierto y cerrado para funciones empresariales específicas.
Qué dicen los lectores de Hacker News
- Experiencia: Un comentarista compartió su experiencia práctica de configurar recientemente un sistema similar en su lugar de trabajo para proporcionar clones de bases de datos económicos. comentario ↗
- Nota técnica: Un comentarista pidió aclaración sobre si el proyecto utiliza el método nativo file_copy_method en Postgres 18 o utiliza una implementación personalizada. comentario ↗
- Pregunta abierta: Un usuario planteó una pregunta importante sobre si es posible fusionar los cambios de una rama creada de vuelta a la copia oficial. comentario ↗
Resumen de opiniones del hilo de Hacker News; no son hechos verificados. Leer el debate completo ↗