Sin información posicional explícita, un mecanismo de autoatención trataría las frases 'El zorro rojo salta sobre el zorro gris' y 'El zorro gris salta sobre el zorro rojo' como idénticas, ya que la palabra 'zorro' recibiría el mismo vector de incrustación independientemente de su ubicación. Para resolver esto, modelos como GPT-2 y MiniMax-M3 inyectan datos específicos de posición en los vectores de tokens, permitiendo que el transformer comprenda la secuencia estructural de la entrada.
Esta imagen explica la necesidad fundamental de los datos posicionales al mostrar cómo las palabras idénticas cambian de significado según su secuencia.
El mecanismo de las incrustaciones de posición absoluta
En la arquitectura de GPT-2, la información de posición se añade como un vector distinto a la incrustación del token. El modelo aprende una tabla de vectores de posición durante el entrenamiento y, para cada token en la posición m, se selecciona un vector P_m y se añade elemento a elemento al vector de incrustación del token.
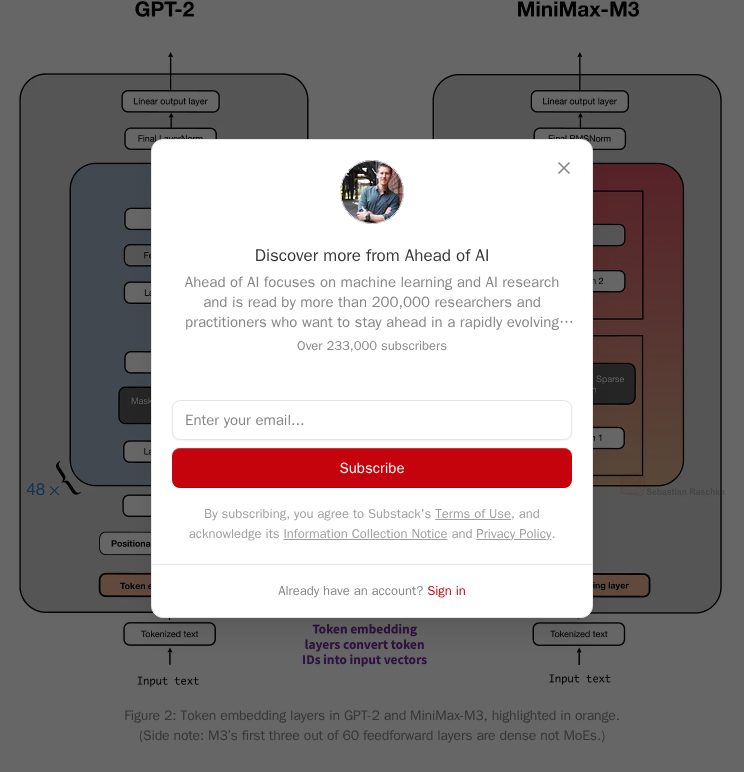
Esta figura ilustra la ubicación arquitectónica específica de las incrustaciones posicionales en diferentes tipos de modelos.
Este enfoque garantiza que, incluso si dos tokens son idénticos (por ejemplo, la palabra 'zorro' que aparece dos veces), entren en los bloques del transformer con representaciones numéricas diferentes. Sin embargo, este método está limitado por el tamaño de la tabla de incrustación predefinida, la cual debe establecerse antes de que comience el entrenamiento.
"No obstante, GPT-2 y la mayoría de los LLM más nuevos incluyen información posicional explícita porque le da a la atención una señal directa sobre las posiciones.",
— Understanding Positional Embeddings in Modern LLMs
Limitaciones de escalabilidad y el cambio hacia métodos relativos
Una desventaja significativa de las incrustaciones de posición absoluta es el costo de expandir la ventana de contexto. Para GPT-2 Medium, la capa de incrustación posicional representa solo el 0,30% de los pesos con un límite de 1.024 tokens; sin embargo, escalar ese mismo contexto a 100.000 tokens aumentaría esa proporción a más del 22% del total de los pesos del modelo.
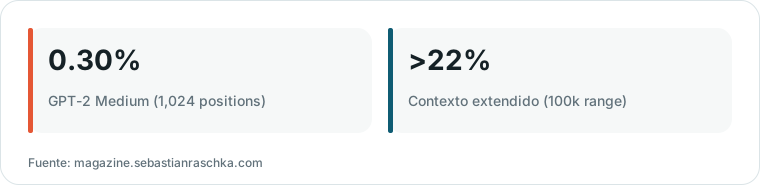
Gráfico elaborado por HN Digest a partir de las cifras de magazine.sebastianraschka.com; los valores se muestran como en la fuente.
Para evitar esto, muchos modelos modernos se han desplazado hacia las incrustaciones posicionales relativas, como Rotary Positional Embeddings (RoPE). A diferencia del método absoluto, RoPE inyecta información posicional directamente en el mecanismo de atención, lo que permite un manejo más eficiente de las dependencias de largo alcance sin inflar el recuento de pesos del modelo.
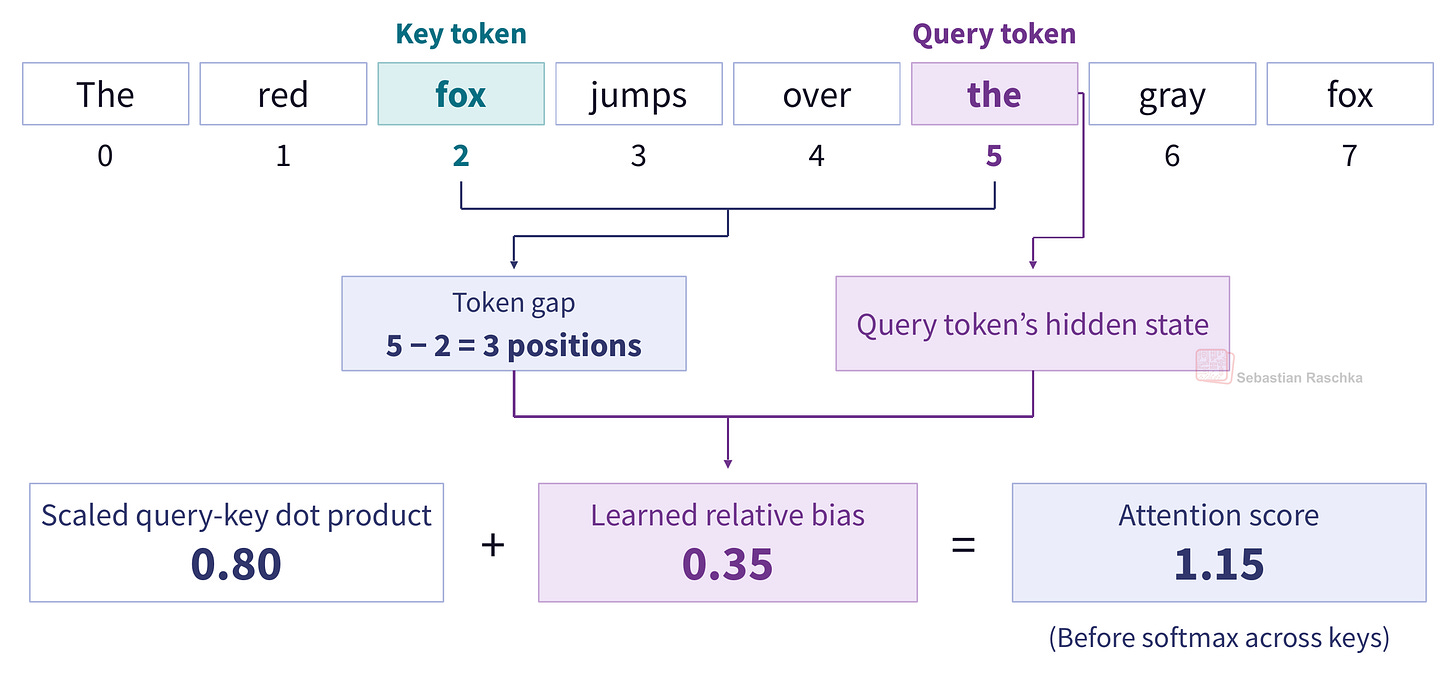
Esta imagen apoya la explicación de cómo funcionan los métodos relativos como RoPE dentro del mecanismo de atención.
Orden implícito frente a señales explícitas
Las máscaras causales en los modelos autorregresivos proporcionan un grado de orden implícito al restringir a qué tokens anteriores puede prestar atención un token actual. Teóricamente, esto permite que un modelo distinga el orden de las palabras incluso sin incrustaciones explícitas.
A pesar de esto, los métodos posicionales explícitos siguen siendo esenciales porque la máscara causal no proporciona una sensación de distancia. Las incrustaciones explícitas proporcionan una señal directa que ayuda al modelo a diferenciar entre el vecino inmediato de un token y un token a diez posiciones de distancia, una distinción que es vital para la generación de texto coherente.