El procesador Fursoy Slice-1 ha alcanzado un hito significativo al arrancar Linux 6.6.50 mainline y BusyBox bajo memoria virtual Sv39. Desarrollado como un núcleo RISC-V superscalar de 64 bits fuera de orden diseñado desde cero, el proyecto demuestra que las microarquitecturas complejas y de alto rendimiento pueden implementarse en SystemVerilog cumpliendo con los rigurosos requisitos de tiempo para la síntesis de celdas estándar.
Esta imagen proporciona una visión general visual de la plataforma del procesador Fursoy Slice-1 descrita en el artículo.
Microarquitectura y diseño del pipeline
El núcleo Fursoy Slice-1 utiliza un pipeline de obtención, decodificación y renombrado de registros de 2 vías diseñado para la ejecución fuera de orden. Para gestionar la ejecución especulativa, emplea un Reorder Buffer (ROB) de 128 entradas con etiquetas de época de 4 bits seguras para el envoltorio, lo que permite una recuperación precisa de excepciones y purgas de interrupciones.
El diseño incluye colas de emisión dedicadas para diferentes tipos de instrucciones: colas de 32 entradas para instrucciones de Enteros y Memoria, una cola de 64 entradas para Punto Flotante y una cola desacoplada de 8 entradas para instrucciones Vector (VLEN=256). También cuenta con 8 puntos de control de ramificación para facilitar la reversión de RAT (Register Alias Table) especulativa en un solo ciclo.
Gestión de memoria y coherencia de caché
El procesador soporta memoria virtual Sv39 a través de un DTLB de doble puerto y un ITLB. Una característica arquitectónica clave es el Page Table Walker (PTW) de hardware compartido, que recorre las tablas de páginas con coherencia de snoop de L1D sucia no destructiva. Esto permite que las escrituras en la tabla de páginas que se encuentran sucias en la L1D sean observadas directamente sin requerir una expulsión.
El subsistema de memoria está respaldado por una caché L1I de 16 KiB de 4 vías asociativas y una caché L1D no bloqueante de 16 KiB de 8 bancos. La caché L1D incluye una Load Queue de 16 entradas, una Store Queue de 16 entradas y 4 registros de estado de fallos (MSHRs) para manejar solicitudes de memoria concurrentes.
Resultados de síntesis y telemetría de rendimiento
La síntesis física se evaluó utilizando Yosys, sv2v y OpenSTA en la biblioteca Nangate 45nm. El diseño cumplió con éxito el objetivo de tiempo de 500 MHz en ocho bloques del núcleo independientes, incluyendo la unidad de ramificación, CSR, DTLB, ITLB, AGU, unidad de decodificación y ALU.
Durante la verificación, el núcleo alcanzó un IPC de 0.84838 a lo largo de aproximadamente 89.8 millones de ciclos simulados. La telemetría exacta por ciclo muestra que el 47.94% de los ciclos fueron productivos, mientras que el 16.72% se gastó en predicciones de ramificación incorrectas y recuperación de purgas de excepciones, y el 6.18% se atribuyó a fallos de L1D o conflictos de banco.
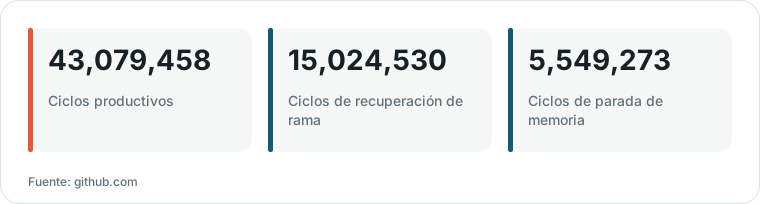
Gráfico elaborado por HN Digest a partir de cifras reportadas por github.com; los valores se muestran como en la fuente.
Limitaciones actuales y alcance
Aunque el núcleo cumple con los objetivos de tiempo para sus bloques funcionales principales, el proyecto aún no ha ejecutado el proceso completo de colocación y enrutamiento de SoC ni la compilación de macros SRAM. El cierre de tiempo actual de 500 MHz se aplica a los ocho bloques independientes en lugar del entorno de Sistema en un Chip (SoC) totalmente integrado.