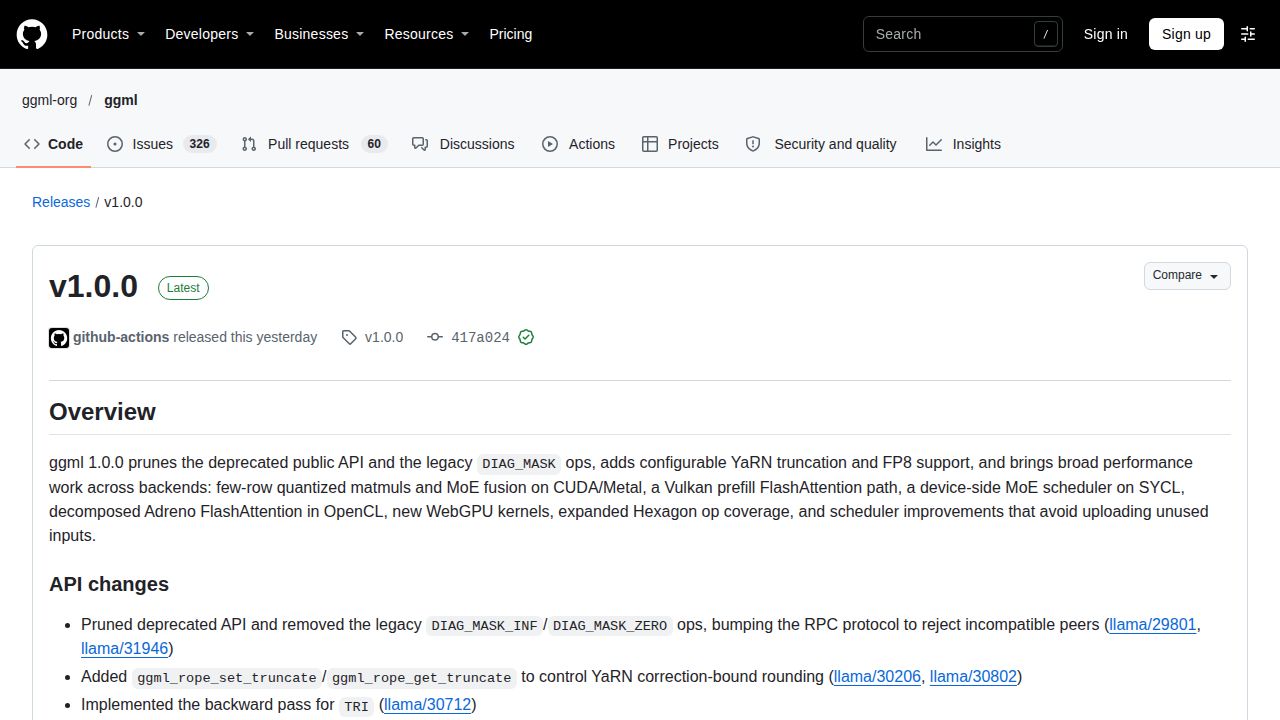
El lanzamiento de GGML versión 1.0.0 marca un hito significativo para una biblioteca en C diseñada para facilitar la inferencia de aprendizaje automático local de alto rendimiento. Desarrollada por Georgi Gerganov (cuyas iniciales forman la 'GG' en el nombre del proyecto), la biblioteca sirve como una capa fundamental para herramientas como llama.cpp, permitiendo a los usuarios ejecutar modelos de lenguaje grandes en una amplia variedad de hardware, desde sistemas heredados hasta arquitecturas modernas.
El proyecto GGML y la versión 1.0.0
La fuente principal, un lanzamiento en GitHub, anuncia la versión oficial 1.0.0 de GGML. El proyecto es una biblioteca en C para aprendizaje automático que se enfoca en impulsar la inferencia local 'bit a bit'.
Como componente central del ecosistema llama.cpp, GGML está diseñado para ser una 'tienda de un solo lugar' para lograr que los modelos se ejecuten en casi cualquier hardware. Esto lo convierte en una herramienta crítica para desarrolladores y entusiastas que priorizan la ejecución local sobre las APIs basadas en la nube.
Comentarios de la comunidad y rendimiento
Los comentaristas en Hacker News destacaron la capacidad del proyecto para proporcionar mejoras de rendimiento constantes. Un usuario informó una reducción específica del tiempo de ejecución de 4:22 a 3:59 al procesar un prompt de 50K tokens, señalando que las actualizaciones frecuentes a menudo producen mejoras de velocidad del 5% al 10%.
La discusión también enfatizó la accesibilidad de la biblioteca para usuarios con hardware no estándar. Por ejemplo, un comentarista señaló que GGML y llama.cpp hicieron posible ejecutar modelos en una tarjeta AMD que solo admite la API Vulkan.
Compatibilidad de hardware y compensaciones
Una fortaleza clave de GGML es su amplio soporte de hardware, que incluye tanto sistemas antiguos como la arquitectura RISC-V. Esta versatilidad le permite servir como un puente entre diferentes entornos de computación.
Sin embargo, algunos usuarios señalaron una compensación con respecto a la velocidad bruta. Si bien GGML es elogiado por su fiabilidad y facilidad de uso, los motores de inferencia especializados con kernels optimizados específicamente para una pieza de hardware particular aún pueden superarlo en términos de velocidad de ejecución pico.
Resumen de la discusión
La discusión en Hacker News se centró en los logros de ingeniería del proyecto. Los comentaristas lo describieron como un 'producto de ingeniería genuino' y compararon su papel en el mundo de la IA con el de Linux.
Si bien la comunidad elogió en gran medida la utilidad del proyecto, algunos usuarios sugirieron que la página de aterrizaje del proyecto podría beneficiarse de un diseño más profesional para igualar la alta calidad del software subyacente.