El modelo NVIDIA GLM-5.3 NVFP4, un modelo de mezcla de expertos (MoE) cuantizado con 753 mil millones de parámetros, requiere aproximadamente 464 GB de memoria de GPU, una huella que supera la capacidad de 252 GB de HBM3e de una sola GPU GB300. Para superar esta limitación de hardware, NVIDIA utilizó dos estaciones DGX vinculadas a través de ConnectX-8 RDMA para servir el modelo como un único punto de acceso unificado.
Gestión de pesos distribuidos
Debido a que cada token en un modelo de mezcla de expertos puede ser enrutado a diferentes expertos, todos los pesos del modelo deben permanecer accesibles en la memoria de la GPU. El tutorial demuestra un servicio distribuido donde dos estaciones DGX ejecutan el mismo software y checkpoint en diferentes roles: la Estación A (rank 0) aloja la API, mientras que la Estación B (rank 1) actúa como un trabajador.
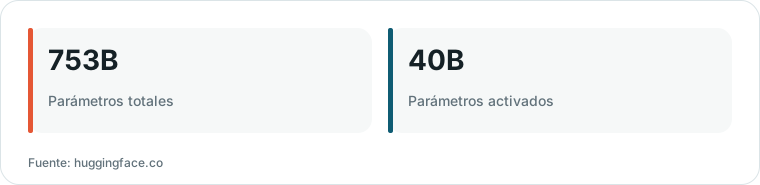
Gráfico elaborado por HN Digest a partir de cifras de huggingface.co; los valores se muestran tal como aparecen en la fuente.
El paralelismo de tensores (TP=2) es el mecanismo utilizado para dividir los tensores del modelo entre las dos GPUs GB300. Ambas estaciones computan cada solicitud, pero solo la Estación A devuelve la respuesta final a través de una API compatible con OpenAI.

Esta imagen ilustra la configuración física y lógica de las dos estaciones DGX trabajando juntas para alojar el modelo GLM-5.3.
“Dos estaciones NVIDIA DGX conectadas a través de ConnectX-8 RDMA sirven el modelo a través de un único punto de acceso compatible con OpenAI utilizando paralelismo de tensores (TP=2), con cada GPU sosteniendo y computando aproximadamente la mitad de los pesos.”
— When One GPU Isn’t Enough: Serving GLM-5.3 Across Two NVIDIA DGX Stations with vLLM | NVIDIA Technical Blog
Redes y optimizaciones de inferencia
Las dos estaciones están conectadas a través de ConnectX-8 RDMA, proporcionando la interconexión de alta velocidad necesaria para el paralelismo de tensores. Esta configuración permite a vLLM lanzar un servicio distribuido que admite la predicción de múltiples tokens (MTP), donde el modelo redacta cuatro tokens por paso para aumentar la velocidad.
Para optimizar aún más el rendimiento bajo carga concurrente, la configuración emplea el almacenamiento de KV-cache en FP8 para reducir a la mitad el uso de memoria en comparación con el almacenamiento de 16 bits. También utiliza el almacenamiento en caché de prefijos para evitar el reprocesamiento de prefijos de prompts que el servidor ya haya encontrado anteriormente.
Benchmarks de rendimiento y compensaciones
Los benchmarks de AIPerf en el conjunto de datos SPEED-Bench Coding mostraron que el sistema alcanzó un pico de 607.8 tokens por segundo con una concurrencia de 16. Sin embargo, a medida que la concurrencia aumentó a 32, el rendimiento cayó a 385.0 tokens por segundo, con una latencia media de solicitud de 453.5 segundos.

El gráfico proporciona los puntos de datos específicos para los benchmarks de rendimiento mencionados en el texto.
Si bien esta arquitectura permite la ejecución local de modelos de escala fronteriza, implica requisitos de hardware significativos y un alto consumo de energía. La configuración está diseñada para entornos de alto rendimiento donde la privacidad o requisitos locales específicos superan los costes de mantener un clúster DGX de múltiples estaciones.
Qué dicen los lectores de Hacker News
- Escéptico: Un comentarista argumentó que la configuración podría ser económicamente irrazonable debido a un largo retorno de inversión y altos costes operativos, a menos que el usuario priorice la privacidad. comentario ↗
- Escéptico: Otro usuario sugirió que el hardware podría ser excesivo para pequeñas empresas, señalando que el uso extremo de energía y el ruido lo hacen poco práctico para entornos que no sean empresariales. comentario ↗
- Alternativa: Un comentarista sugirió un punto medio más accesible para interconexiones de alta velocidad utilizando Thunderbolt en macOS para configuraciones de menor escala. comentario ↗
- Nota técnica: Un lector señaló que GLM-5.3 puede haber sido elegido sobre DeepSeek porque su arquitectura es más simple y NVIDIA puede tener más familiaridad con el modelo. comentario ↗
Resumen de opiniones del hilo de Hacker News; no son hechos verificados. Leer el debate completo ↗