Los asistentes de voz a menudo experimentan un retraso perceptible porque deben esperar una señal de 'fin de habla' antes de poder activar llamadas a Modelos de Lenguaje Grande (LLM) o generar una salida de audio. RealtimeVAD aborda este cuello de botella proporcionando un evento de 'pausa' que ocurre una mediana de 100ms antes que el modelo estándar Silero VAD, permitiendo transiciones más rápidas en los flujos de voz generativos.
Mecanismo de detección más rápida
RealtimeVAD mantiene el uso del modelo Silero VAD para determinar qué constituye habla, pero superpone una comprobación de alta frecuencia. Cada 10ms, el sistema compara el nivel de audio actual tanto con el ruido ambiental de la sala como con el volumen del propio hablante.
En el momento en que el audio se silencia en relación con estas líneas base, el sistema activa un evento de 'pausa'. Esto sucede mucho antes de que la puntuación de probabilidad interna del modelo Silero haya caído lo suficiente como para señalar el final de un turno.
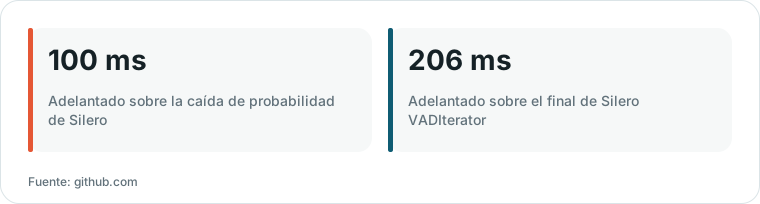
Gráfico elaborado por HN Digest a partir de cifras reportadas por github.com; los valores se muestran como en la fuente.
“RealtimeVAD lo hace antes. Mantiene Silero VAD para decidir qué es habla y añade una segunda comprobación más rápida: cada 10 ms compara el nivel de audio con el ruido de la sala y con el nivel del propio hablante.”
— GitHub - KoljaB/RealtimeVAD: Faster speech off signals for spec gen voice pipelines
Benchmarks de rendimiento y compensaciones
En pruebas realizadas en 3,279 turnos de asistentes de voz reales, el evento de 'pausa' de RealtimeVAD llegó en el 82% de las ocasiones antes que la señal de finalización de Silero. Sin embargo, esta velocidad conlleva una mayor frecuencia de falsos positivos; la herramienta se activa en cada respiración o consonante de parada, lo que significa que identifica muchas 'pausas' que son en realidad breves espacios dentro de una sola oración.
Los desarrolladores pueden utilizar estos frecuentes eventos de 'pausa' para comenzar trabajos especulativos, como preparar una transcripción o precargar datos de LLM, que luego pueden cancelarse si el hablante continúa. Si un sistema no puede manejar cancelaciones rápidas, puede ignorar los eventos de 'pausa' y esperar a la señal final de 'fin', que sigue llegando más rápido que la configuración predeterminada de Silero.
Restricciones ambientales y limitaciones
La efectividad del adelanto de 100ms depende en gran medida del entorno de audio. En salas donde el ruido ambiental está dentro de los 20dB del volumen del hablante, el adelanto se pierde porque el sistema no puede distinguir los finales de habla suave del ruido de fondo.
Además, la herramienta requiere audio mono de 16 kHz y funciona mejor cuando la supresión de ruido está activa. Para habla muy silenciosa o de banda estrecha, como en una línea telefónica, el sistema aún puede alcanzar los límites inherentes del modelo Silero subyacente.