La nueva herramienta MACaQ de Huawei puede cuantizar un modelo masivo de 122 mil millones de parámetros en solo 64 minutos utilizando únicamente 32,5 GB de memoria del dispositivo. Este desarrollo aborda un cuello de botella significativo en la inferencia de IA local: el tiempo y los recursos de hardware necesarios para comprimir modelos grandes en formatos que puedan ejecutarse en hardware de consumo sin una pérdida significativa de calidad.
Capacidades de cuantización multimodal
MACaQ está diseñado como un marco de cuantización agnóstico a modelos, lo que significa que puede aplicarse a varios tipos de modelos de IA en lugar de estar restringido a una sola arquitectura. Soporta la generación de texto, la generación de imágenes y vídeos a través de Diffusers, y la generación de voz mediante PyTorch.
Este banner representa el propósito principal del marco MACaQ como una herramienta de cuantización agnóstica a modelos.
La herramienta proporciona flujos de trabajo específicos para diferentes backends. Por ejemplo, es compatible con formatos GGUF de 2, 3 y 4 bits para llama.cpp, y con W4A4 (pesos de 4 bits y activaciones de 4 bits) para vLLM y modelos de voz basados en PyTorch.
Benchmarks de eficiencia y rendimiento
Una ventaja principal de MACaQ es su velocidad. Los desarrolladores afirman que puede igualar la mejor perplejidad de Llama-3-8B requiriendo un tiempo de cuantización 11 veces menor que los métodos de la competencia. Esta eficiencia es fundamental para investigadores y desarrolladores que necesitan iterar rápidamente en modelos comprimidos.
En pruebas con el modelo Qwen3.6-35B-A3B, MACaQ-R (un método de refinamiento) logró una divergencia KL de 0,013367 en comparación con FP16, superando al método Unsloth UD-Q4_K_XL que obtuvo 0,015731. Una divergencia KL más baja indica una reconstrucción de mayor calidad de los pesos del modelo original.
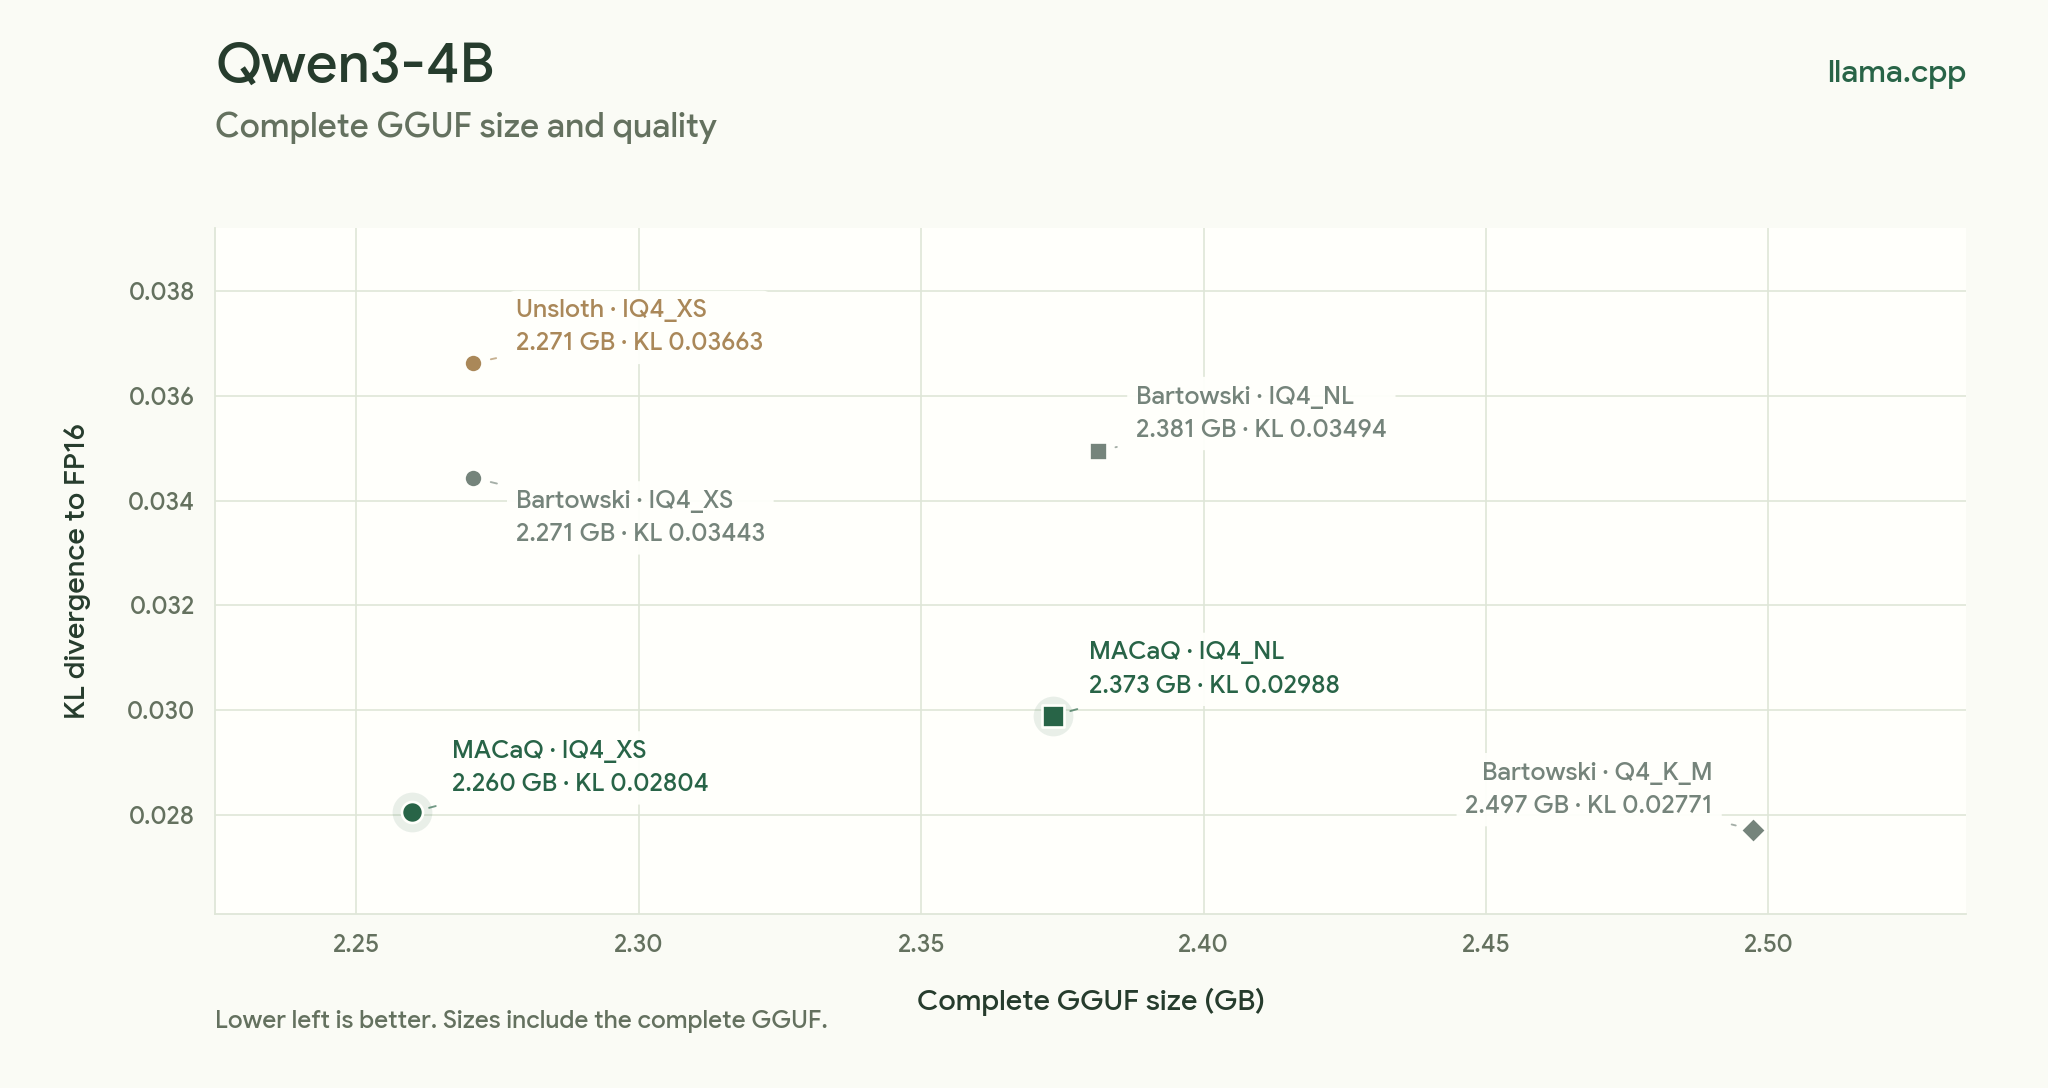
Este gráfico proporciona una comparación visual del tamaño del modelo y la calidad de reconstrucción (divergencia KL) mencionada en los benchmarks de rendimiento.
Compensaciones de inferencia e integración de hardware
Si bien MACaQ mejora significativamente la velocidad de inferencia, existen compensaciones medibles en la precisión. Para el modelo Qwen3.8-27B, pasar de la precisión BF16 a MACaQ W4A4 resultó en un ligero aumento en la perplejidad de 2,8463 a 2,8994, aunque esto se compensó con un aumento sustancial en la velocidad de decodificación.
Para los usuarios en el hardware Ascend de Huawei, el proyecto proporciona kernels específicos de matmul densos y agrupados a través de solicitudes de extracción (pull requests) de CANN. Esto garantiza que los beneficios de la cuantización puedan realizarse plenamente en arquitecturas especializadas de NPU (Unidad de Procesamiento Neuronal).
Qué dicen los lectores de Hacker News
- Alternativa: Un comentarista expresó su preferencia por usar GitHub en lugar de las páginas oficiales de productos porque permite una navegación más fácil y acceso directo al código. comentario ↗
- Escéptico: Otro usuario planteó preocupaciones sobre la fiabilidad del alojamiento de terceros para los productos de Huawei, sugiriendo que el contenido en plataformas fuera de China podría ser eliminado en cualquier momento. comentario ↗
Resumen de opiniones del hilo de Hacker News; no son hechos verificados. Leer el debate completo ↗