En las pruebas de rendimiento realizadas en un sistema Apple M1, el algoritmo blqsort ordenó 50 millones de doubles aleatorios en 0.68 segundos, superando a std::sort de la biblioteca estándar de C++, que tardó 1.33 segundos. Esta ganancia de rendimiento se debe a una serie de optimizaciones diseñadas para minimizar las interrupciones en el pipeline de la CPU y manejar distribuciones de datos específicas de manera más eficiente que las implementaciones de ordenamiento de propósito general.
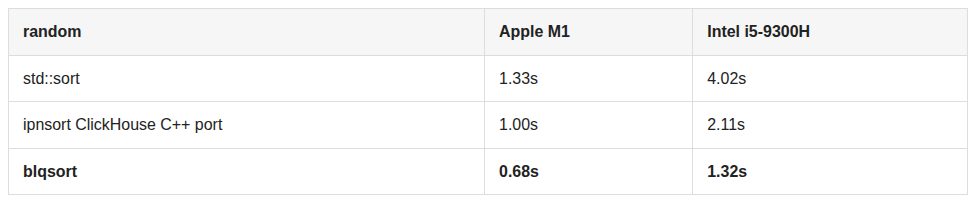
Esta tabla proporciona la evidencia empírica de las ganancias de rendimiento mencionadas en la introducción.
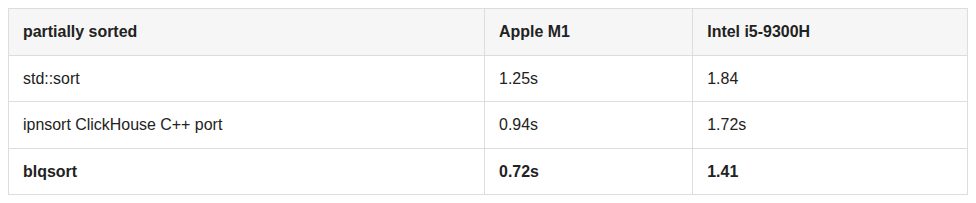
Esta visualización apoya la discusión sobre cómo blqsort maneja diferentes distribuciones y tamaños de datos.
Eliminando errores de predicción de ramificaciones
Las implementaciones estándar de quicksort a menudo dependen de condiciones 'if' para particionar los datos. En las CPUs modernas, si los datos están distribuidos aleatoriamente, estas condiciones se vuelven impredecibles para el predictor de ramificaciones, obligando al procesador a vaciar su pipeline y reiniciar la ejecución.
blqsort aborda esto utilizando un enfoque sin ramificaciones. En lugar de un salto condicional, utiliza una instrucción de incremento condicional para mover los elementos. Si bien esto introduce una escritura de memoria incondicional para cada elemento, el autor señala que la sobrecarga de la escritura es significativamente menor que la pérdida de rendimiento causada por los frecuentes errores de predicción de ramificaciones.
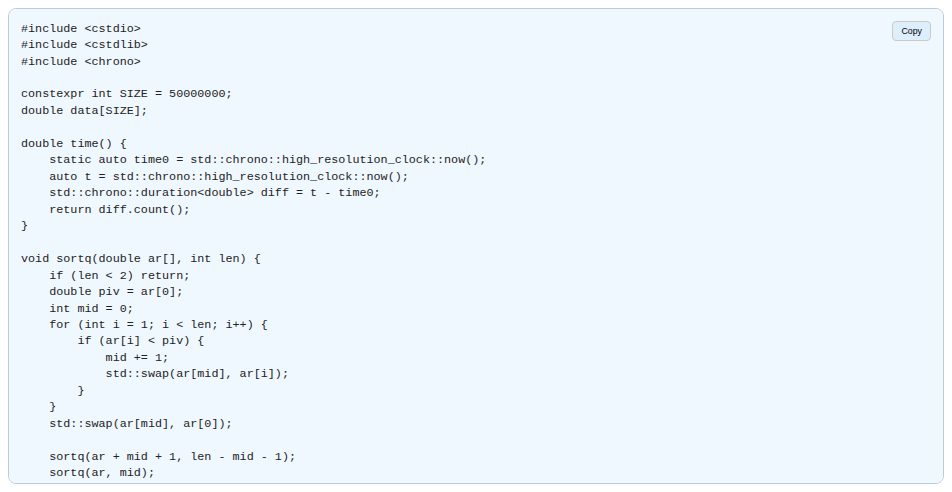
Este fragmento de código ilustra la transición de la lógica condicional estándar a la estructura optimizada de blqsort.
“Los conceptos clave de blqsort son el particionamiento sin ramificaciones, las redes de ordenamiento para particiones pequeñas y una buena selección de pivotes.”
— A Fast Quicksort
Redes de ordenamiento para particiones pequeñas
Para particiones muy pequeñas, como aquellas con menos de 20 elementos, el quicksort tradicional es menos eficiente que métodos más simples. blqsort reemplaza estos con redes de ordenamiento, que utilizan una secuencia fija de comparaciones e intercambios para ordenar los elementos.
La implementación incluye una lógica específica para tamaños de partición de hasta 16. Al utilizar estas redes, el algoritmo evita la sobrecarga de las llamadas recursivas y proporciona una ruta altamente optimizada para los 'casos base' del proceso de ordenamiento.
Selección de pivotes y manejo de casos límite
Para mantener un alto rendimiento en diferentes tipos de datos, blqsort emplea un proceso de selección de pivotes de múltiples pasos. Determina varias medianas de la partición para calcular una mediana final, asegurando una distribución de datos más uniforme durante el paso de particionamiento.
El algoritmo también incluye salvaguardias para entradas difíciles. Si la distribución de los datos sigue siendo desigual —a menudo debido a muchos elementos idénticos— el sistema cambia a heap sort. Además, identifica y agrupa claves duplicadas para mantener la eficiencia.
Compensaciones de rendimiento y limitaciones
La principal compensación por la velocidad de blqsort es el uso de lógica sin ramificaciones, lo que requiere que el compilador realice escrituras en memoria incluso cuando no se cumple la condición. El compilador no puede optimizar esto automáticamente a una escritura condicional porque no puede garantizar que dicha escritura sea segura para el búfer asignado.
Si bien blqsort supera a std::sort en datos aleatorios, su ventaja relativa varía según la arquitectura. Por ejemplo, en sistemas x86, se observó que la brecha de rendimiento entre blqsort y std::sort fue de aproximadamente un 10%.
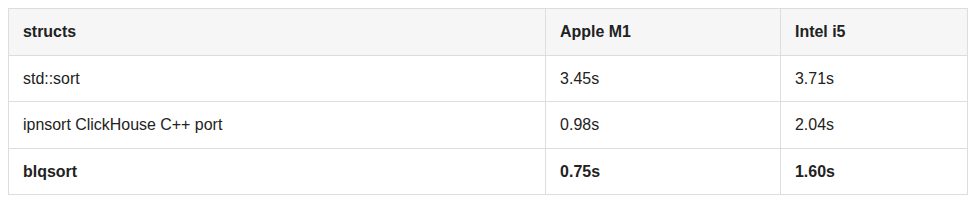
Esta tabla ilustra las compensaciones de rendimiento y las variaciones arquitectónicas discutidas en la sección final.
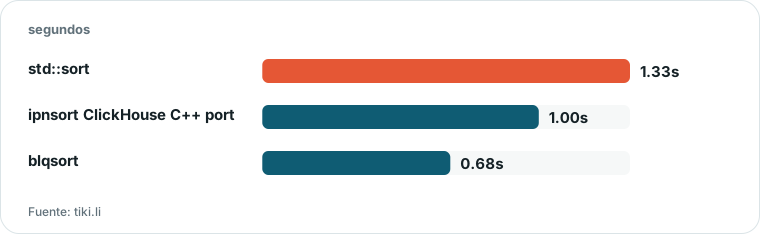
Gráfico elaborado por HN Digest a partir de cifras reportadas por tiki.li; los valores se muestran como en la fuente.
Qué dicen los lectores de Hacker News
- Alternativa: Un comentarista sugirió que el radix sort puede ser excepcionalmente rápido para ordenamientos específicos porque realiza escaneos simples sobre los datos con una excelente localidad de referencia. comentario ↗
- Escéptico: Un comentarista expresó escepticismo respecto a las ganancias de rendimiento, argumentando que para muchos problemas, las operaciones de entrada/salida dominan el tiempo de ejecución más que el propio algoritmo de ordenamiento. comentario ↗
- Nota técnica: Otro usuario señaló que la eficiencia de quicksort se debe en gran medida a sus requisitos de espacio O(log n), distinguiéndolo de algoritmos como el merge sort. comentario ↗
Resumen de opiniones del hilo de Hacker News; no son hechos verificados. Leer el debate completo ↗