Unsloth ha lanzado un nuevo algoritmo de cuantización Dynamic V3.1 que mejora la precisión del modelo Qwen3.8-27B entre un 5-10% en los principales benchmarks sin aumentar la huella del modelo. Esta actualización se dirige específicamente al rango de cuantización de 2 bits a 6 bits, proporcionando una opción de alto rendimiento para usuarios que ejecutan modelos densos localmente para tareas de visión, razonamiento y codificación agéntica.
Ganancias de precisión mediante Dynamic V3.1
La actualización Dynamic V3.1 proporciona un salto significativo en la precisión para el modelo Qwen3.8-27B, que es un modelo denso con capacidades de visión y razonamiento. Unsloth informó que estas mejoras son consistentes en la mayoría de los benchmarks, incluidos LiveCodeBench v6, GPQA Diamond y MMLU-Pro.

El artículo analiza las capacidades de visión y razonamiento del modelo Qwen3.8-27B, que son accesibles a través de la interfaz Unsloth Desktop.
Aunque la mayoría de las quants de 2 bits a 6 bits fueron actualizadas, Unsloth optó por mantener las quants UD3 de 3 bits ya que funcionaron al mismo nivel que el nuevo algoritmo V3.1. La actualización fue validada utilizando longitudes de contexto de 256K para benchmarks agénticos y 128K para benchmarks generales.
“Los GGUFs de Qwen3.8-27B ahora utilizan Unsloth Dynamic V3.1, que mejora la precisión promedio entre un 5-10% en tamaños comparables, incluyendo Terminal Bench, DeepSWE y más benchmarks.”
— Qwen3.8 - How to Run Locally | Unsloth Documentation
Optimizaciones para cargas de trabajo agénticas
Más allá de la precisión bruta, las nuevas quants están optimizadas para herramientas agénticas como Codex. Incluyen soporte para roles de desarrollador y una mejora en el análisis de objetos anidados, lo que ayuda a que las herramientas tengan éxito con mayor frecuencia durante tareas complejas.

La actualización incluye una mejora en el análisis de objetos anidados para ayudar a las herramientas agénticas a tener éxito durante tareas complejas.
Los modelos también admiten Multi-Token Prediction (MTP) para facilitar una inferencia más rápida. Para los usuarios que requieren un razonamiento de alta velocidad, el modelo Qwen3.8-27B admite diferentes niveles de esfuerzo de razonamiento—xhigh, medium, low o none—para equilibrar la precisión y la velocidad.
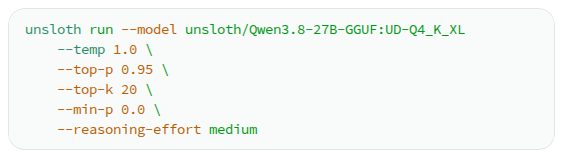
El artículo menciona que las nuevas quants están optimizadas para herramientas agénticas e inferencia de alto rendimiento.
Requisitos de hardware y compensaciones
Ejecutar estos modelos localmente implica compensaciones de hardware específicas dependiendo del nivel de cuantización elegido. Por ejemplo, las quants de 4 bits están diseñadas para funcionar en configuraciones de 16-19GB de VRAM, como una RTX 5080 o un Mac con 24GB de memoria unificada.
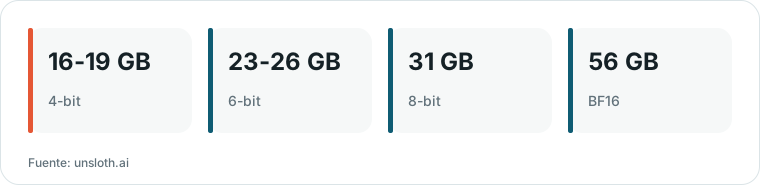
Gráfico elaborado por HN Digest a partir de cifras de unsloth.ai; los valores se muestran como en la fuente.
Para el máximo rendimiento, Unsloth lanzó quants NVFP4 que se ejecutan aproximadamente 1.5x más rápido que los checkpoints BF16. Sin embargo, estas quants específicas requieren GPUs NVIDIA Blackwell, como la serie RTX 50X, para lograr las aceleraciones anunciadas.
Discrepancias en los benchmarks
Unsloth abordó las discrepancias en los benchmarks externos, específicamente con respecto a los resultados de GSQ-RCO para LiveCodeBench. Señalaron que, aunque algunos informes sugerían que sus quants funcionaban peor, esas pruebas probablemente utilizaron un presupuesto de contexto de 96K.
Las pruebas de Unsloth utilizaron un presupuesto de contexto de 128K, donde sus quants UD3 superaron a la competencia. También señalaron que el no determinismo de la GPU significa que los benchmarks deben ejecutarse varias veces para garantizar resultados fiables.
Qué dicen los lectores de Hacker News
- Alternativa: Un comentarista señaló que, si bien Unsloth es más aplicable a modelos estándar, Bonsai 2 ofrece un ajuste adicional para empaquetar más parámetros en tamaños más pequeños. comentario ↗
- Experiencia: Un usuario informó haber ejecutado con éxito el modelo en un Mac mini M4, logrando velocidades que consideró aceptables para uso local. comentario ↗
- Experiencia: Un comentarista compartió su experiencia ejecutando un modelo de 27B en modo solo CPU, señalando que, aunque era muy lento, era capaz de procesar archivos grandes durante la noche. comentario ↗
Resumen de opiniones del hilo de Hacker News; no son hechos verificados. Leer el debate completo ↗