La arquitectura Zen 6 de AMD logra una mejora generacional sobre Zen 5 al duplicar el número de unidades VNNI a cuatro por ciclo y permitir que un solo hilo utilice ambos clústeres de decodificación del núcleo. Estos cambios, combinados con una nueva variante 'Zen 6c', señalan un cambio en la estrategia de AMD hacia la especialización de diseños de núcleos para diferentes comportamientos de carga de trabajo, en lugar de simplemente escalar el mismo núcleo a diferentes densidades.
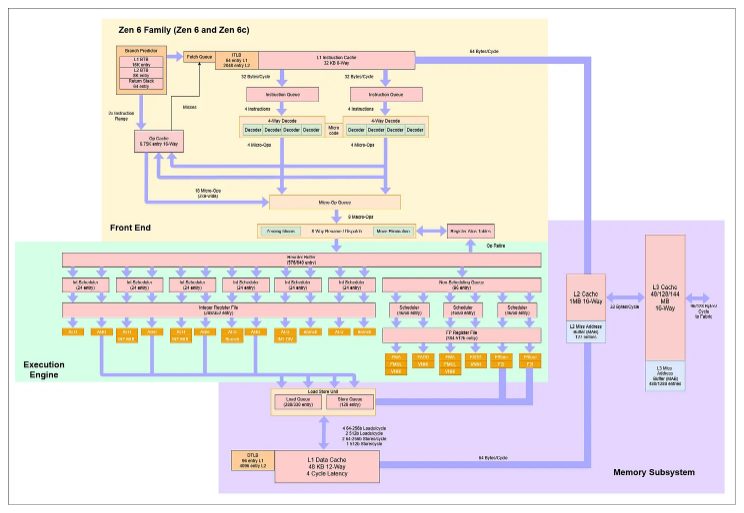
Esta figura proporciona una visión general de alto nivel de la arquitectura Zen 6 y su filosofía de diseño de núcleos.
Mejoras en el Frontend y la Predicción de Ramas
Zen 6 se basa en el predictor de dirección de Zen 5 pero mejora la capacidad del núcleo para recuperarse de las predicciones erróneas. Mientras que Zen 5 tardaba aproximadamente entre 3.5 y 4 ns en recuperarse de una suposición incorrecta, Zen 6 reduce esta penalización a entre 3 y 3.5 ns.
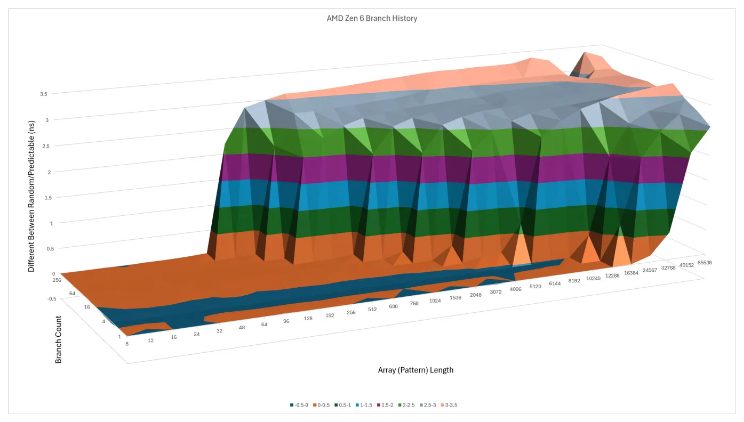
El gráfico ilustra la mejora específica en los tiempos de recuperación de la predicción de ramas mencionada en el texto.
Se produce un cambio arquitectónico significativo en la etapa de obtención de instrucciones. A diferencia de Zen 5, donde un solo hilo solo podía utilizar eficazmente un clúster de decodificación, Zen 6 permite que un solo hilo utilice ambos clústeres simultáneamente, aumentando el rendimiento potencial de las instrucciones.
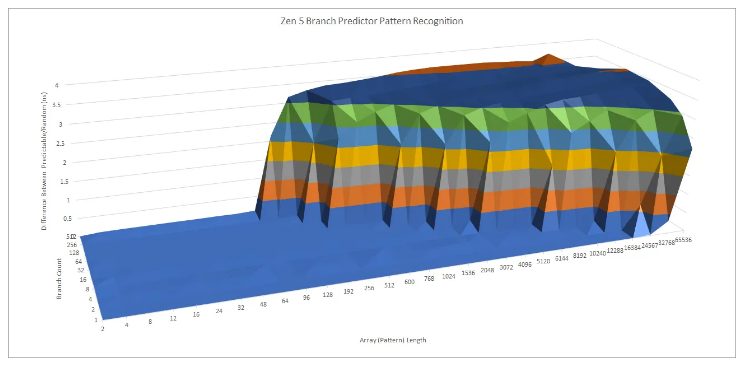
Esta imagen apoya la descripción del cambio arquitectónico en la etapa de obtención de instrucciones.
“Las diferencias sugieren que AMD está especializando los dos diseños. Zen 6 parece ajustado para una alta frecuencia, mientras que Zen 6c tiene más capacidad para tolerar una latencia de memoria comparativamente alta.”
— AMD’s Zen 6 Family: Feeding the Beast
Motor de Ejecución y Rendimiento Vectorial
En el lado de los enteros, Zen 6 vuelve a un comportamiento de emparejamiento NOP de estilo Zen 4, permitiendo que el núcleo retire hasta 16 NOPs por ciclo. También mejora el rendimiento máximo teórico para sumas simples de 64 bits, alcanzando 5.96 por ciclo en comparación con los 5.25 de Zen 5.
AMD redujo el número de unidades de multiplicación de enteros de tres a dos, citando que la tercera unidad no justificaba su coste de área. Por el contrario, el lado vectorial experimenta un gran impulso en las unidades VNNI, que son críticas para la inferencia de IA y los códecs de vídeo, duplicándose de dos a cuatro unidades por ciclo.
La división arquitectónica entre Zen 6 y Zen 6c
Por primera vez, los núcleos 'Classic' y 'Dense' difieren dentro del motor fuera de orden. Zen 6 está ajustado para una alta frecuencia, mientras que Zen 6c está diseñado para absorber la latencia aumentando la capacidad de las estructuras internas.
Zen 6c cuenta con un búfer de reordenamiento más grande (640 frente a 576 entradas), un archivo de registros de enteros más grande (352 frente a 288) y una cola de carga más grande (330 frente a 280). Estos cambios permiten que Zen 6c mantenga más trabajo 'en vuelo' para enmascarar los efectos del acceso lento a la memoria.
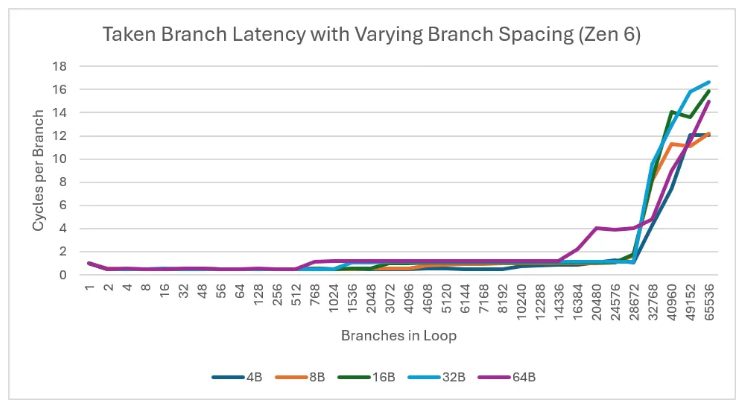
Esta figura representa visualmente las diferencias de capacidad que permiten a Zen 6c enmascarar la latencia de memoria.
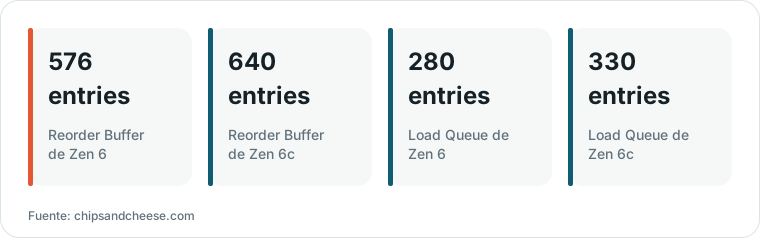
Gráfico de HN Digest basado en cifras de chipsandcheese.com; los valores se muestran como en la fuente.
Compensaciones de rendimiento y escalado de memoria
El EPYC 9686F (Zen 6) supera al 9996 (Zen 6c) en tasas brutas de enteros y punto flotante porque puede mantener velocidades de reloj más altas. Sin embargo, la caché L3 de 128 MB del 9996 le ayuda a mantener menores proporciones de interrupciones por memoria en cargas de trabajo pesadas como 'fotonik3d' y 'lbm'.
La latencia de L3 ha aumentado en toda la familia, alcanzando 55 ciclos en Zen 6 y 66 ciclos en Zen 6c. Si bien el reloj más alto en Zen 6 oculta gran parte de este aumento, la caché más grande en Zen 6c sirve como mecanismo principal para reducir la necesidad de acceder a la memoria principal.
Qué dicen los lectores de Hacker News
- Nota técnica: Un comentarista señaló que el aumento de las estructuras fuera de orden en la variante Zen 6c parece ser un movimiento estratégico para absorber la latencia de memoria a medida que las cargas de trabajo se vuelven más dependientes de la memoria. comentario ↗
- Nota técnica: Un lector expresó curiosidad sobre la reducción de los multiplicadores de enteros y el rendimiento de PDEP/PEXT, cuestionando si estas operaciones comparten el mismo circuito o representan recortes de hardware independientes. comentario ↗
- Escéptico: Varios comentaristas discutieron las limitaciones del ancho de banda de memoria, y un observador señaló que muchas aplicaciones están limitadas por la E/S en lugar de por el cómputo, mientras que otro argumentó que reducir la latencia de memoria es más crítico que aumentar el ancho de banda. comentario ↗
- Nota técnica: Un comentarista planteó una pregunta abierta sobre la gestión arquitectónica de 32 núcleos en un solo CCD, preguntando específicamente si habrá unidades lógicas más pequeñas entre el CCD y los núcleos individuales. comentario ↗
Resumen de opiniones del hilo de Hacker News; no son hechos verificados. Leer el debate completo ↗