Al asignar a agentes de IA la tarea de reescribir el código interno en C de CPython en Lean —un lenguaje diseñado para pruebas matemáticas verificadas por máquinas—, los investigadores han descubierto 418 errores en el intérprete de Python. Este proceso de formalización, que ya ha producido más de 600,000 líneas de código verificado, identifica problemas críticos que las pruebas tradicionales podrían pasar por alto al forzar una definición matemática precisa de cómo se comporta Python en casos límite 'extraños'.
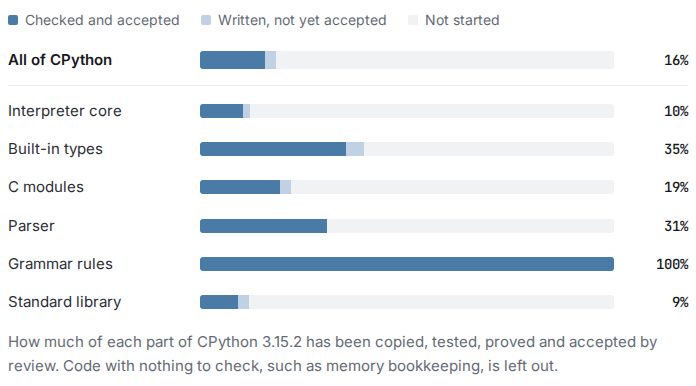
Este gráfico visualiza el alcance y el progreso de los esfuerzos de formalización del proyecto en toda la base de código de CPython.
El flujo de trabajo de formalización
El proyecto sigue un riguroso flujo de trabajo de cuatro pasos para asegurar que el modelo Lean refleje con precisión el código fuente de CPython. Primero, los agentes de IA reescriben las funciones C en Lean, preservando la lógica exacta, incluyendo mensajes de error y desbordamientos de enteros. Segundo, estas copias se ejecutan en paralelo con el intérprete real de Python en al menos 50,000 entradas para asegurar que coincidan.
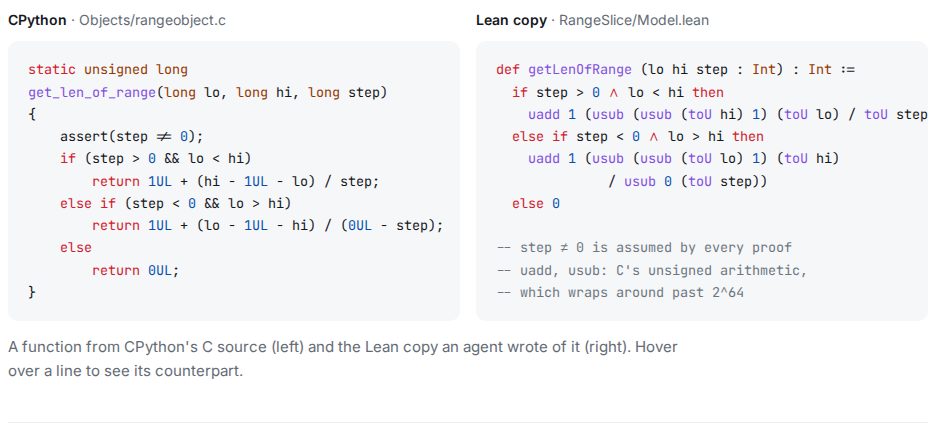
Esta imagen ilustra el primer paso del flujo de trabajo donde los agentes de IA reescriben el código C en Lean preservando la lógica exacta.
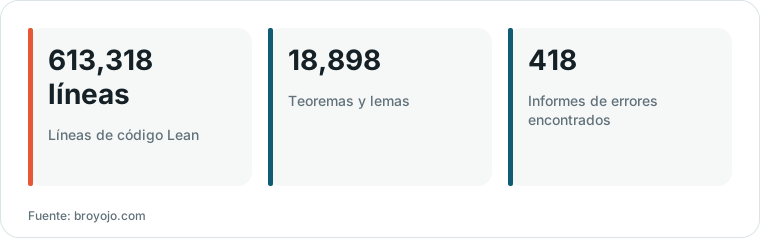
Gráfico elaborado por HN Digest a partir de las cifras de broyojo.com; los valores se muestran como en la fuente.
Tercero, el equipo establece propiedades que siempre deberían ser verdaderas y utiliza el verificador de pruebas de Lean para validarlas. Finalmente, un segundo agente de IA que no escribió el modelo original revisa el trabajo para asegurar que sea 'fiel' a la fuente. Solo las funciones que sobreviven a esta revisión independiente se cuentan como aceptadas.
“Escribir una prueba sobre una función te obliga a decir exactamente qué hace en todos esos casos. No puedes dejar nada vago, porque el verificador de pruebas no lo aceptará.”
— Formalizing CPython
Identificación de errores ocultos
Debido a que una prueba formal requiere una definición precisa de cada estado posible, el proceso reveló errores donde el comportamiento de CPython se desviaba de su lógica prevista. Por ejemplo, el equipo encontró una llamada a un diccionario que causa un fallo de segmentación cuando se utiliza una clave específica en el diccionario de atributos de un objeto.
Otros hallazgos incluyen corrupción de memoria en ediciones de XML y un decodificador base32 que produce un relleno incorrecto dependiendo de la posición de los caracteres ignorados. El proyecto también identificó una discrepancia entre las versiones en C y en Python puro del módulo pickle, que se rinden a diferentes profundidades de anidamiento.
El desafío de las pruebas 'útiles'
Un obstáculo significativo fue evitar que la IA generara pruebas 'huecas': afirmaciones que son técnicamente verdaderas pero que no logran detectar código defectuoso. Por ejemplo, una prueba que declare 'si la función devuelve un valor, el resultado es al menos cero' es técnicamente correcta incluso si la función siempre colapsa.
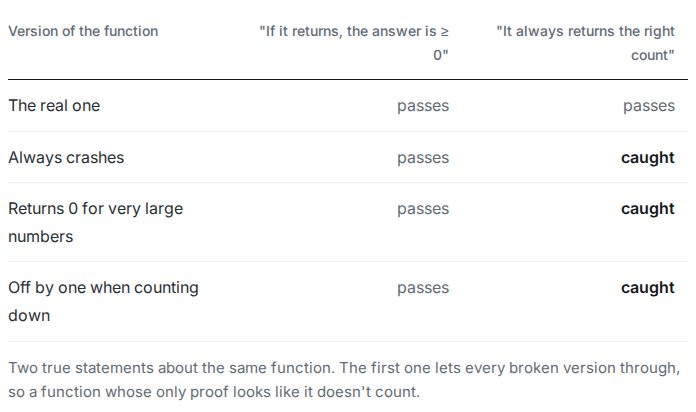
Esta imagen explica el concepto de pruebas 'huecas' donde una afirmación es técnicamente correcta pero no logra identificar errores funcionales.
Para resolver esto, los revisores ahora hacen una pregunta específica: '¿podría una versión defectuosa de la función pasarla también?'. Si una versión defectuosa la pasa, la prueba es rechazada. Esto obliga al modelo a ser más realista, como contabilizar solicitudes de memoria que podrían fallar o código de usuario que lanza errores en medio de una operación.
Limitaciones y compensaciones
Si bien la verificación formal proporciona una alta confianza, actualmente está limitada a una pequeña fracción de la base de código. El proyecto ha cubierto aproximadamente el 15.7% de las funciones en el alcance, ya que modelar cada caso límite complejo en una base de código masiva y antigua como CPython requiere mucho esfuerzo.
Además, una prueba verificada solo garantiza que una afirmación se deriva del modelo Lean, no necesariamente del intérprete real de Python. Si el modelo mismo es incompleto —como asumir que las solicitudes de memoria siempre tienen éxito cuando podrían no serlo— la prueba puede seguir siendo válida mientras el software real sigue teniendo errores.
Qué dicen los lectores de Hacker News
- Nota técnica: Un comentarista señaló que Lean solo puede verificar código Lean en lugar de código arbitrario, sugiriendo que la información podría perderse durante la traducción. Sugirieron que sistemas como Z3 podrían ser más apropiados para verificar implementaciones reales. comentario ↗
- Escéptico: Varios comentaristas expresaron escepticismo respecto a la metodología, sugiriendo que el proceso dependía demasiado de los prompts de IA en lugar de una verificación manual rigurosa o una comprensión profunda del sistema de verificación formal. comentario ↗
Resumen de opiniones del hilo de Hacker News; no son hechos verificados. Leer el debate completo ↗