Los modelos actuales de inteligencia artificial son significativamente menos eficientes en el aprendizaje que los humanos, exhibiendo una brecha de eficiencia de muestras de aproximadamente 10,000,000x. Mientras que los humanos poseen aproximadamente 100 billones de parámetros y aprenden de solo 200 millones de tokens, los modelos de IA actuales, como aquellos que siguen la prescripción de Chinchilla, utilizan una proporción de tokens por parámetro de 20:1. Para cerrar esta brecha, investigadores en Q sugieren que los modelos deben escalarse en siete órdenes de magnitud, alcanzando potencialmente la escala de cuatrillones de parámetros.
Más allá del escalado de tamaño fijo
Las leyes de escalado estándar, como la prescripción de Chinchilla, sugieren un tamaño de modelo fijo para un conjunto de datos fijo, específicamente 20 tokens por parámetro. Sin embargo, a medida que el suministro de datos de entrenamiento de alta calidad se convierte en un cuello de botella, los modelos se entrenarán cada vez más en un régimen de múltiples épocas y datos limitados.
La nueva investigación encuentra que cuando el conjunto de datos se mantiene fijo, el tamaño del modelo óptimo en términos de cómputo continúa creciendo a medida que aumenta el presupuesto de cómputo. En este régimen, los investigadores encontraron que el ensamble debería mantener más de 300 parámetros por token a 10^29 FLOPs, un aumento masivo sobre las prescripciones anteriores.
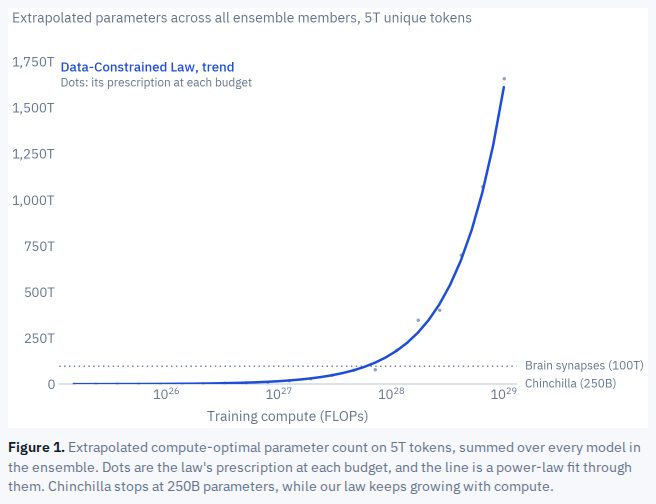
Esta figura visualiza el hallazgo central de que el tamaño del modelo debe crecer significativamente más que las prescripciones anteriores cuando se entrena en un conjunto de datos fijo.
“La brecha de tokens por parámetro entre la IA y los humanos es de 10,000,000x, y un paso importante hacia adelante para la brecha de eficiencia de muestras puede ser cerrarla.”
— Quadrillion-parameter transformers and how to train them – Q
Escalado de hiperparámetros y decaimiento de peso
Un hallazgo crítico de la nueva ley es cómo los hiperparámetros deben adaptarse a modelos más grandes entrenados durante múltiples épocas. Las leyes anteriores de datos limitados mantenían el decaimiento de peso fijo, lo que llevó a aumentos previstos en la pérdida a medida que el cómputo crecía.
Los investigadores ajustaron leyes de potencia que muestran que el decaimiento de peso óptimo crece abruptamente tanto con las épocas como con el tamaño del modelo. Su ley permanece cerca de la óptima a 16x el cómputo ajustado, mientras que las heurísticas previas no logran explicar la interacción entre estas variables.
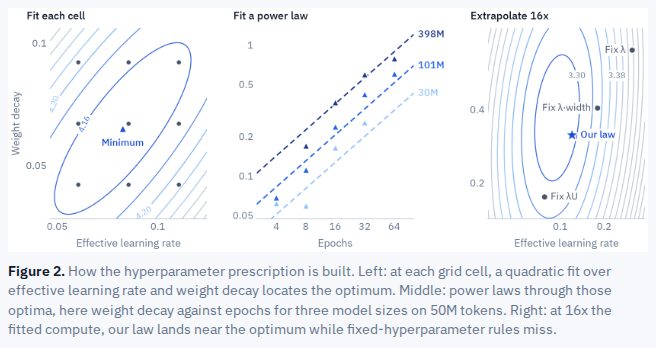
El gráfico explica la metodología para ajustar leyes de potencia a los hiperparámetros, que es un componente crítico de la nueva ley de escalado.
El ensamble como eje de escalado
Para mejorar aún más la eficiencia de muestras, los investigadores integraron el ensamble como un eje de escalado de primera clase. Utilizaron el 'ensamble de instantáneas', que guarda puntos de control de una sola ejecución de entrenamiento y promedia sus predicciones, proporcionando una ganancia en el rendimiento sin cómputo de entrenamiento adicional.
Para presupuestos de cómputo muy grandes en relación con el conjunto de datos, la ley sugiere asignar cómputo extra al 'ensamble profundo' (deep ensembling), entrenando modelos independientes con diferentes semillas. Este enfoque reduce el sobreajuste y permite que la pérdida continúe cayendo a medida que aumenta el cómputo, un punto donde las recetas anteriores eventualmente ven una degradación del rendimiento.
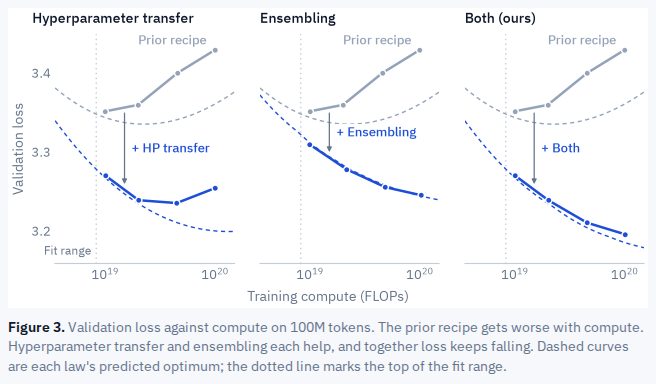
Esta visualización respalda la afirmación de que el ensamble actúa como un eje de escalado de primera clase para mejorar la eficiencia de muestras.
El camino hacia los cuatrillones de parámetros
El objetivo final de estas leyes de escalado es alcanzar la escala de cuatrillones de parámetros para igualar la eficiencia de aprendizaje similar a la humana. Si bien la investigación actual proporciona las prescripciones matemáticas para alcanzar estos tamaños en conjuntos de datos limitados, los autores señalan que la transición requerirá avances significativos en hardware y algoritmos.
Los modelos actuales son aproximadamente siete órdenes de magnitud demasiado pequeños para igualar la eficiencia del cerebro humano. Cerrar esta brecha representa un cambio fundamental en cómo se diseñan y entrenan los modelos transformer.
Qué dicen los lectores de Hacker News
- Alternativa: Un comentarista argumentó que comparar el aprendizaje humano con el entrenamiento de transformers es defectuoso porque los humanos poseen fuertes sesgos inductivos de la evolución en lugar de comenzar con pesos inicializados aleatoriamente. comentario ↗
- Escéptico: Otro comentarista expresó escepticismo con respecto a las cifras de datos utilizadas para el aprendizaje humano, sugiriendo que los humanos reciben significativamente más datos a través de sentidos como la visión y el tacto. comentario ↗
- Pregunta abierta: Un comentarista planteó una pregunta sobre la viabilidad de tokenizar fácilmente las entradas complejas que recibe el cerebro humano. comentario ↗
Resumen de opiniones del hilo de Hacker News; no son hechos verificados. Leer el debate completo ↗