Los investigadores han identificado un fallo fundamental en el entrenamiento estándar de Predicción de Múltiples Tokens (MTP), donde un componente 'residual' del gradiente interfiere tanto con el aprendizaje del siguiente token como con el de múltiples tokens, un problema que empeora a medida que los modelos escalan. Al introducir Soft-MTP, un cambio de código de una sola línea, pueden aislar una señal útil de auto-destilación KL de este ruido, lo que resulta en una menor perplejidad y una decodificación especulativa más rápida en varios tamaños de modelo.
El fallo en el entrenamiento MTP estándar
La Predicción de Múltiples Tokens (MTP) es una técnica común utilizada para mejorar el rendimiento posterior y permitir una inferencia más rápida a través de la decodificación especulativa. Sin embargo, el entrenamiento MTP estándar sufre de un problema de descomposición de gradientes: el gradiente de entropía cruzada contiene un término útil de auto-destilación KL y un residuo con una baja relación señal-ruido.
Este residuo ruidoso oculta la señal KL útil, dificultando la capacidad del modelo para aprender de manera efectiva. La interferencia se vuelve cada vez más problemática a medida que aumenta el tamaño del modelo, creando un cuello de botella para escalar las capacidades de MTP.
“Soft-MTP es, en efecto, un almuerzo gratis para la optimización de MTP.”
— Multi-Token Prediction Done Right
El truco de recuperación de gradiente KL
Soft-MTP aborda esto mediante la implementación de un 'truco de recuperación de gradiente KL'. Cuando dos distribuciones comparten un cabezal de salida lineal, el gradiente de su divergencia KL puede recuperarse exactamente combinando sus gradientes de entropía cruzada a través del enrutamiento de gradientes straight-through.
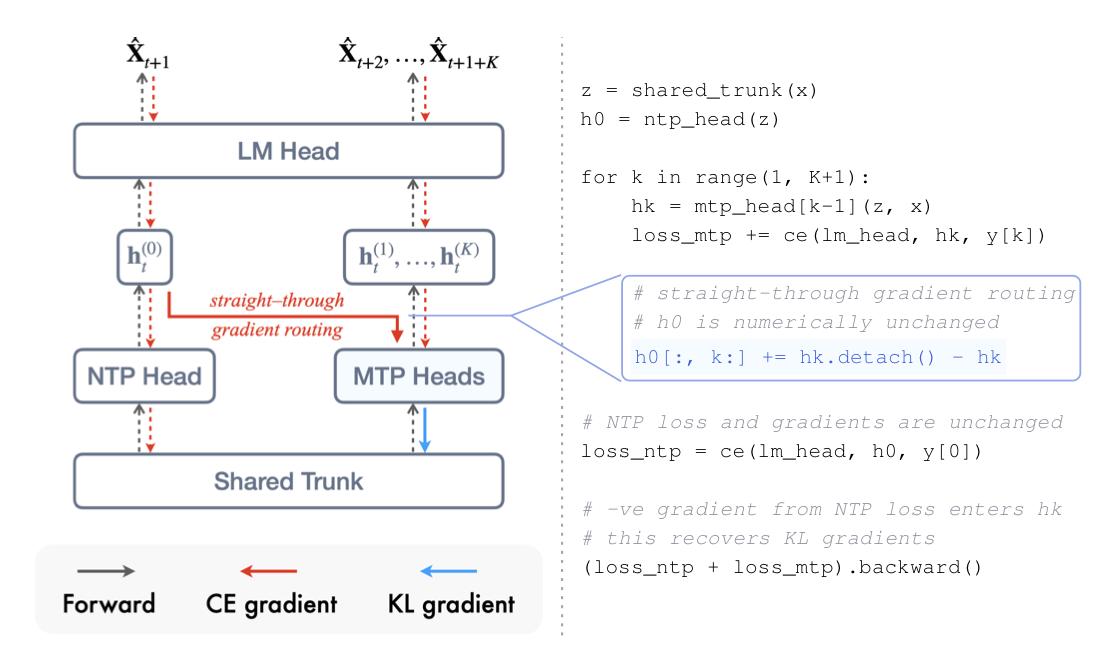
Esta figura ilustra el mecanismo central de Soft-MTP, específicamente cómo maneja el enrutamiento de gradientes para mejorar el entrenamiento de predicción de múltiples tokens.
Este enfoque es computacionalmente eficiente porque no requiere las masivas matrices de logits del tamaño del vocabulario que normalmente se necesitan para la minimización directa de la divergencia KL. Es compatible con los kernels de entropía cruzada fusionados estándar, lo que lo convierte en un 'almuerzo gratis' para la optimización.
La implementación es un cambio de función única que admite arquitecturas MTP de estilo DeepSeek y Meta. Reutiliza los cálculos de entropía cruzada de NTP y MTP existentes para propagar hacia atrás solo la señal de auto-destilación KL deseada.
Ganancias de rendimiento y compensaciones
Las pruebas en modelos que van desde 167M hasta 1.2B de parámetros muestran que Soft-MTP supera consistentemente al MTP estándar. Las mejoras clave incluyen una menor perplejidad de predicción del siguiente token (NTP) y una mayor precisión zero-shot en todas las escalas probadas.
Para modelos más grandes (689M de parámetros y superiores), Soft-MTP también logra una menor perplejidad de MTP. Además, el método demuestra capacidades superiores de razonamiento matemático y de código tras el ajuste fino.
Si bien Soft-MTP iguala o supera la minimización directa de la divergencia KL en la mayoría de las métricas, la magnitud específica de la interferencia del 'residuo ruidoso' y los valores exactos para todas las métricas no se detallan completamente en el informe principal.