La memoria actual de los agentes de IA está fragmentada en al menos cuatro formatos distintos, que van desde archivos Markdown como `CLAUDE.md` hasta grafos de conocimiento JSONL y hechos en repositorios alojados. Debido a que estos formatos son incompatibles, una lección aprendida por un agente de CI en una herramienta no puede ser accedida por un agente de edición en otra, creando una experiencia aislada para los desarrolladores que utilizan múltiples herramientas de IA.
La fragmentación de la memoria de los agentes
A medida que el ecosistema de agentes de IA crece, los desarrolladores están construyendo capas de memoria personalizadas con esquemas y métodos de almacenamiento únicos. Estos incluyen archivos locales, almacenes con espacios de nombres y grafos de conocimiento temporales, pero ninguno de estos sistemas puede comunicarse nativamente entre sí.
El autor de LoreKit sostiene que el problema no es la falta de herramientas, sino la falta de un acuerdo compartido. Sin un modelo de datos común, cada nueva solución añade otro formato aislado que impide el intercambio de contexto entre herramientas.
El modelo de OpenTelemetry
La propuesta establece un paralelo directo con la industria de la observabilidad. Antes de 2019, diferentes proveedores enviaban bibliotecas de instrumentación y formatos de datos propietarios, obligando a los usuarios a re-instrumentar el código al cambiar de proveedor.
La industria resolvió esto fusionándose en OpenTelemetry, que estandarizó qué es un span, una métrica y un registro de log, junto con nombres compartidos (convenciones semánticas) y un protocolo común (OTLP). Esto permitió que todo un ecosistema de herramientas pudiera leer los datos de otras mientras seguían compitiendo en almacenamiento y análisis.
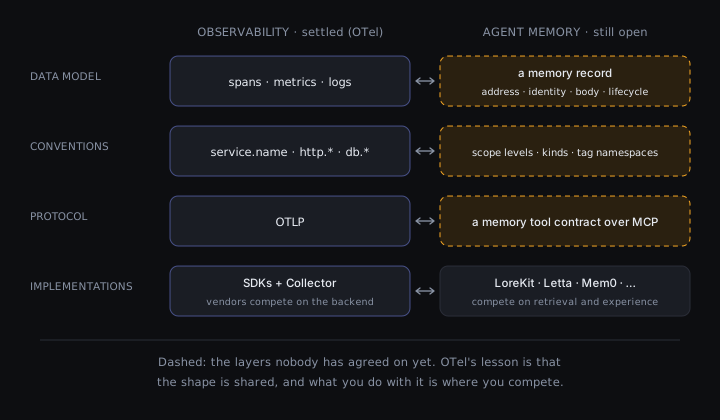
El artículo explica cómo la propuesta establece un paralelo directo con el movimiento de la industria de la observabilidad hacia OpenTelemetry para resolver la fragmentación.
La memoria de los agentes se encuentra actualmente en un estado similar, donde los formatos son lo suficientemente jóvenes como para ser estandarizados antes de que se vuelvan inamovibles.
Exportación frente a dirección en vivo
La propuesta distingue entre dos problemas principales: la 'exportación' y la 'dirección en vivo'. La exportación se refiere a mover la memoria de un usuario de un proveedor a otro, algo que varios borradores existentes, como el Open Memory Protocol, intentan resolver.
La dirección en vivo es el desafío más complejo de permitir que un trabajo de CI, un agente de edición y un bot de revisión trabajen en el mismo repositorio al mismo tiempo. Una especificación compartida proporcionaría una 'dirección' común (por ejemplo, un repositorio o rama específica) donde estas herramientas puedan acordar qué significa un registro de memoria en tiempo real.
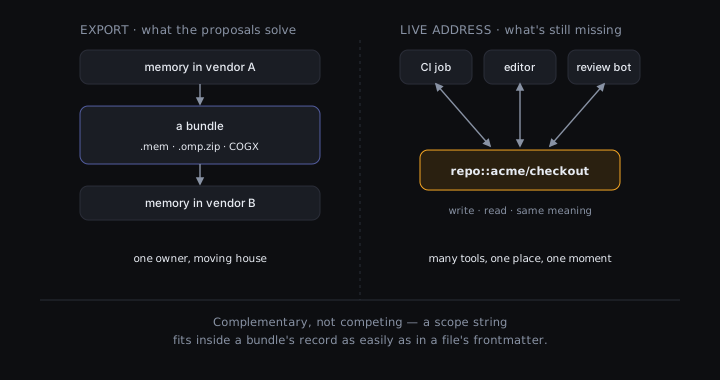
Esta visualización aclara los dos problemas principales discutidos: mover datos entre herramientas frente al acceso compartido en tiempo real.
Arquitectura propuesta y compensaciones
Un registro propuesto incluiría un ID único, un alcance (dirección), una clave, un ciclo de vida (caducidad) y un campo 'written_by' para identificar si un humano o un agente creó la memoria. Esta estructura permite a las herramientas decidir cuánto confiar en la información basándose en su origen.
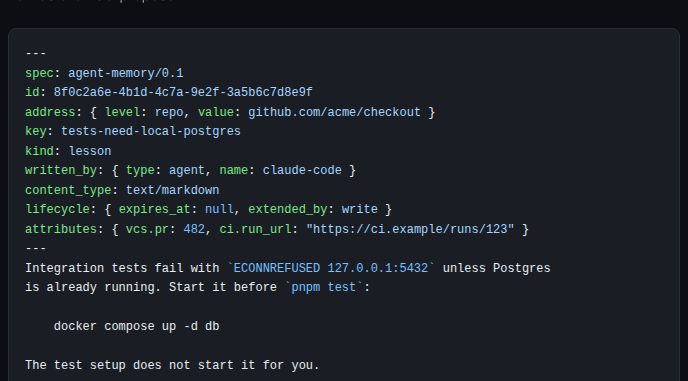
El artículo describe los campos específicos que un registro propuesto incluiría para facilitar la interoperabilidad.
Los críticos señalan que un estándar compartido podría ser una 'abstracción prematura' o un riesgo de inyección de prompts. La propuesta sugiere mitigar estos riesgos incluyendo firmas y vinculando los registros a versiones de código específicas, aunque sigue siendo una pregunta abierta qué niveles de dirección (por ejemplo, repositorio frente a rama) deberían ser estándar.
Qué dicen los lectores de Hacker News
- Escéptico: Un comentarista argumentó que estandarizar una abstracción ahora podría ser prematuro porque la industria aún no comprende completamente la mejor manera de abordar el contexto y la duración de la memoria. comentario ↗
- Escéptico: Varios comentaristas expresaron escepticismo sobre la necesidad de un formato unificado, señalando que los agentes ya son capaces de leer y recorrer varios formatos de archivo para recuperar contexto. comentario ↗
- Experiencia: Un usuario compartió su experiencia de desactivar la memoria del agente por completo porque a menudo recuerda información incorrecta, prefiriendo en su lugar que el agente registre hallazgos específicos en archivos. comentario ↗
- Experiencia: Otro comentarista sugirió que el mejor enfoque es proporcionar al agente un directorio estándar y reglas mínimas, permitiendo que el agente gestione la memoria de forma autónoma. comentario ↗
Resumen de opiniones del hilo de Hacker News; no son hechos verificados. Leer el debate completo ↗