Un laboratorio de investigación de dos personas ha lanzado un modelo de texto a imagen llamado Pyramid-JiT (P-JiT), diseñado como una prueba de concepto para modelos de vídeo generativos más eficientes. El objetivo principal del proyecto era abordar los altos costes computacionales de la generación de vídeo, que a menudo están impulsados por la complejidad cuadrática de los mecanismos de atención. Al alejarse de los Variational Autoencoders (VAEs) tradicionales para comprimir imágenes en un espacio latente, los investigadores pretendían eludir los techos empíricos de la compresión VAE y aprender de manera más eficiente en un entorno de espacio de píxeles.
La arquitectura P-JiT logra esto mediante el uso de una reducción de tokens de 32x32, lo que representa una reducción de 4 veces en la ventana de contexto de atención en comparación con modelos estándar como FLUX-2. Para acelerar la convergencia, el equipo implementó un 'currículo' sobre el programa de ruido: el modelo primero se entrena con muestras de alto ruido para aprender estructuras básicas antes de ampliar la distribución para capturar detalles finos. El régimen de entrenamiento involucró 660 millones de muestras, utilizando un Diffusion Transformer (DiT) de 2.000 millones de parámetros y un codificador de texto Qwen3.5-4B congelado. El coste total de computación para el preentrenamiento y el postentrenamiento en GPUs H100 fue de aproximadamente 21.038 dólares.
Si bien el modelo demuestra resultados de alta calidad para retratos y paisajes, su tamaño más pequeño introduce compensaciones específicas en la generación de escenas complejas. Los investigadores señalaron que el modelo tiene dificultades con las interacciones de varias personas, muchas entidades (como una pila de destornilladores o una multitud de gaviotas) y el conocimiento del mundo. Además, debido a que el modelo no fue entrenado con texto renderizado, no puede generar infografías o pósteres. Estas limitaciones son consecuencias esperadas de la escala de 2.000 millones de parámetros, que el equipo sugiere que podrían mitigarse entrenando modelos más grandes y aplicando técnicas adicionales de postentrenamiento como la Optimización de Flujo por Diferencias Finitas (FDFO).
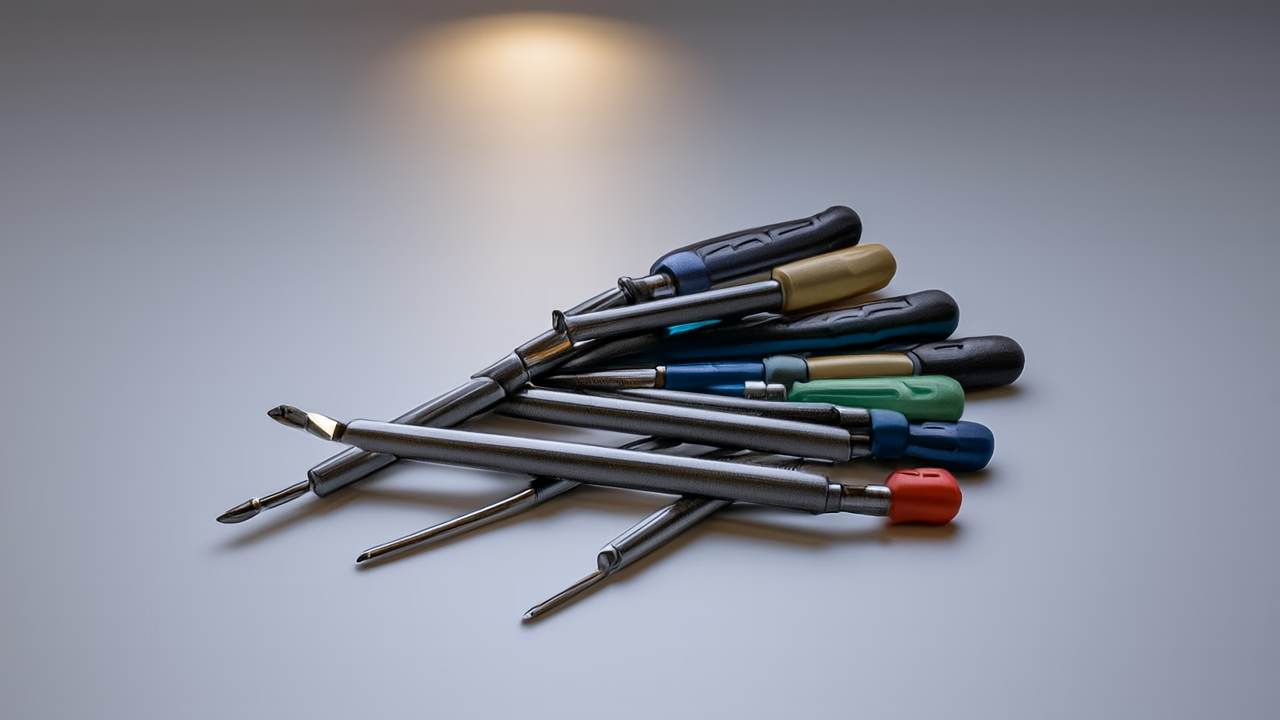
Esta imagen ilustra la dificultad del modelo para generar muchas entidades distintas en una sola escena.
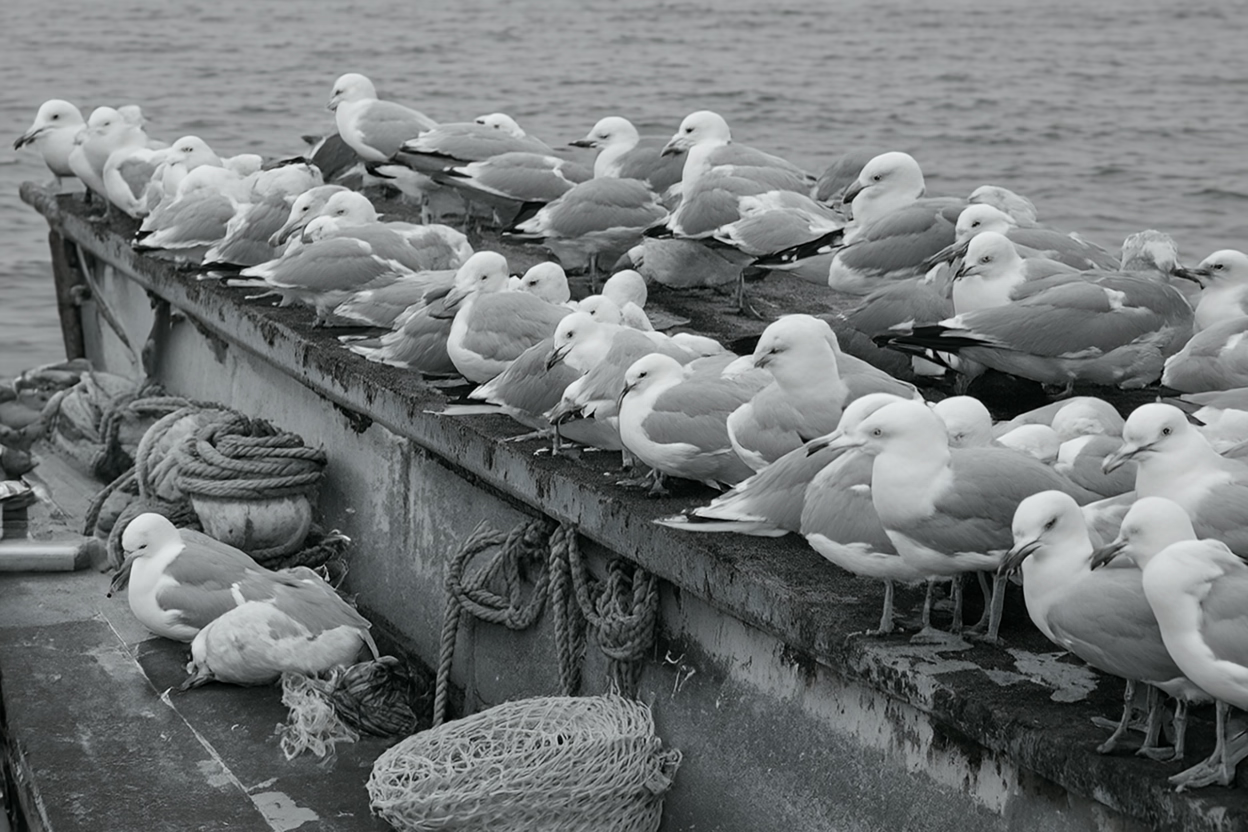
Esta imagen demuestra la limitación específica con respecto a las multitudes y múltiples entidades mencionada en el texto.
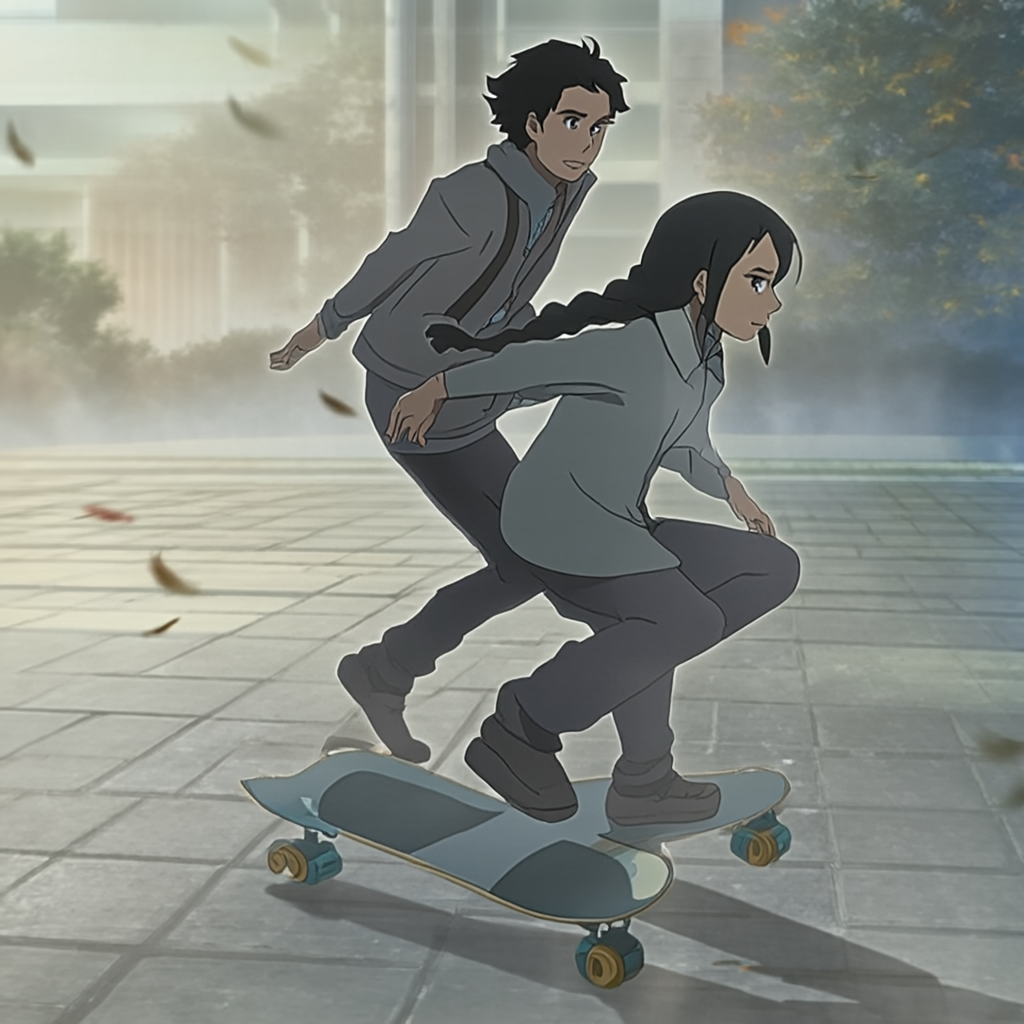
Esta imagen proporciona un ejemplo concreto de la dificultad del modelo con las interacciones de varias personas.