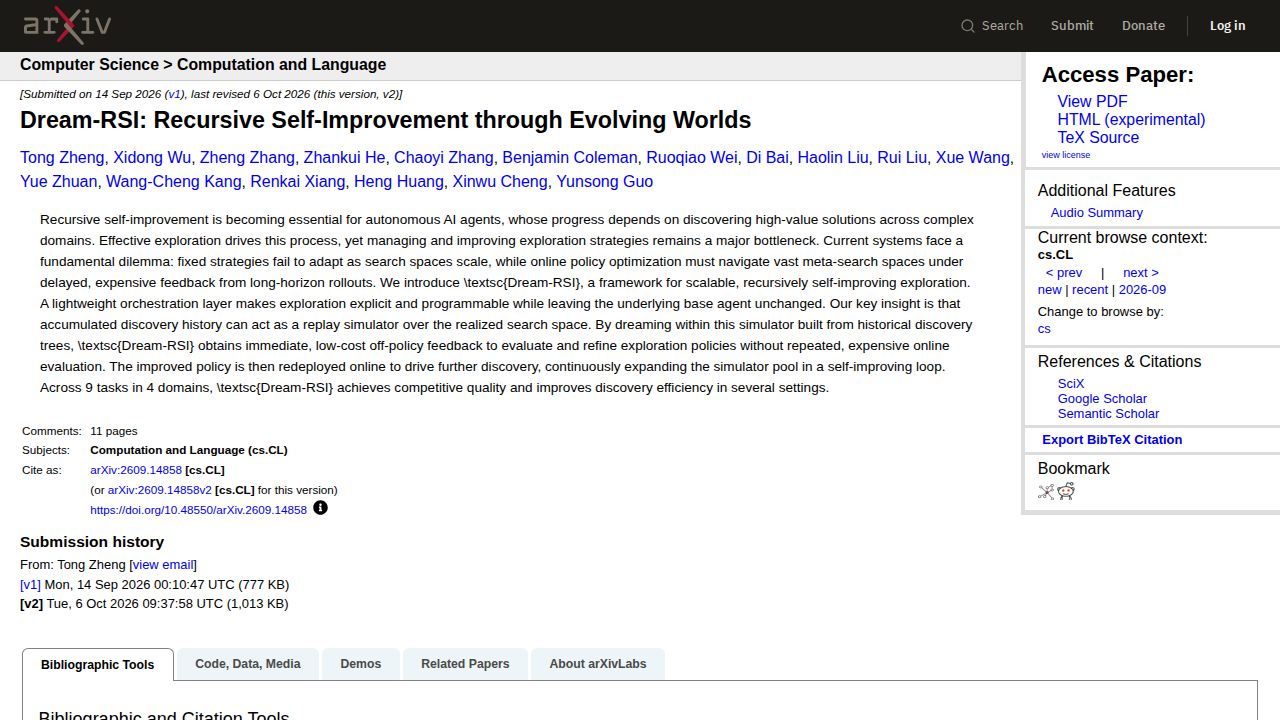
Los agentes de IA autónomos enfrentan un cuello de botella significativo cuando se les encomienda resolver problemas complejos: cómo explorar eficazmente vastos espacios de búsqueda. Los sistemas tradicionales suelen depender de estrategias de exploración fijas que no logran adaptarse a medida que el espacio de búsqueda aumenta de escala. Alternativamente, optimizar las políticas de exploración en línea puede resultar prohibitivamente costoso porque requiere simulaciones de largo alcance para proporcionar retroalimentación. Para abordar esto, los investigadores han introducido Dream-RSI, un marco diseñado para una exploración escalable y de auto-mejora recursiva que desacopla la estrategia de exploración del agente base subyacente.
El mecanismo central de Dream-RSI reside en el uso del historial de descubrimientos acumulados como un 'simulador de repetición'. En lugar de realizar evaluaciones costosas en el mundo real para probar una nueva política de exploración, el sistema trata el espacio de búsqueda realizado —las rutas que el agente ya ha tomado— como un entorno virtual. Al 'soñar' dentro de este simulador construido a partir de árboles de descubrimiento históricos, el agente obtiene retroalimentación inmediata y de bajo costo fuera de la política (off-policy). Esto permite al sistema evaluar y refinar sus tácticas de exploración rápidamente. Una vez que una política se mejora en este estado de 'sueño' virtual, se vuelve a desplegar en el mundo real para impulsar nuevos descubrimientos, lo que a su vez expande el conjunto del simulador, creando un bucle continuo de auto-mejora.
En pruebas realizadas en nueve tareas en cuatro dominios diferentes, Dream-RSI logró una calidad competitiva mientras mejoraba la eficiencia del descubrimiento en varios entornos. Sin embargo, la aplicación práctica del marco implica compensaciones específicas y preguntas sin respuesta. Si bien el uso de un simulador basado en el historial evita las simulaciones costosas, aún no está claro cómo el sistema evita que la política de exploración se sobreajuste a las ramas ya descubiertas o se vuelva 'obsoleta' a medida que el espacio de búsqueda se expande. Además, aunque los autores presentan esto como Auto-Mejora Recursiva (RSI), algunos observadores señalan que el sistema funciona principalmente como una optimización sofisticada de los métodos de entrenamiento —reasignando recursos computacionales a áreas prometedoras— en lugar de un sistema que aumenta perpetuamente su propia inteligencia fundamental.