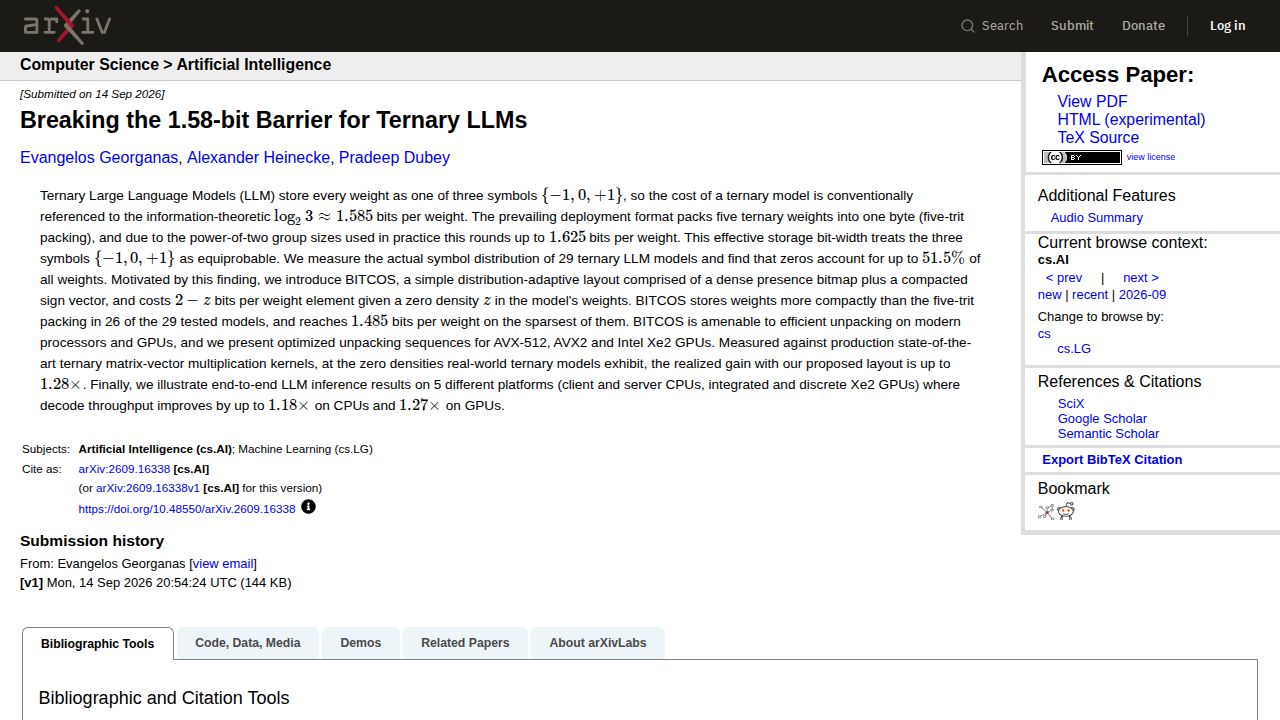
Los modelos de lenguaje de gran tamaño (LLMs) ternarios representan cada peso utilizando uno de tres símbolos: -1, 0 o +1. Teóricamente, esto corresponde a un límite de información de aproximadamente 1.58 bits por peso (log2 3). En el despliegue práctico, la mayoría de los sistemas actuales utilizan el "empaquetado de cinco trits", donde cinco pesos ternarios se empaquetan en un solo byte. Debido a que la memoria de la computadora se organiza en potencias de dos, este método redondea efectivamente el costo hacia arriba a 1.625 bits por peso, tratando los tres valores posibles como si fueran igualmente probables.
Sin embargo, investigadores que analizaron 29 modelos diferentes de LLMs ternarios descubrieron que estos pesos no se distribuyen uniformemente; en cambio, los ceros pueden representar hasta el 51.5% de todos los pesos. Para capitalizar este desequilibrio, los autores introdujeron BITCOS, un diseño adaptativo a la distribución. En lugar de asignar un número fijo de bits a cada peso, BITCOS utiliza un mapa de bits de presencia densa para identificar qué pesos no son cero y un vector de signo compactado para almacenar los valores restantes. Este enfoque permite que el costo de almacenamiento del modelo escale en función de su densidad de ceros específica (z), calculada como `2 - z` bits por elemento de peso. En algunos modelos probados, esto redujo el ancho de bits efectivo a tan solo 1.485 bits por peso.
La transición del empaquetado estándar a BITCOS proporciona ganancias de rendimiento medibles en diversas plataformas de hardware. El estudio encontró que, en densidades de ceros del mundo real, el diseño propuesto logró una ganancia de hasta 1.28x en la multiplicación matriz-vector en comparación con los kernels de vanguardia en producción. Además, las pruebas de inferencia de extremo a extremo mostraron mejoras en el rendimiento de decodificación de hasta 1.18x en CPUs y 1.27x en GPUs Intel Xe2. Si bien BITCOS es altamente eficiente, requiere secuencias de desempaquetado especializadas —optimizadas para arquitecturas como AVX-512 y GPUs Intel Xe2— para mantener estas ventajas de velocidad durante el cálculo. Una pregunta clave que permanece sin resolver es cuánta eficiencia se puede ganar si el silicio personalizado futuro (ASICs) se diseña para admitir el formato BITCOS de forma nativa, eliminando potencialmente la necesidad de desempaquetado basado en software por completo.