Tencent ha lanzado Hy4, un modelo de lenguaje grande (LLM) insignia diseñado para manejar tareas de productividad complejas y del mundo real, tales como la ingeniería de software, la investigación científica y el análisis financiero. Construido sobre la arquitectura Hunyuan, el modelo cuenta con una ventana de contexto de aproximadamente un millón de tokens y fue desarrollado con un enfoque en el co-diseño profundo con diversas aplicaciones industriales. Si bien la vista previa inicial se lanzó bajo una licencia Apache 2.0, Tencent ha indicado que los pesos completos del modelo Hy4 se pondrán a disposición del público en los próximos días, posicionándolo potencialmente como un modelo de pesos abiertos líder en el mercado.
En una reciente prueba de referencia de análisis de datos realizada por Plotly, Hy4 logró una puntuación de 42 de 43 (98%) en un examen especializado diseñado para evaluar la llamada de herramientas en múltiples turnos y el razonamiento de datos. Este rendimiento situó a Hy4 en la "frontera de costo-precisión", una categoría de modelos que proporcionan una alta precisión a un precio inferior al de sus pares. Específicamente, Hy4 fue identificado como el modelo más rentable entre aquellos que obtuvieron una puntuación de 42 o superior, con un costo aproximado de $2.11 por una ejecución completa del examen. Esta eficiencia se atribuye en parte a su alta tasa de acierto en la caché; durante la prueba, el 91% de los 22.7 millones de tokens de entrada fueron servidos desde una caché, reduciendo significativamente el costo por consulta en comparación con los modelos sin ventajas de caché similares.
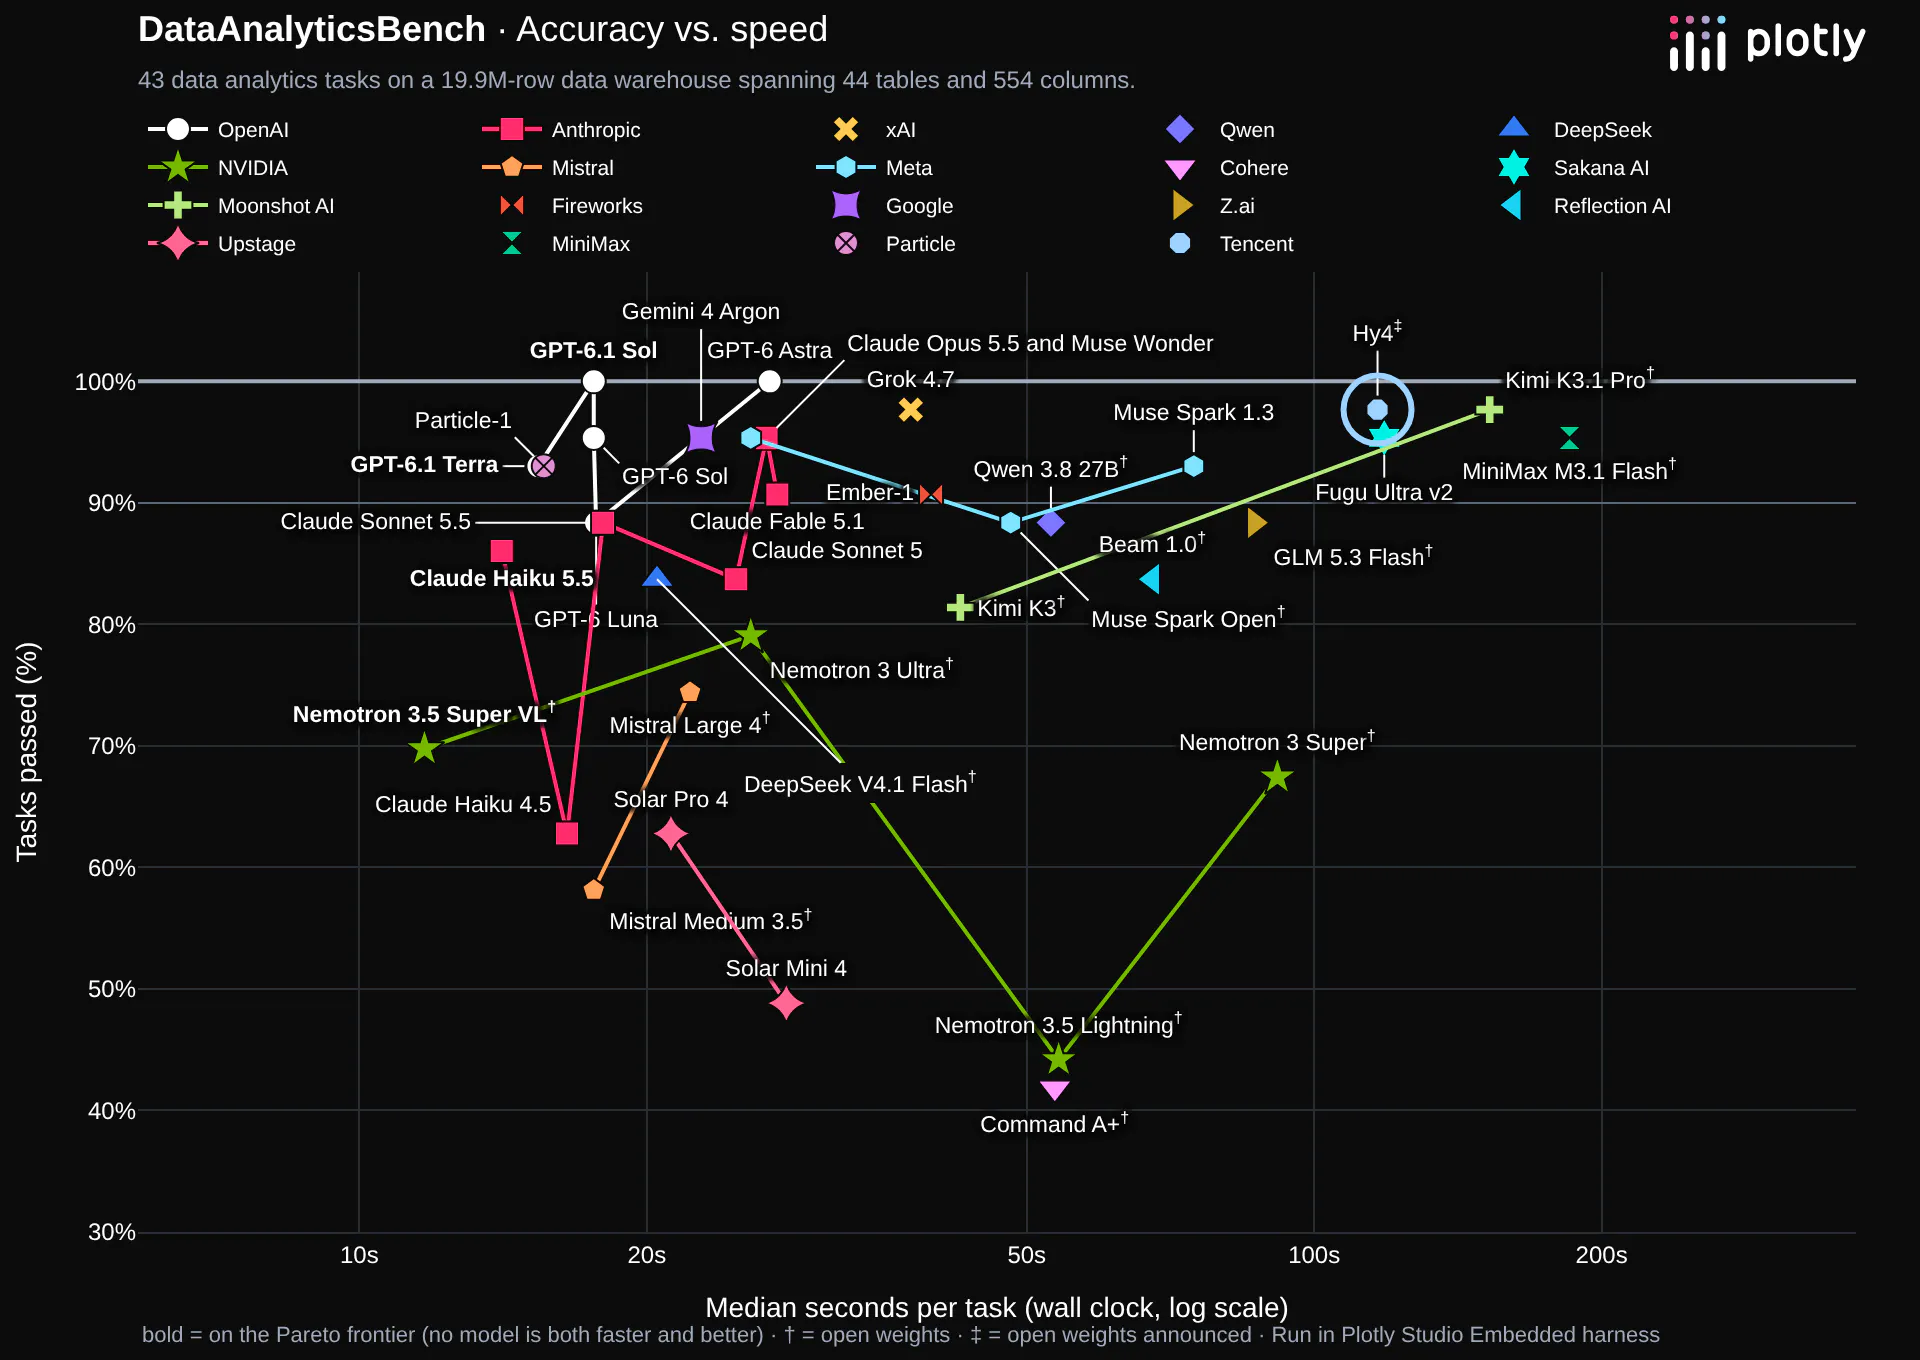
Este gráfico ilustra el compromiso específico entre la alta precisión y las velocidades de procesamiento más lentas que definen el perfil de rendimiento de Hy4.
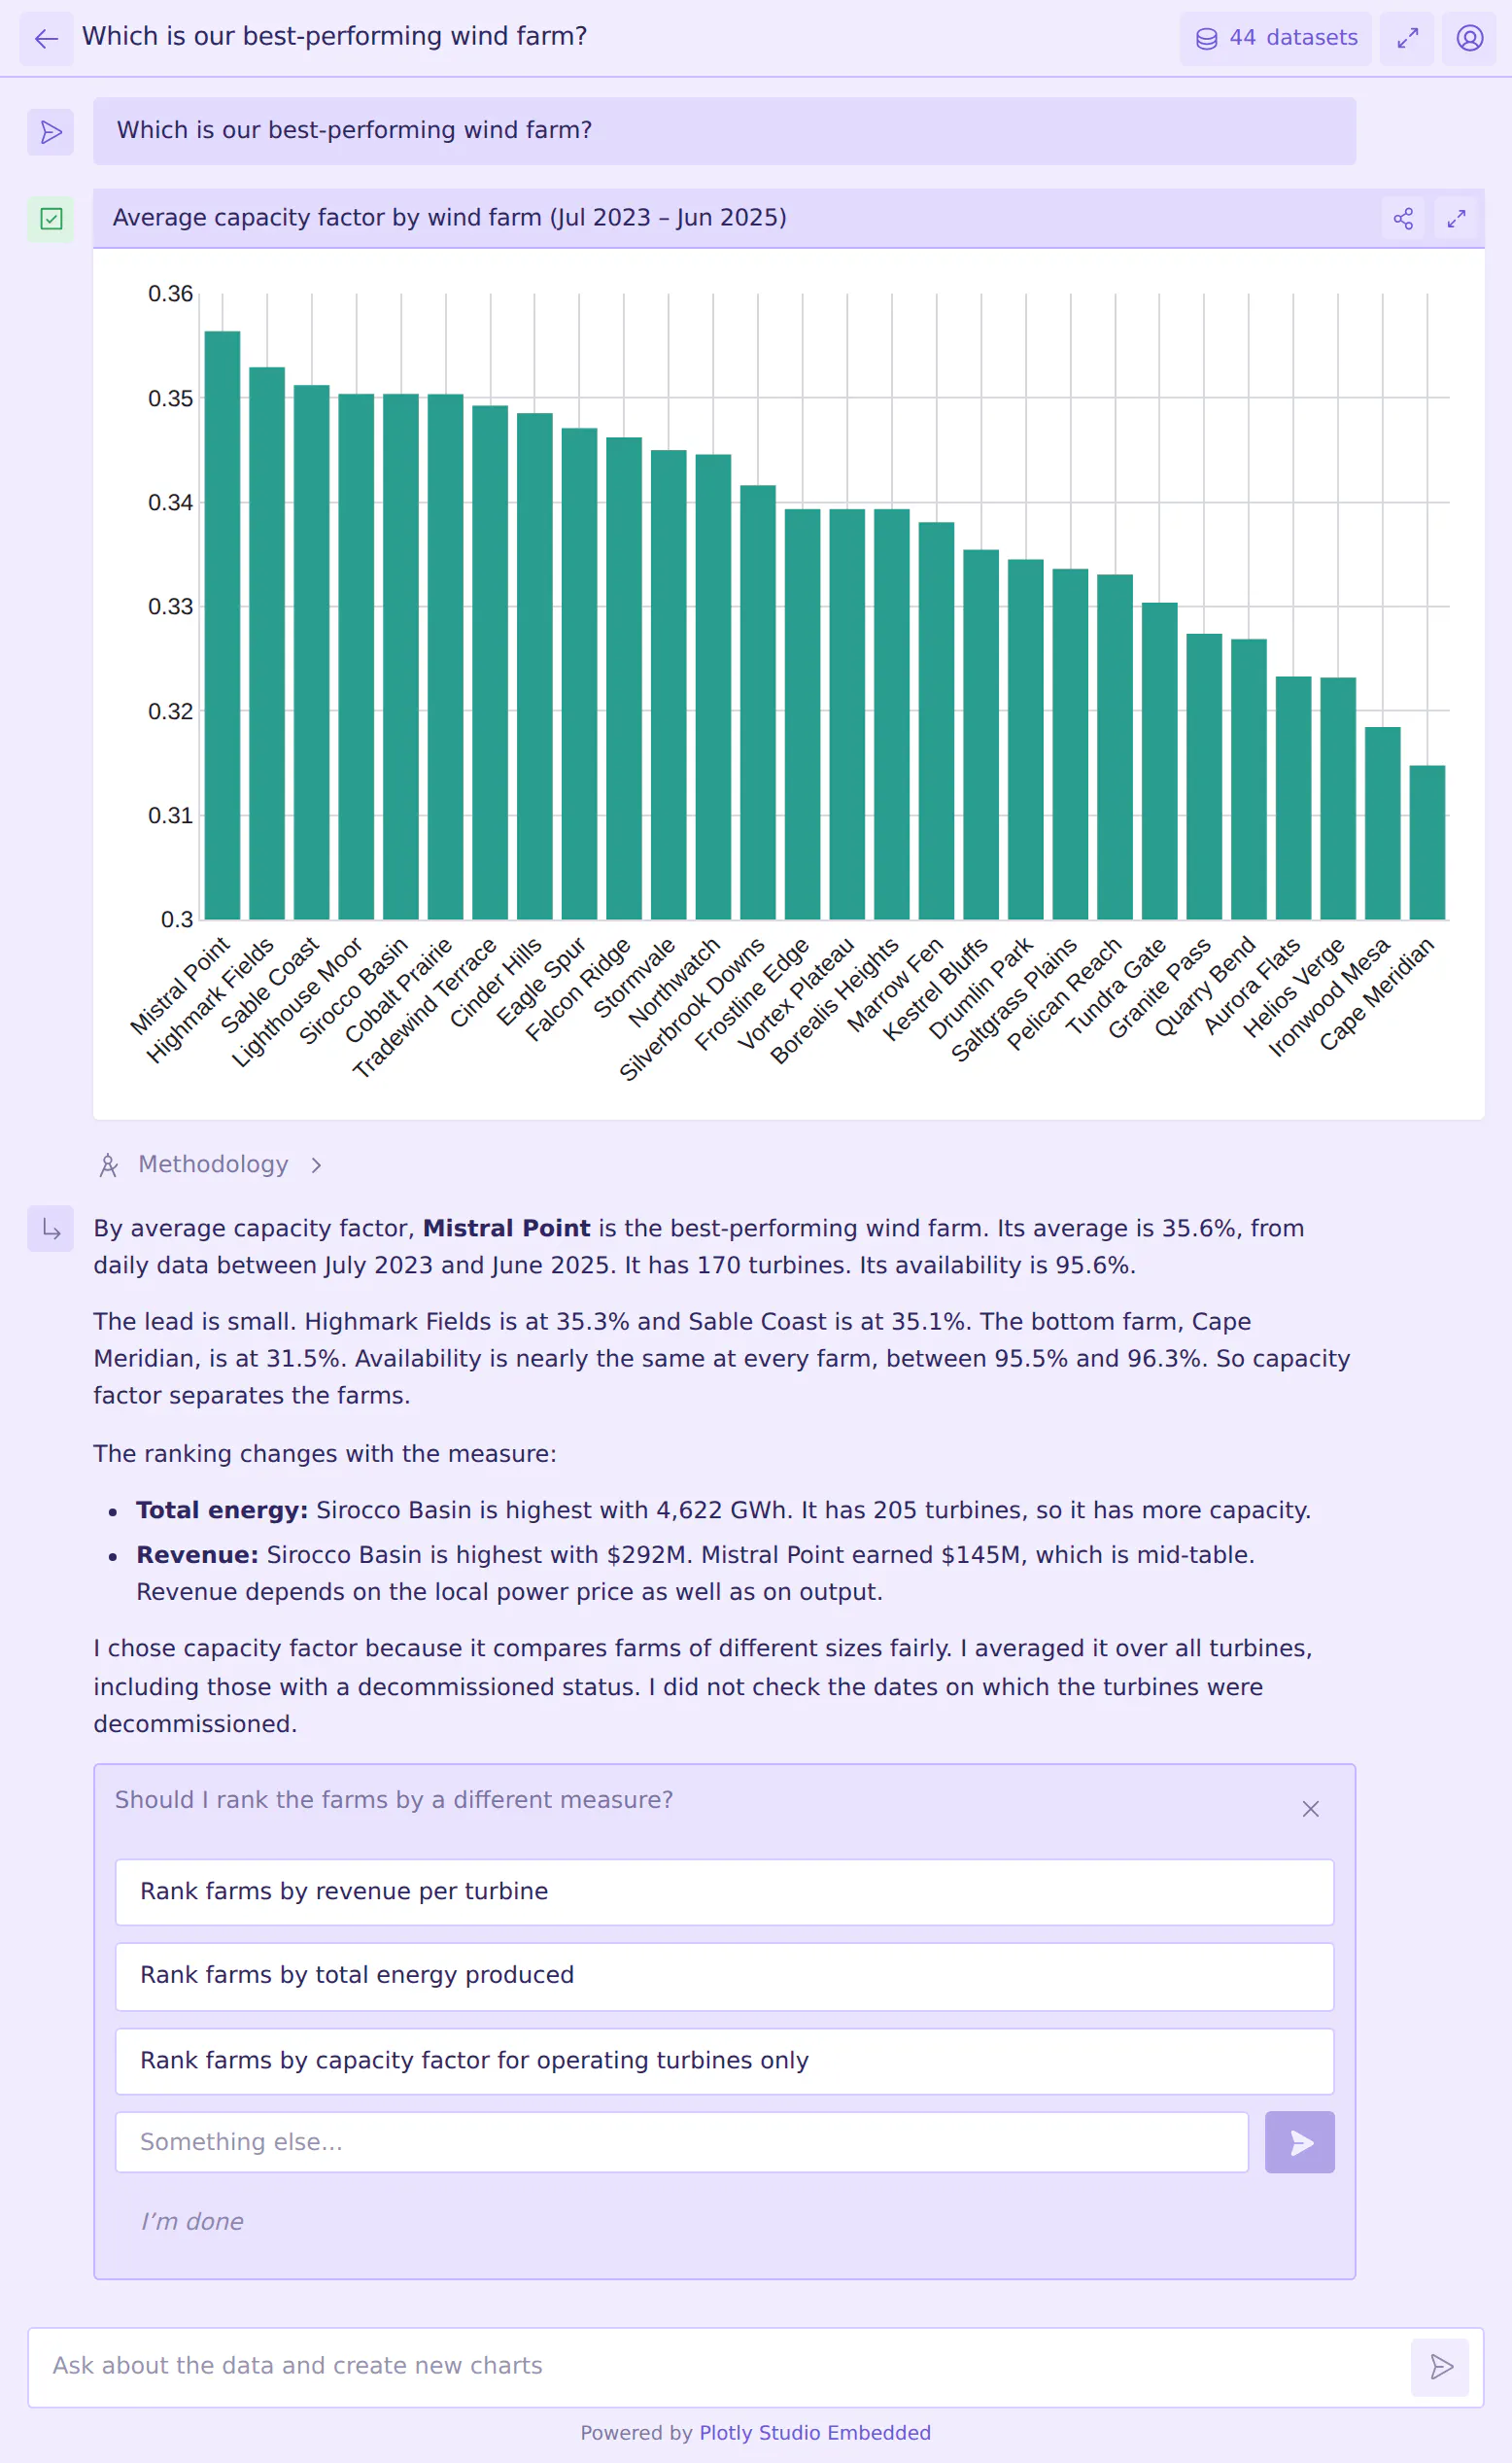
Esta imagen demuestra el tipo de tareas complejas de razonamiento de datos y llamada de herramientas en las que se probó Hy4 durante la prueba de referencia de Plotly.
Sin embargo, la precisión de Hy4 conlleva un compromiso notable en la velocidad. Fue uno de los modelos más lentos probados, con un tiempo de procesamiento mediano de 117 segundos por pregunta, más de seis veces más lento que GPT-6.1 Sol. Esta latencia es un resultado directo del comportamiento "exhaustivo" del modelo; Hy4 realiza verificaciones internas extensas, ejecutando a menudo entre 24 y 64 consultas por pregunta para verificar recuentos, tendencias y suposiciones. Si bien este enfoque exhaustivo le permite sobresalir en la identificación de trampas estadísticas y la auditoría de la calidad de los datos, puede dar lugar a valores atípicos extremos en el tiempo de procesamiento, como una sola consulta que se ejecutó durante casi una hora. Para entornos de producción, estos resultados sugieren que, aunque Hy4 es altamente confiable para el razonamiento complejo, los usuarios pueden necesitar implementar límites de tiempo específicos para gestionar sus ciclos de verificación exhaustivos.