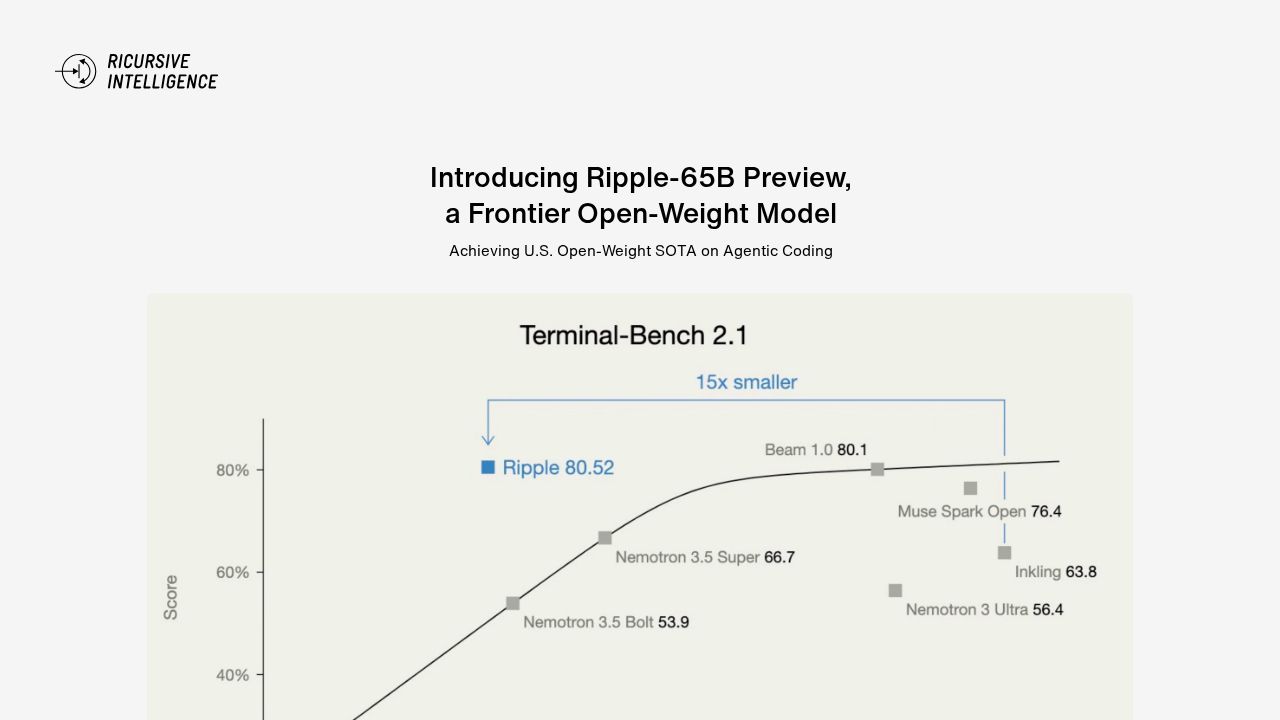
Ripple-65B es un modelo de lenguaje de gran tamaño (LLM) de pesos abiertos desarrollado en los Estados Unidos, diseñado específicamente para sobresalir en la "programación agéntica", tareas en las que una IA actúa como un agente autónomo para escribir, depurar y ejecutar código. Los desarrolladores posicionan el modelo como una solución de vanguardia (SOTA), una afirmación que se refiere a su ubicación en la curva de Pareto, la cual mide el equilibrio óptimo entre el rendimiento de un modelo y su tamaño físico. Al ofrecer una versión de pesos abiertos, el proyecto busca proporcionar una alternativa de alto rendimiento para los desarrolladores que requieren inferencia local o una transparencia específica sobre la arquitectura del modelo.
En términos de rendimiento bruto, Ripple-65B alcanzó una puntuación de 80.5 en el Terminal Bench 2.1, una métrica utilizada para evaluar qué tan bien maneja un modelo las tareas de programación basadas en la línea de comandos y la terminal. Sin embargo, su posición en relación con otros modelos es matizada. Por ejemplo, el modelo Qwen 3.8 Flash Next —que es más grande pero utiliza una arquitectura de Mezcla de Expertos (MoE) para mantenerse eficiente— obtuvo una puntuación más alta de 84.3. Por el contrario, el modelo Qwen 3.8-27B obtuvo una puntuación más baja de 73.0. Estas cifras sugieren que, si bien Ripple-65B es competitivo dentro de ciertos parámetros, enfrenta una fuerte competencia de modelos internacionales que pueden ofrecer diferentes compensaciones en velocidad y precisión.
Las afirmaciones del modelo han sido objeto de escrutinio con respecto a la selección de puntos de referencia y modelos de comparación. Algunos observadores señalaron que los datos de rendimiento parecen favorecer a Ripple-65B al omitir modelos superiores en categorías de tamaño similares, como Beam 1.0 o Nemotron 3.5 Super, en favor de líneas base menos competitivas. Además, la marca "EE. UU." ha suscitado preguntas sobre la procedencia específica de los datos y si el rendimiento del modelo es resultado de conjuntos de entrenamiento nacionales únicos o simplemente una optimización específica para el nicho de la programación. Debido a que los datos de entrenamiento completos y los pesos no se auditan públicamente en esta vista previa, el alcance exacto de sus capacidades "agénticas" sigue siendo un punto de evaluación continua por parte de la comunidad.