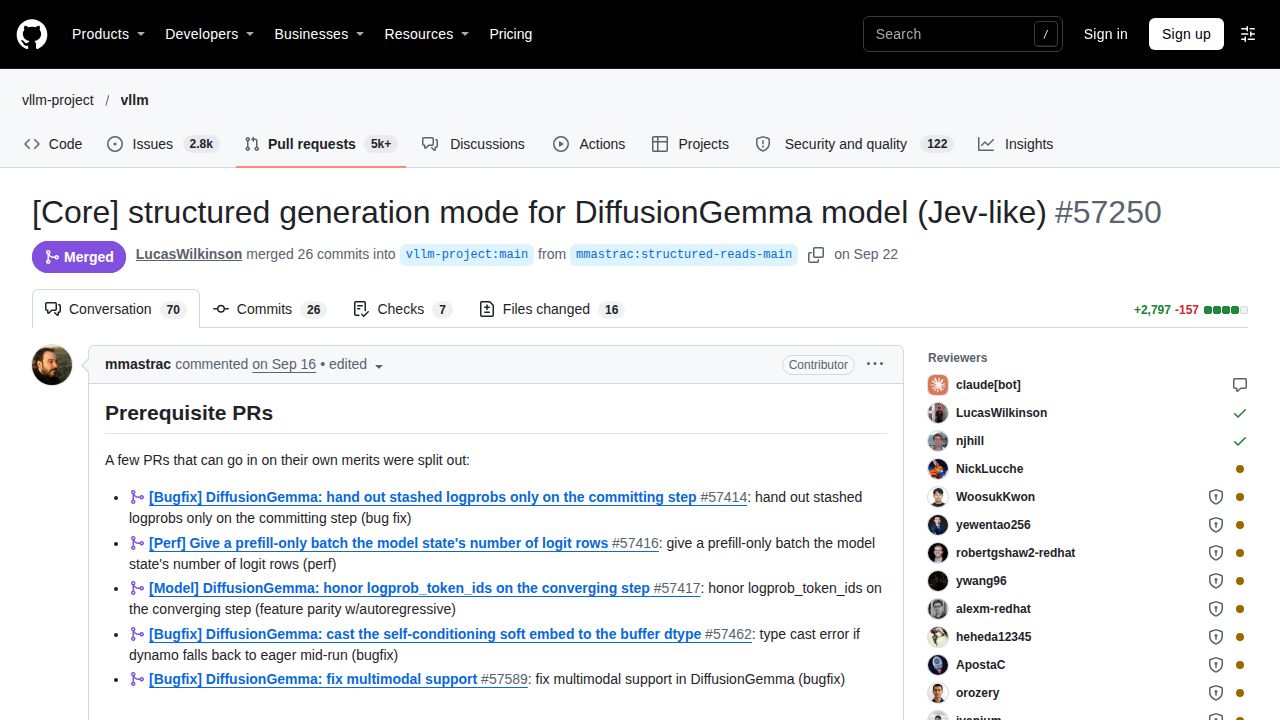
Un modelo de tipo 'Jev' se define por su capacidad para procesar una entrada de texto y una lista de opciones, devolviendo una probabilidad para cada opción en una sola pasada. Esto contrasta con la generación autorregresiva estándar, donde un modelo predice el texto palabra por palabra. Al cambiar a este enfoque de una sola pasada, los modelos pueden realizar tareas de clasificación de manera más eficiente, como preguntas de sí/no o de opción múltiple, aprovechando la inteligencia ya codificada en el espacio latente del modelo sin la sobrecarga de la predicción secuencial de tokens.
El mecanismo técnico para esto en el proyecto vLLM implica reutilizar el modelo DiffusionGemma para que funcione con un 'lienzo' fijo de posiciones de tokens. En este marco, el cliente solicitante proporciona un conjunto de ranuras de tokens fijas. El modelo luego 'difunde' el contenido de estas ranuras mientras la estructura permanece constante. Los componentes técnicos clave introducidos para dar soporte a esto incluyen `diffusion_seed_canvas`, que pre-siembra la salida con tokens fijos; `diffusion_pinned`, que asegura que posiciones específicas se mantengan en sus valores de semilla durante los pasos de eliminación de ruido; y `diffusion_read_only`, que permite al modelo emitir logprobs a una temperatura de 1 para proporcionar una puntuación de confianza para cada respuesta.
Si bien este método ofrece un camino más directo hacia las salidas estructuradas, actualmente enfrenta restricciones arquitectónicas específicas. El modelo requiere que cada opción en la salida esté representada por un solo token para asegurar que el lienzo no se desplace durante el proceso de difusión. En consecuencia, si un cliente necesita ofrecer opciones de múltiples tokens, primero debe mapear esas opciones a IDs de un solo token (por ejemplo, mapear "moderation_spam" a "A"). Además, aunque el modelo proporciona logprobs para ayudar a los clientes a calcular la entropía y determinar la confianza, el prototipo actual aún no incluye evaluaciones empíricas que comparen este método de difusión de una sola pasada frente a los modelos autorregresivos estándar para salidas estructuradas complejas de múltiples tokens.