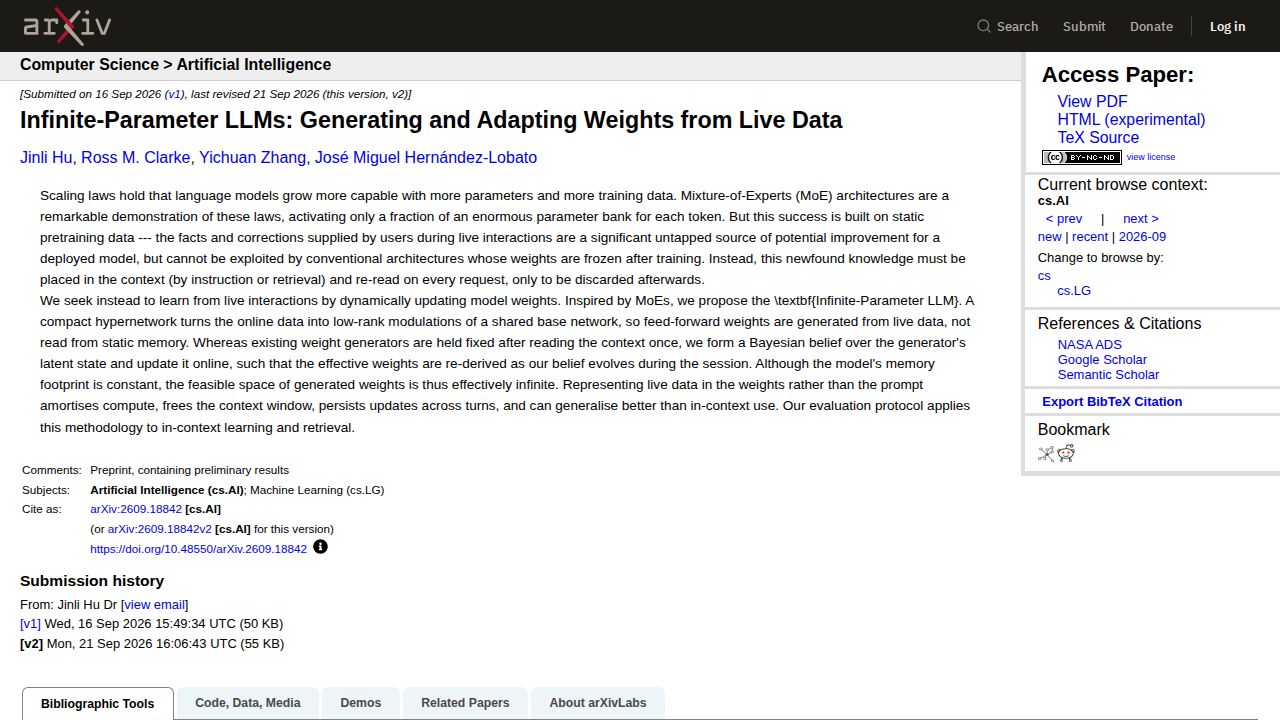
Los modelos de lenguaje de gran tamaño (LLMs) actuales se construyen generalmente sobre pesos estáticos que se congelan después de una fase de preentrenamiento. Si bien estos modelos pueden manejar nueva información proporcionada por los usuarios durante una conversación, lo hacen colocando esos datos en una 'ventana de contexto', un espacio de memoria temporal que se lee para cada solicitud y se descarta después. Esto significa que el modelo no puede realmente 'aprender' o internalizar nuevos hechos o correcciones de una interacción en vivo sin someterse a un proceso de reentrenamiento o ajuste fino (fine-tuning) separado y costoso.
Para abordar esto, los investigadores han propuesto el 'LLM de parámetros infinitos'. Esta arquitectura utiliza una hiperred compacta para transformar datos en tiempo real en modulaciones de bajo rango de una red base compartida. En lugar de leer pesos de un banco de memoria fijo, los pesos de alimentación hacia adelante (feed-forward) del modelo se generan dinámicamente a partir de los datos que recibe en tiempo real. Una distinción clave en este enfoque es el uso de una creencia bayesiana sobre el estado latente del generador. A diferencia de los métodos anteriores de generación de pesos que podrían congelarse tras leer un prompt una sola vez, este sistema actualiza su creencia en línea, permitiendo que los pesos efectivos se vuelvan a derivar a medida que el estado interno del modelo evoluciona a lo largo de una sesión.
Este método ofrece varias ventajas prácticas sobre el aprendizaje estándar en contexto. Al representar los datos en tiempo real dentro de los propios pesos, el modelo puede amortizar los costos de computación, liberar espacio en la ventana de contexto para otras tareas y, potencialmente, generalizar nueva información de manera más efectiva. Sin embargo, la transición al aprendizaje continuo introduce nuevas complejidades. Los investigadores y observadores han señalado que mantener la estabilidad del modelo durante las actualizaciones constantes de pesos es un desafío significativo, ya que puede surgir un comportamiento impredecible cuando un modelo evoluciona constantemente. Además, los modelos de aprendizaje continuo pueden enfrentar riesgos de seguridad únicos, como el 'envenenamiento' (poisoning), donde entradas específicas de usuarios podrían empujar al modelo hacia comportamientos no deseados o sesgos a través de diferentes sesiones.
Si bien la arquitectura propuesta ofrece un camino hacia modelos que realmente aprenden de cada interacción, la investigación se encuentra actualmente en la etapa de preimpresión con resultados preliminares. Los puntos de referencia de rendimiento específicos que comparan este espacio de pesos 'infinito' frente a las técnicas tradicionales de Mixture-of-Experts (MoE) o Low-Rank Adaptation (LoRA) siguen siendo un área para mayor investigación a medida que la tecnología madura.