Un bucle anidado ingenuo para la multiplicación de matrices puede ejecutarse a solo el 1.1% de la velocidad de una biblioteca profesional como OpenBLAS porque no tiene en cuenta cómo una CPU busca los datos en su caché. Para cerrar la brecha entre el código de alto nivel y los kernels de alto rendimiento, Csongor Kiss está construyendo Cachet, un lenguaje donde las suposiciones de hardware —como en qué niveles de memoria ocupa un búfer— son partes explícitas del código fuente.
El problema de las optimizaciones ocultas
Optimizar un programa normalmente implica esperar que un compilador sea lo suficientemente inteligente para manejar el flujo de datos o reescribir el código manualmente para que coincida con el hardware. En este último caso, las abstracciones se rompen y los desarrolladores deben gestionar manualmente detalles complejos como la residencia en la caché y la vectorización.
En ambos escenarios, las decisiones críticas suelen estar ocultas. Un compilador las toma basándose en un modelo de hardware interno, mientras que un desarrollador humano las mantiene en su cabeza o en comentarios. Cachet pretende trasladar estas decisiones al propio lenguaje, permitiendo que el compilador verifique que las suposiciones del programador sobre el hardware siguen siendo válidas a medida que el código evoluciona.
“En Cachet, en qué caché permanece un búfer, cuántos datos se mueven entre los niveles de memoria y qué instrucciones proporciona el hardware son parte del lenguaje.”
— Write your own kernel optimiser | Csongor Kiss
Contracciones y horarios
Cachet utiliza un modelo de 'contracción' para definir los cálculos. En lugar de escribir bucles, un desarrollador escribe una ecuación matemática para cada elemento de salida. Por ejemplo, una multiplicación de matrices se define mediante una fórmula donde los índices libres determinan las salidas y los índices sumados determinan las operaciones.
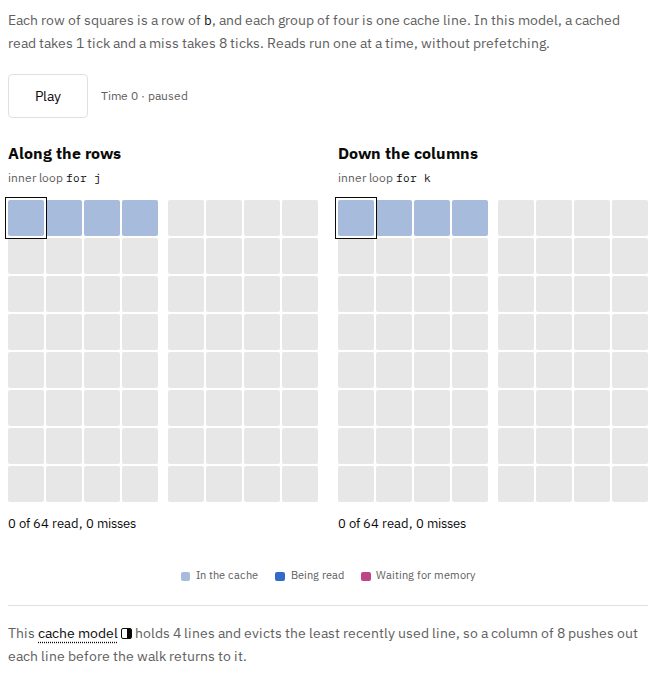
Esta imagen ilustra el proceso de computación manual que Cachet pretende abstraer en contracciones matemáticas.
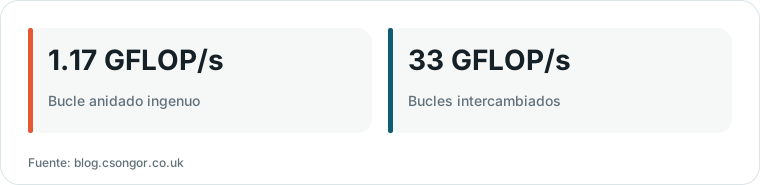
Gráfico de HN Digest basado en cifras de blog.csongor.co.uk; los valores se muestran como en la fuente.
Para convertir esta definición en un programa rápido, Cachet utiliza un 'horario': una secuencia de transformaciones que reescribe la contracción en un bucle anidado optimizado. El compilador verifica cada paso del horario para asegurar que la transformación preserve el significado original del cálculo, como garantizar que diferentes salidas no se solapen de una manera que rompa las matemáticas.
Reescrituras verificables y mapeo de hardware
El sistema utiliza una biblioteca de 'pasos' donde cada reescritura viene con una 'receta de prueba'. Esto permite al compilador verificar que una transformación, como intercambiar bucles para mejorar los aciertos de caché, sea matemáticamente válida para el programa específico que se está compilando.
Este enfoque permite optimizaciones complejas como el 'bloqueo' (blocking), que mantiene un bloque de datos en la caché mientras el procesador realiza múltiples operaciones sobre él. Al hacer estos pasos explícitos, el desarrollador puede razonar sobre el movimiento de datos entre los niveles de memoria mientras el compilador asegura que la lógica siga siendo sólida.
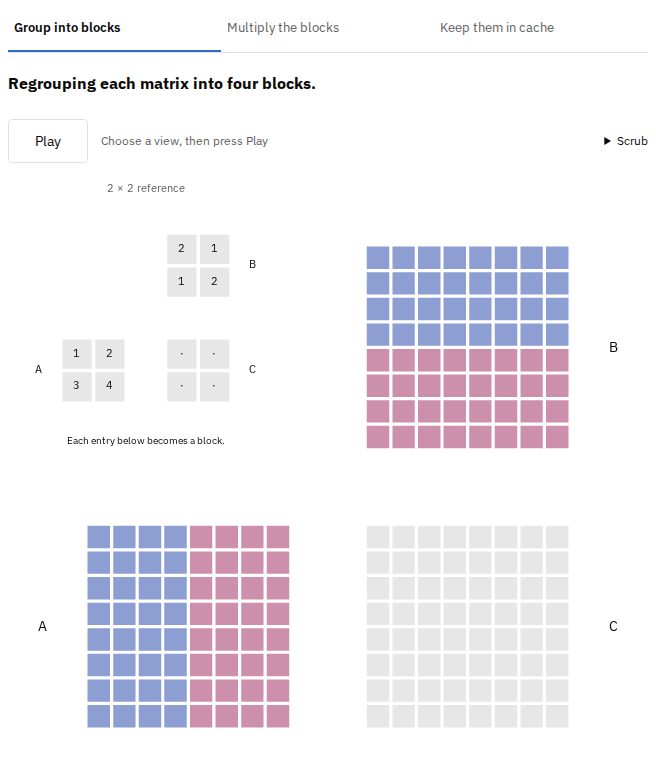
Esta figura explica el concepto de reutilización de entradas, que es un componente clave de la optimización de 'bloqueo' mencionada en el texto.
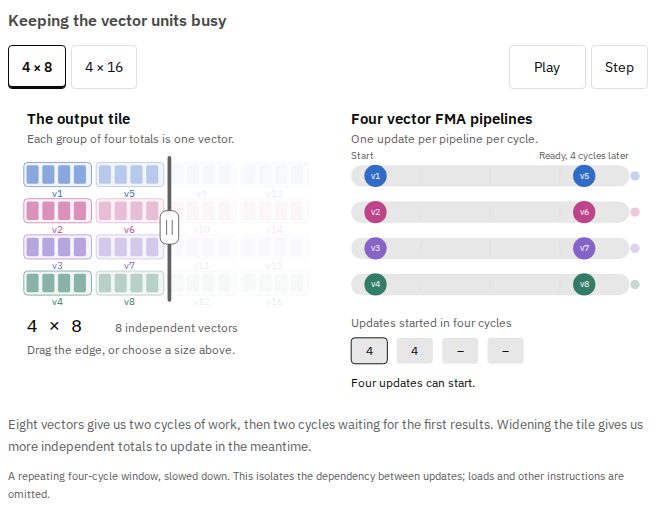
Esta imagen apoya la discusión sobre el ajuste de kernels y el mapeo de hardware para el máximo rendimiento.
Compensaciones y límites actuales
La principal compensación de Cachet es que requiere que el programador tenga una comprensión más profunda de la arquitectura de hardware subyacente. Si bien esto proporciona seguridad al detectar regresiones de rendimiento en tiempo de compilación, exige un conocimiento arquitectónico previo mayor que el de una biblioteca estándar de alto nivel.
Actualmente, la herramienta puede verificar programas para el hardware NVIDIA H100, pero aún no tiene la capacidad de compilar para esa plataforma específica. El objetivo sigue siendo proporcionar un marco donde el rendimiento sea una elección deliberada y verificable en lugar de un efecto secundario de un compilador 'ingenioso'.