La Programación en Espacio de Pesos describe la capacidad de los LLM de vanguardia para analizar y modificar los pesos brutos de un modelo de aprendizaje automático —esencialmente una descripción de texto del modelo que contiene una lista de números de punto flotante— para cambiar su comportamiento. Históricamente, la optimización del comportamiento de un modelo implicaba un 'ascenso de colina' sobre artefactos de texto como prompts o código de entrenamiento, o el uso de optimizadores simbólicos como Adam para actualizar los pesos mediante el descenso de gradiente. En este nuevo paradigma, un LLM utiliza sus capacidades de razonamiento para determinar qué partes específicas de una red neuronal realizan cálculos y luego edita directamente esos pesos para alinear el modelo con una especificación en lenguaje natural.
Investigaciones recientes demuestran que modelos de vanguardia, como GPT-6 Astra, pueden identificar las tareas específicas para las que una red fue entrenada simplemente observando sus pesos brutos. Por ejemplo, cuando se le presentaron los 17,253 pesos de una red de políticas, Astra identificó correctamente juegos como Breakout y Pong sin ninguna retroalimentación del entorno o ejecución de código. Además, estos modelos pueden realizar ediciones en el 'espacio de pesos' para corregir fallos específicos. En un caso, Astra identificó un bucle de razonamiento en el modelo Qwen3.5-0.8B y lo corrigió editando de forma nativa solo el 0.016% de sus pesos. Esta corrección de un solo paso mejoró el rendimiento del modelo en el benchmark MATH-500 del 7.9% al 48.1%, mejorando simultáneamente sus capacidades de seguimiento de instrucciones.
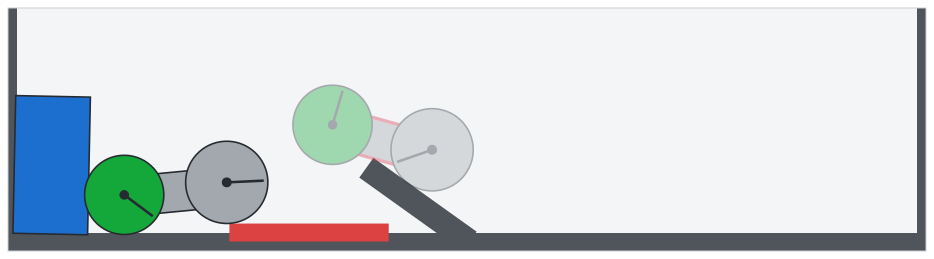
Esta visualización demuestra el resultado exitoso de una edición en el espacio de pesos donde un modelo corrigió un fallo específico en una tarea de navegación.
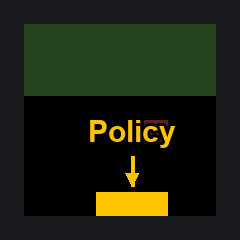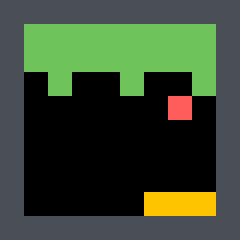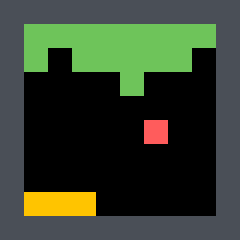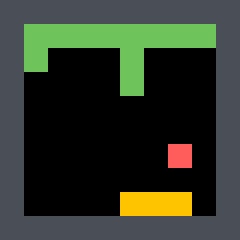
Esta imagen ilustra la tarea específica de jugar Breakout, que el modelo Astra fue capaz de identificar analizando los pesos brutos.
Si bien estos resultados sugieren un cambio hacia la optimización impulsada por el razonamiento de redes diferenciables, las implicaciones prácticas y las limitaciones siguen siendo objeto de debate. Algunos observadores señalan que las trazas de razonamiento del modelo para estas ediciones suelen ser incomprensibles para los humanos, apareciendo como una serie de cálculos complejos que son difíciles de auditar. Además, los críticos han señalado que el proceso de identificar y corregir problemas de pesos puede reflejar los pasos que un investigador humano de aprendizaje automático seguiría, en lugar de representar un salto puramente autónomo en la lógica de las máquinas. Actualmente, estos experimentos se centran en redes a pequeña escala, y sigue siendo incierto qué tan bien escala esta capacidad a los miles de millones de parámetros que se encuentran en los modelos masivos de vanguardia o si eventualmente reemplazará el desarrollo tradicional basado en código fuente.