Un sistema que procesaba recibos de ventas de cada caja registradora enfrentaba un problema recurrente: los informes de un día específico nunca eran realmente finales porque los recibos de las cajas fuera de línea podían llegar con semanas de retraso, y la entrega de 'al menos una vez' de Kafka a menudo causaba que el mismo recibo se contara dos veces. Para resolver esto, los ingenieros abandonaron el modelo tradicional de 'suma acumulativa', que se corrompe fácilmente por las irregularidades del flujo, hacia un diseño donde un agregado es una función determinista de sus documentos de origen.
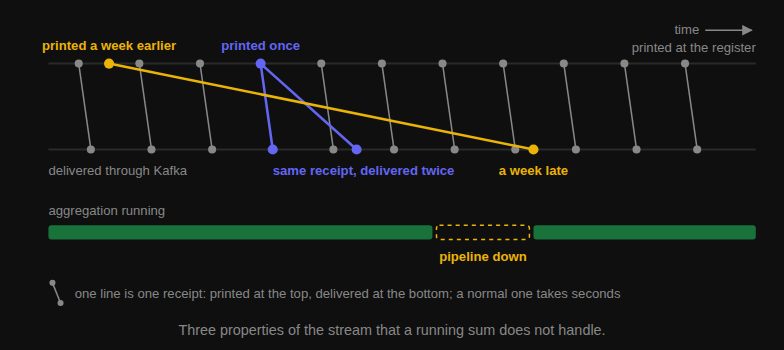
Esta visualización explica las irregularidades específicas del flujo, como los duplicados y las llegadas tardías, que los ingenieros identificaron como la causa raíz de las inconsistencias de datos.
El fallo de las sumas acumulativas
Los flujos de agregación estándar a menudo dependen de 'vistas materializadas' que suman valores a un total a medida que llegan. Sin embargo, este enfoque se rompe cuando un flujo proporciona un documento dos veces; el sistema suma el valor por segunda vez sin ninguna forma de identificar o restar el duplicado. Del mismo modo, si un documento llega con un mes de retraso, una suma acumulativa que ya ha 'cerrado' un período no puede incorporarlo fácilmente sin una lógica compleja.
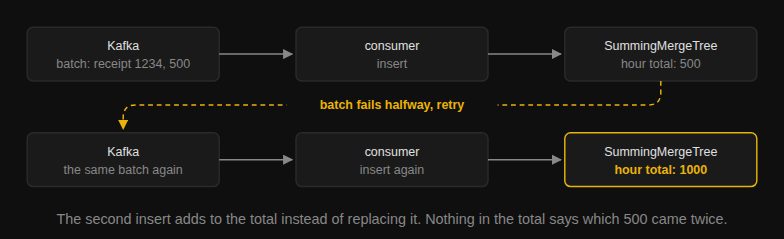
Esta imagen demuestra el modo de fallo específico del método 'añadir al insertar' mencionado en el texto.
Los ingenieros probaron cuatro enfoques diferentes para resolver esto. Intentaron recalcular a partir de tablas anchas, pero la base de datos tuvo que leer 46 millones de filas para encontrar 508,000 registros necesarios porque los datos no estaban ordenados por fecha. También intentaron mantener un diccionario de cada clave vista en memoria, pero el conjunto de claves era demasiado grande para caber en la memoria de producción, lo que causó que el sistema fallara por completo.
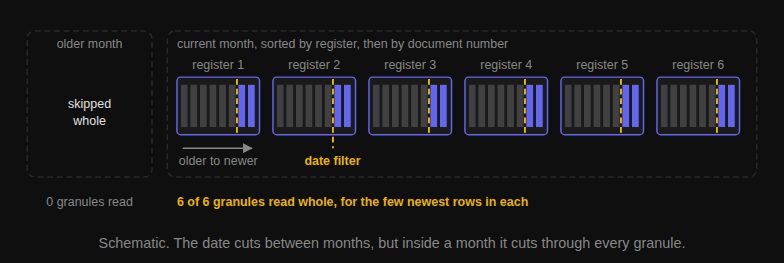
Esta figura apoya la explicación de por qué recalcular a partir de tablas anchas requería leer millones de filas innecesarias.
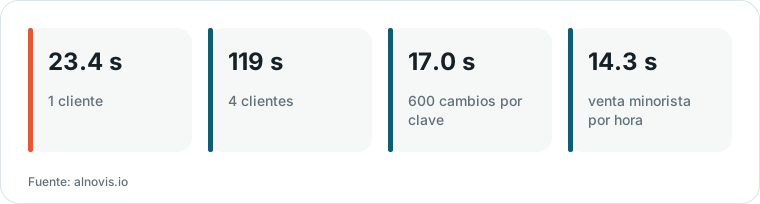
Gráfico elaborado por HN Digest a partir de cifras de alnovis.io; los valores se muestran como en la fuente.
“Un agregado no es una suma acumulativa de lo que se insertó, sino una función de sus documentos.”
— An Aggregate Is a Function, Not a Sum | Alexander Novikov
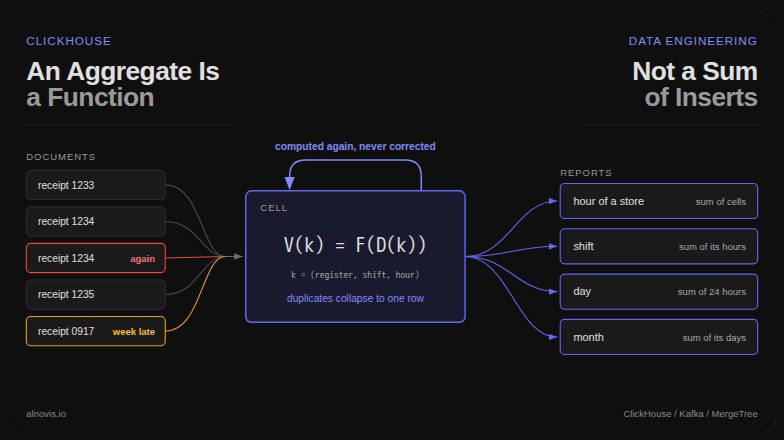
Esta imagen sirve como visual principal para la tesis central del artículo: tratar los agregados como funciones deterministas de los documentos de origen.
El modelo Cell y los agregados funcionales
La solución fue tratar un agregado como una función de sus documentos. El sistema define una 'Cell' (celda), la unidad más pequeña de agregación, como el turno y la hora de una caja registradora específica. Cada documento pertenece exactamente a una celda. El valor de esa celda se calcula agrupando los documentos que pertenecen a esa clave y aplicando una operación de plegado (como una suma o un máximo).
Debido a que el valor es una función de los documentos, recalcularlo es idempotente. Si un documento se entrega dos veces, el sistema lo colapsa por su ID único durante el cálculo. Si un documento llega tarde, simplemente marca la celda correspondiente como 'sucia' para el siguiente ciclo de recalculo. Esto elimina la necesidad de una tabla de deduplicación compleja y pesada en memoria.
Optimización con tablas estrechas y diarios
Para hacer esto eficiente en ClickHouse, el equipo utilizó una 'tabla estrecha' que contenía solo las columnas necesarias para las medidas, ordenada por caja registradora y número de documento. Este diseño asegura que todos los documentos de una sola celda se sitúen uno al lado del otro, permitiendo que el sistema realice un escaneo de rango corto en lugar de un escaneo de tabla completa. En las pruebas, esto redujo el número de filas leídas entre 30 y 37 veces en comparación con la tabla ancha.
Un diario de 'marcas de suciedad' rastrea qué celdas necesitan recalcularse. Cuando se inserta un documento, se escribe una marca en un `ReplacingMergeTree`. Un proceso en segundo plano compara la hora de la última marca con la hora del último recalculo exitoso. Si una marca es más reciente que el último recalculo, la celda se añade al siguiente lote de procesamiento. Esto permite que el sistema se recupere automáticamente de las interrupciones simplemente retomando donde se quedó.