OpenAI ha desarrollado un flujo de trabajo de investigación de vulnerabilidades autónomo diseñado para identificar y remediar sistemáticamente fallos de seguridad en el kernel de Linux. El proyecto representa un cambio desde las investigaciones de seguridad manuales tradicionales —que a menudo requieren un esfuerzo humano sostenido para cada hallazgo individual— hacia un proceso automatizado y escalable. Al utilizar modelos de IA de vanguardia, el flujo de trabajo puede navegar por la vasta complejidad del kernel de Linux, una base de código que supera los 40 millones de líneas y que sustenta desde dispositivos Android hasta infraestructuras en la nube.
El flujo de trabajo opera a través de cinco etapas distintas: descubrimiento, validación dinámica, evaluación de explotabilidad, generación de parches y revisión humana. En la fase de descubrimiento, agentes 'Scout' identifican objetivos de auditoría de alto valor basados en la accesibilidad por parte de usuarios con bajos privilegios, mientras que agentes 'Analyst' escanean estos objetivos en busca de fallos potenciales. Los hallazgos validados se prueban luego en máquinas virtuales aisladas para producir pruebas de concepto que provoquen fallos. El sistema evalúa entonces si estos fallos podrían derivar en una escalada de privilegios locales (LPE) o fugas de información, generando finalmente parches candidatos. En una sola ejecución a mediados de octubre de 2026, este proceso identificó 2,308 hallazgos candidatos, reprodujo con éxito 1,724 vulnerabilidades y generó 948 exploits de LPE funcionales.
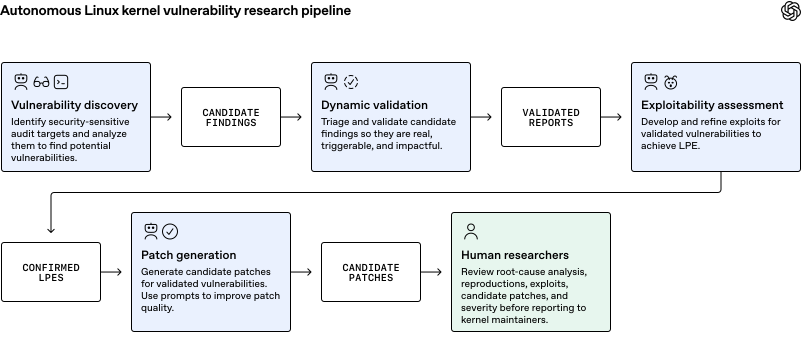
El flujo de trabajo opera a través de cinco etapas distintas: descubrimiento, validación dinámica, evaluación de explotabilidad, generación de parches y revisión humana.
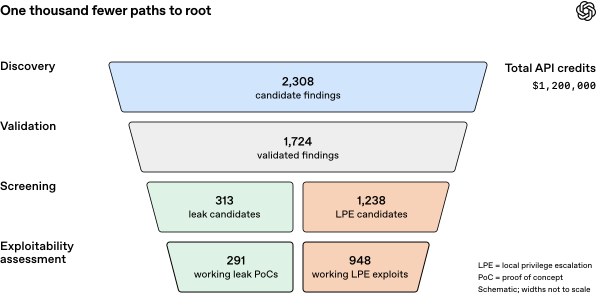
En una sola ejecución a mediados de octubre de 2026, este proceso identificó 2,308 hallazgos candidatos, reprodujo con éxito 1,724 vulnerabilidades y generó 948 exploits de LPE funcionales.
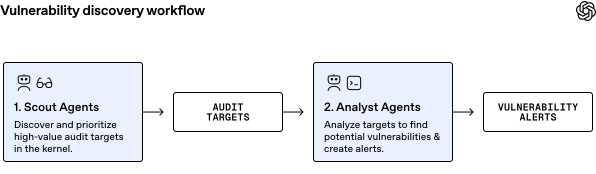
En la fase de descubrimiento, los agentes 'Scout' identifican objetivos de auditoría de alto valor basados en la accesibilidad por parte de usuarios con bajos privilegios, mientras que los agentes 'Analyst' escanean estos objetivos en busca de fallos potenciales.
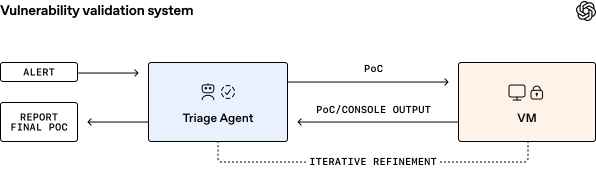
Los hallazgos validados se prueban luego en máquinas virtuales aisladas para producir pruebas de concepto que provoquen fallos.
Las implicaciones económicas de esta automatización son significativas. La ejecución del flujo de trabajo costó aproximadamente 1.2 millones de dólares en créditos de API, lo que resultó en un costo promedio de aproximadamente 1,279 dólares por cada exploit de LPE. OpenAI señala que esto es una fracción del costo de los programas de recompensas por errores tradicionales; por ejemplo, las recompensas históricas por exploits de LPE en el kernel de Linux han oscilado entre 20,000 y 70,000 dólares, lo que sugiere una valoración hipotética de entre 18.9 millones y 66.3 millones de dólares para los exploits descubiertos. Sin embargo, OpenAI enfatiza que la revisión por expertos humanos sigue siendo un paso final crítico para asegurar que los parches sean funcionalmente correctos y estén alineados con los estilos de codificación existentes antes de ser reportados a los mantenedores. Si bien el flujo de trabajo puede descubrir nuevas técnicas de explotación a escala, los investigadores sugieren que el software complejo aún puede requerir múltiples rondas iterativas de escaneo para agotar los errores latentes. A corto plazo, OpenAI sugiere que para actores con recursos suficientes, tener acceso de bajos privilegios a un sistema sin parchear puede volverse funcionalmente equivalente a tener acceso de root, resaltando la necesidad de software de alta garantía y estrategias de defensa en profundidad como el sandboxing.