Los agentes de modelos de lenguaje grandes (LLM) a menudo tienen dificultades con análisis fiables porque carecen de una comprensión estructurada del panorama de datos de una organización. Si bien los agentes pueden recuperar documentos o consultar bases de datos, frecuentemente carecen del contexto para saber dónde residen datos específicos, qué significan sus definiciones o cómo se relacionan con otras entidades. Auto Ontology de NVIDIA aborda esto proporcionando una capa semántica que se sitúa entre los datos brutos y el agente de IA. Esta capa actúa como un grafo de conocimiento que concilia definiciones inconsistentes en diferentes sistemas, asegurando que el razonamiento de un agente esté fundamentado en una lógica de negocio certificada en lugar de solo en puntos de datos brutos y potencialmente ambiguos.
El marco funciona como una pila de múltiples componentes utilizando un backend FastAPI, un frontend Next.js y una base de datos Postgres equipada con pgvector para el almacenamiento de vectores. Permite a los desarrolladores descubrir y generar ontologías empresariales a partir de metadatos existentes, proporcionando una forma de 'fundamentar' a los agentes en relaciones confiables. Una característica técnica clave es su capacidad para traducir preguntas en lenguaje natural en consultas SQL que se validan contra definiciones y linajes certificados. Este proceso asegura que las respuestas resultantes incluyan procedencia, haciendo que la producción de la IA sea más explicable. El sistema también admite Model Triplets —configuraciones específicas para el razonamiento, la extracción de entidades y los embeddings— que pueden alojarse a través de endpoints NVIDIA NIM o instancias autoalojadas.
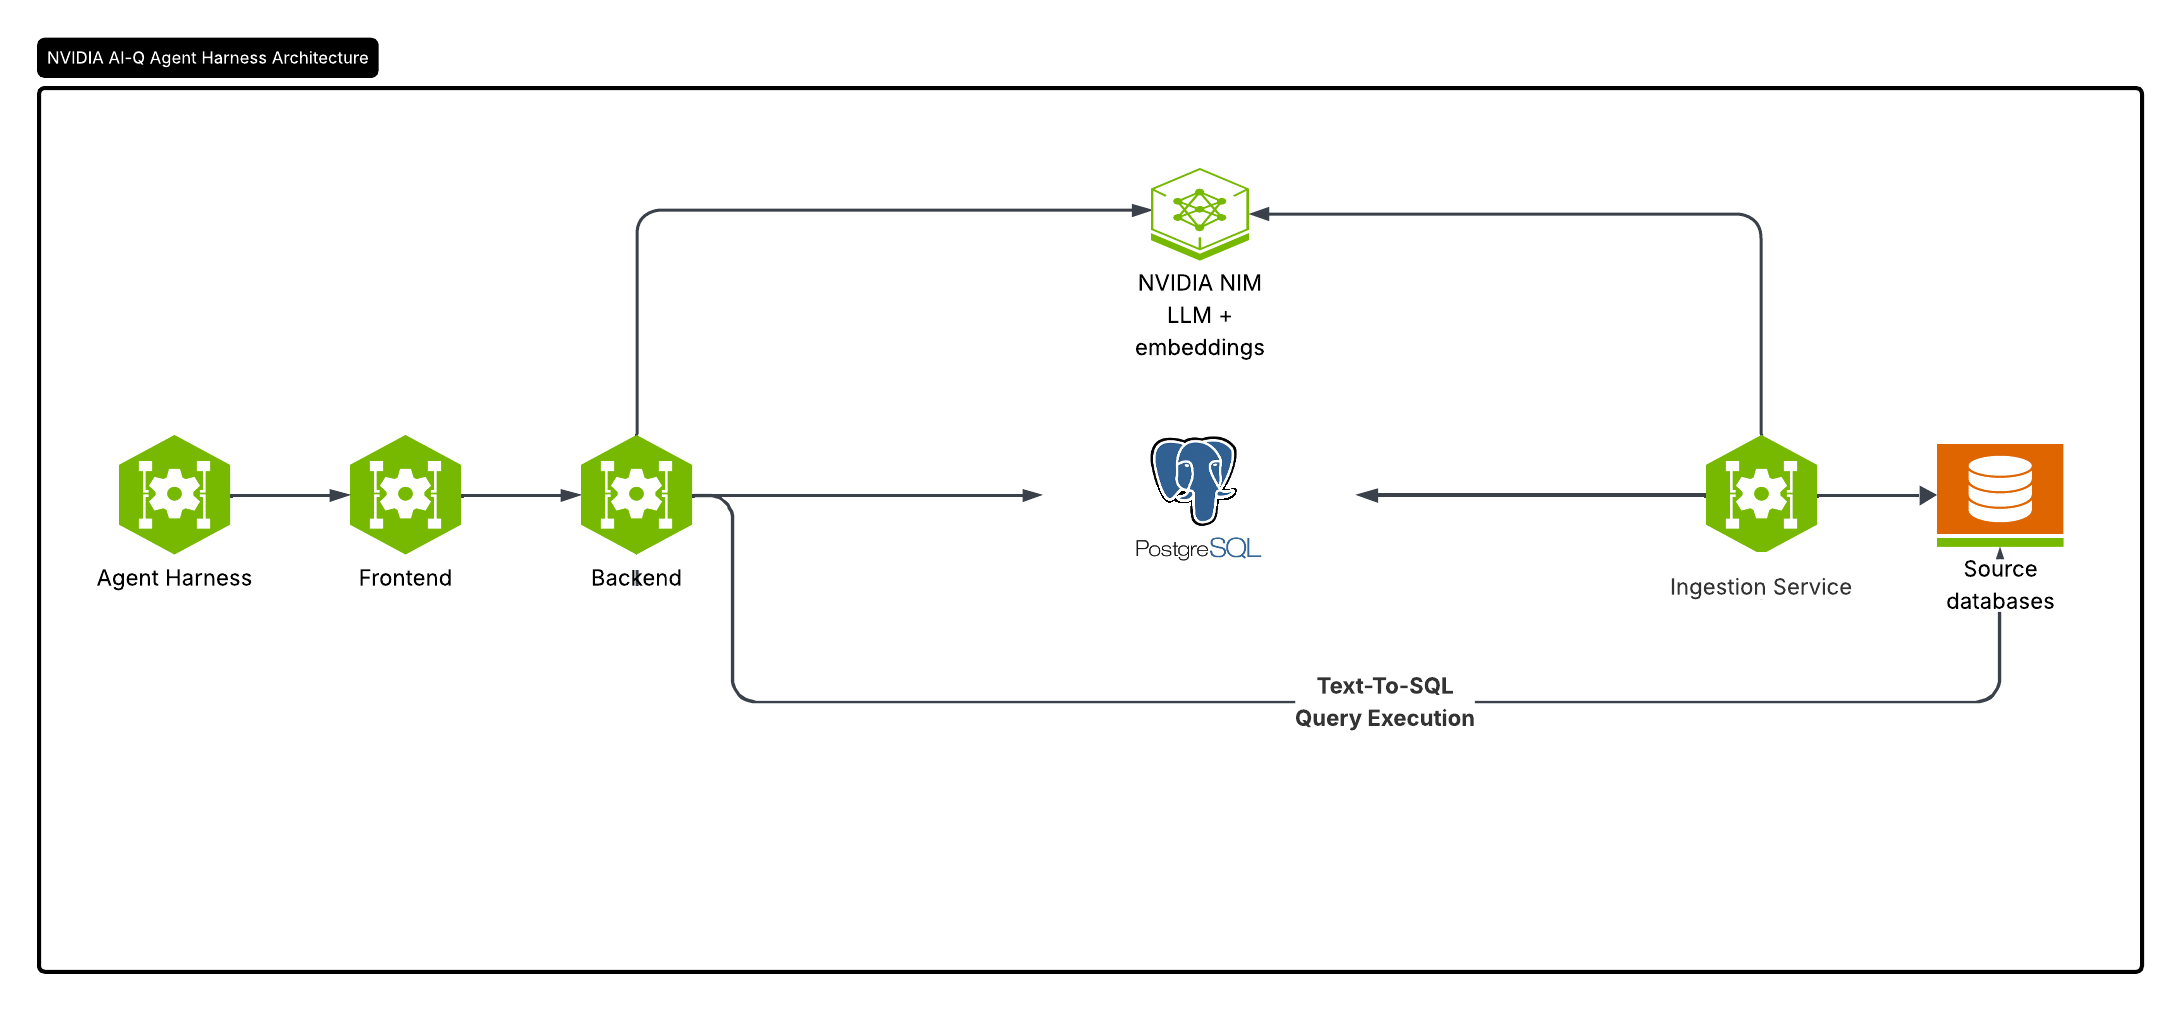
El marco funciona como una pila de múltiples componentes utilizando un backend FastAPI, un frontend Next.js y una base de datos Postgres equipada con pgvector para el almacenamiento de vectores.
A pesar de su enfoque en la fiabilidad, el marco introduce requisitos operativos y limitaciones específicas. Los usuarios deben configurar manualmente las cadenas de conexión para bases de datos de origen como Snowflake, Databricks o DuckDB, y gestionar los Model Triplets a través de variables de entorno. Si bien el sistema proporciona una interfaz web para el chat y el catálogo de datos, actualmente no acepta contribuciones externas, lo que significa que su crecimiento depende del desarrollo interno de NVIDIA. Además, aunque el marco pretende resolver la naturaleza 'poco fiable' de la analítica de agentes, la lógica específica utilizada para conciliar automáticamente definiciones en conflicto entre sistemas dispares sigue siendo un detalle de implementación interna no detallado completamente en el repositorio público. El sistema está diseñado para ser extensible a través del Model Context Protocol (MCP), lo que permite integrarlo con plataformas de agentes populares como Claude Desktop o Cursor.
Evidencia: 1. La fuente principal (GitHub - NVIDIA/auto-ontology) establece que el marco permite la 'generación de consultas deterministas' y una 'mejor recuperación de contexto' mediante la construcción de una capa de razonamiento a partir de metadatos empresariales. 2. La fuente principal también detalla la pila técnica, incluyendo el uso de FastAPI para el backend, Next.js para el frontend y la integración con NVIDIA NIM para la inferencia. 3. La fuente principal especifica que el marco permite 'validar' las consultas generadas contra definiciones certificadas y devolver la procedencia con cada respuesta.
Editorial: - evidencia_suficiente: verdadero - fuente_limitada: verdadero - solo_envío: falso - resumen_de_discusión: falso - investigación_de_ángulo_editorial: - Pregunta 1: ¿Cómo maneja Auto Ontology específicamente las definiciones de metadatos en conflicto entre dos bases de datos de origen diferentes? - Respuesta 1: La fuente indica que 'concilia definiciones entre sistemas' para proporcionar un 'significado de negocio confiable', pero la lógica algorítmica específica para esta conciliación no se detalla en la documentación proporcionada. - Pregunta 2: ¿Cuáles son las métricas de rendimiento específicas para la generación de texto a SQL de Auto Ontology en comparación con RAG estándar? - Respuesta 2: La fuente menciona una prueba de referencia de texto a SQL (BIRD) y proporciona un enlace a un repositorio de evaluación, pero no enumera puntuaciones comparativas específicas dentro de la documentación principal.