A medida que los agentes de programación aceleran la velocidad del desarrollo de software, el principal cuello de botella ha pasado de escribir código a verificar que el nuevo código funcione correctamente en un entorno en vivo. Momentic, una startup respaldada por Y Combinator, aborda esto proporcionando una plataforma de calidad agéntica donde los usuarios pueden describir flujos de usuario en inglés sencillo. La plataforma luego ejecuta estas pruebas contra la aplicación para verificar rutas críticas e identificar regresiones antes de que lleguen a producción.
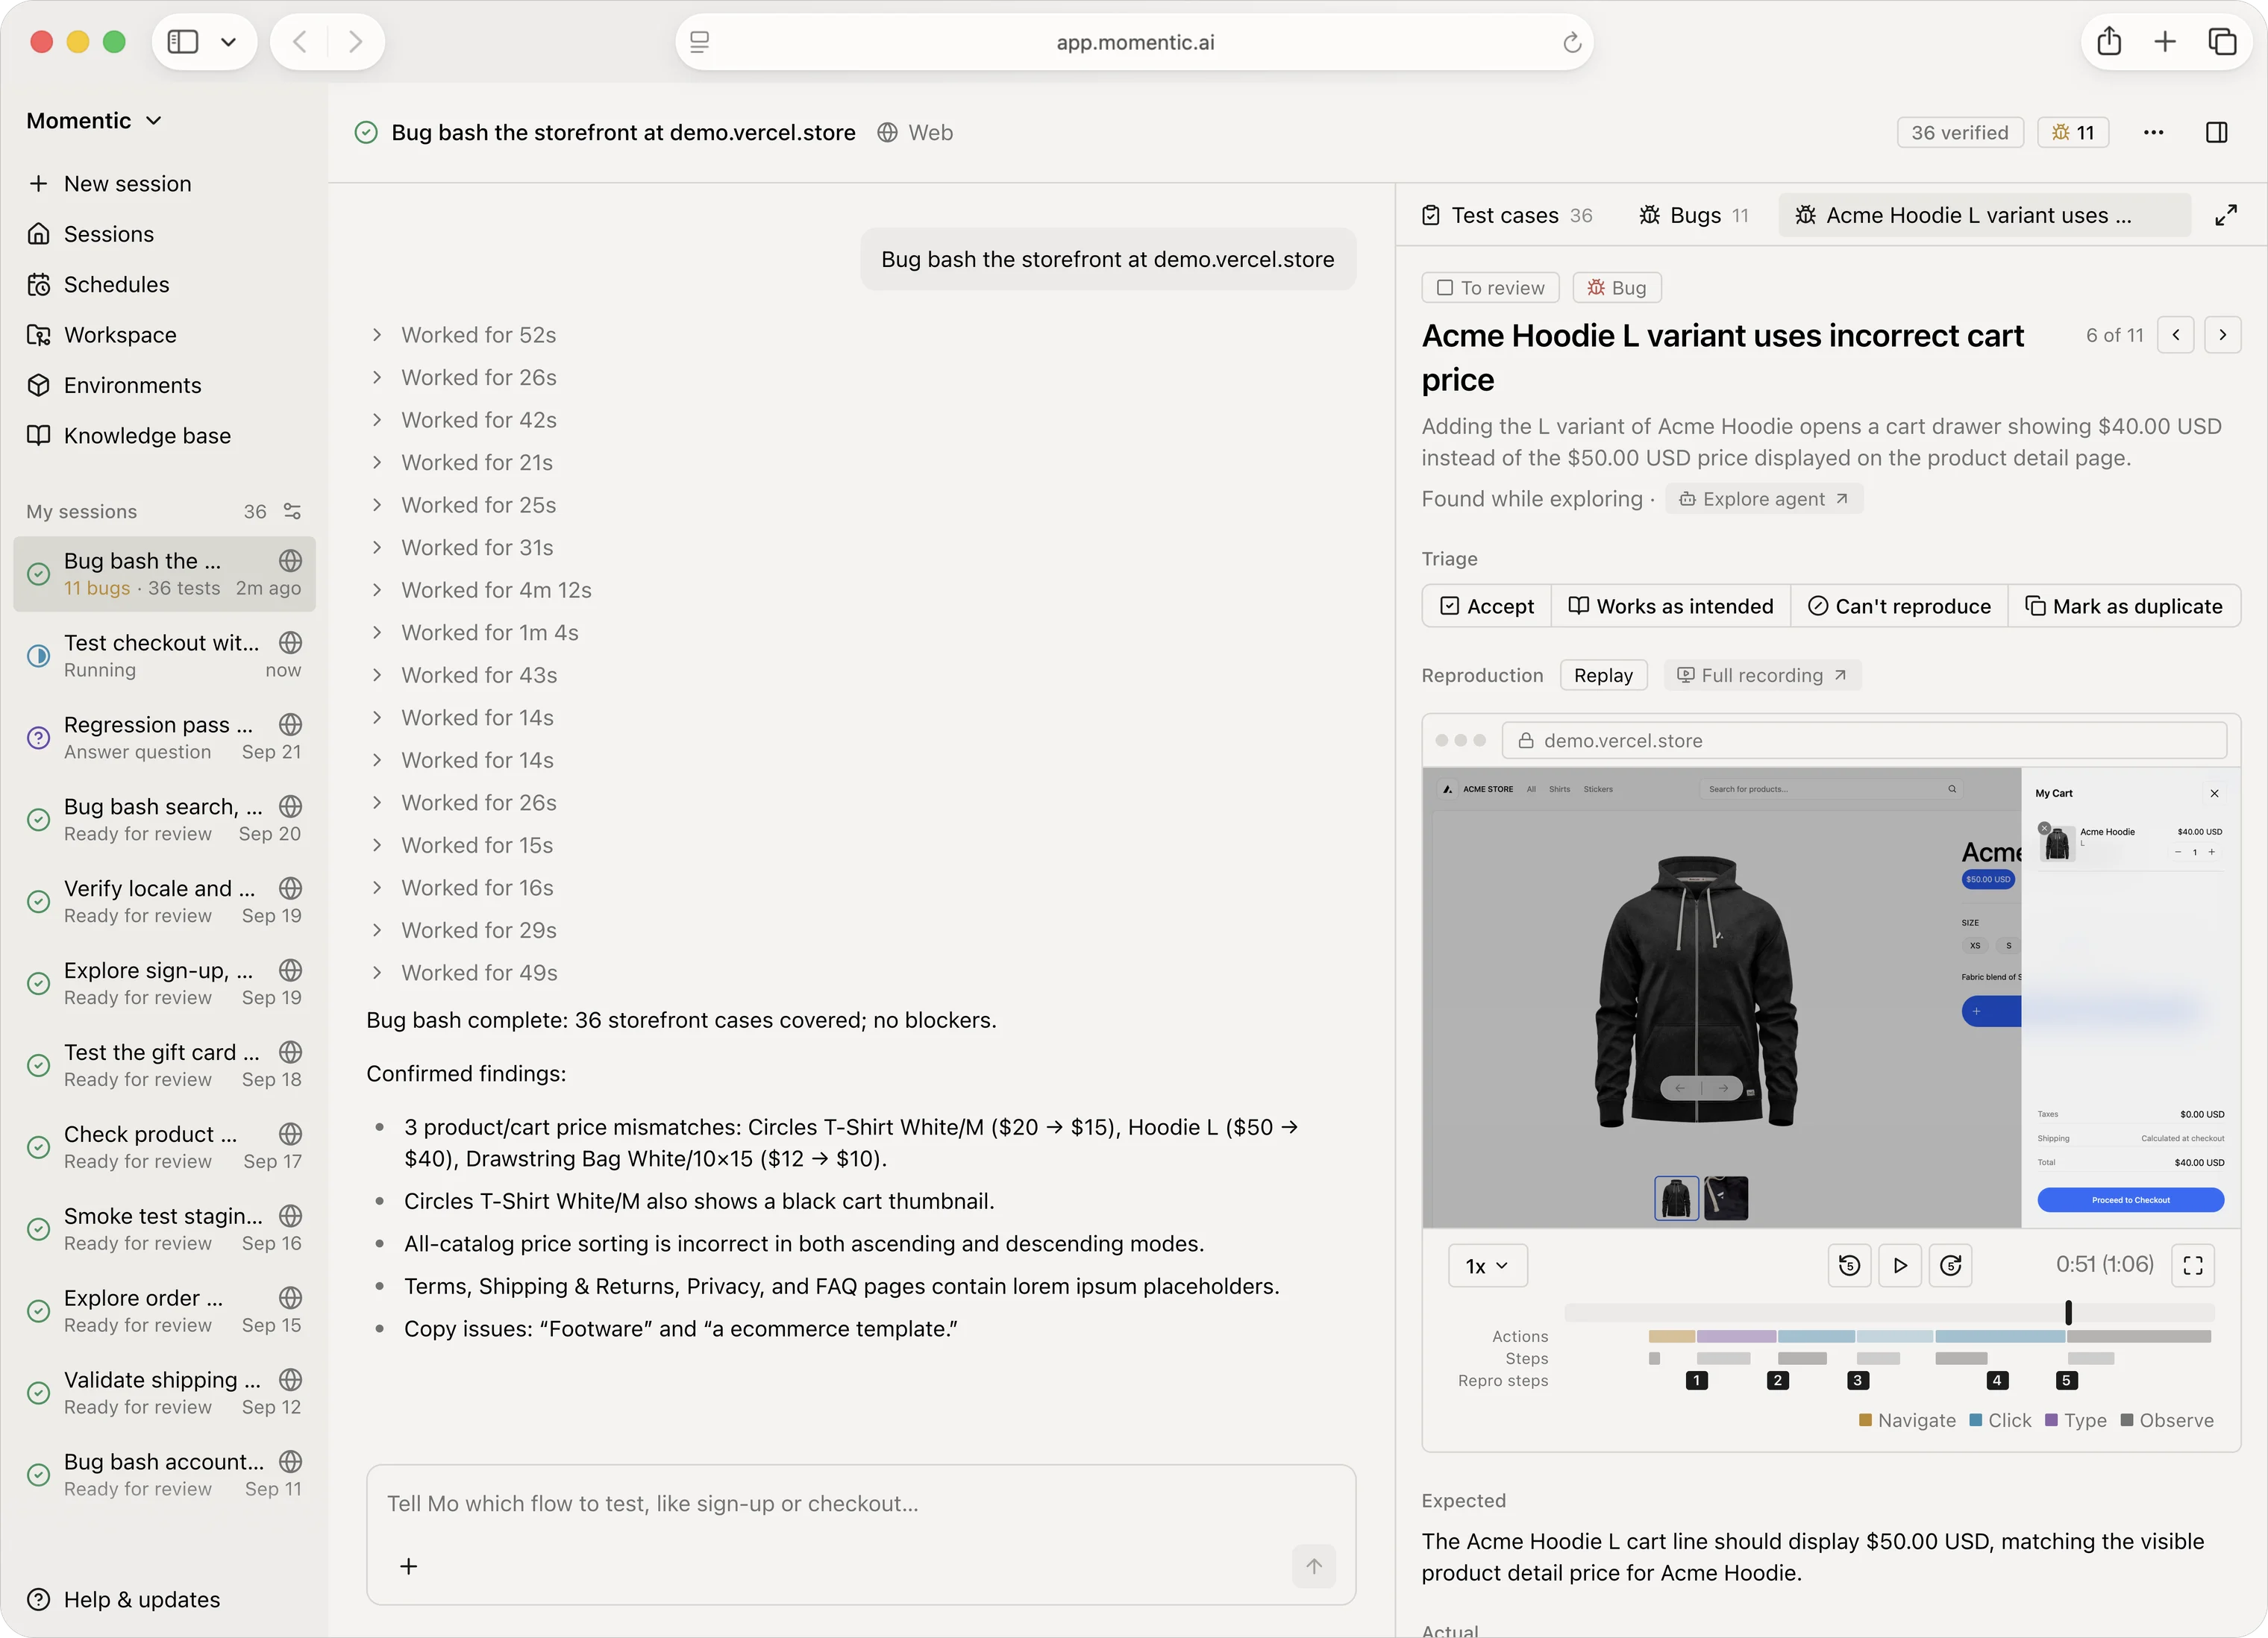
Esta imagen ilustra la plataforma de calidad agéntica donde los usuarios pueden describir flujos y la plataforma identifica regresiones.
Para evaluar su rendimiento, Momentic estableció una prueba de rendimiento propia llamada 'QA Bench'. Esta prueba enfrentó a Mo contra otros agentes bien conocidos —incluyendo Codex, Claude Code y Devin— contra 1,396 errores etiquetados por humanos en cuatro aplicaciones de código abierto populares: Gitea, Metabase, Twenty y Saleor. Durante la prueba, los agentes tuvieron restringido el acceso al código fuente de la aplicación o a Internet, obligándolos a depender de la interacción con la interfaz de usuario en vivo. En una pasada de 60 minutos a través de la suite, Mo coincidió con 269.3 errores de referencia, superando significativamente la siguiente mejor configuración, Codex (86.3), y la mejor configuración de Claude Code (59.0).
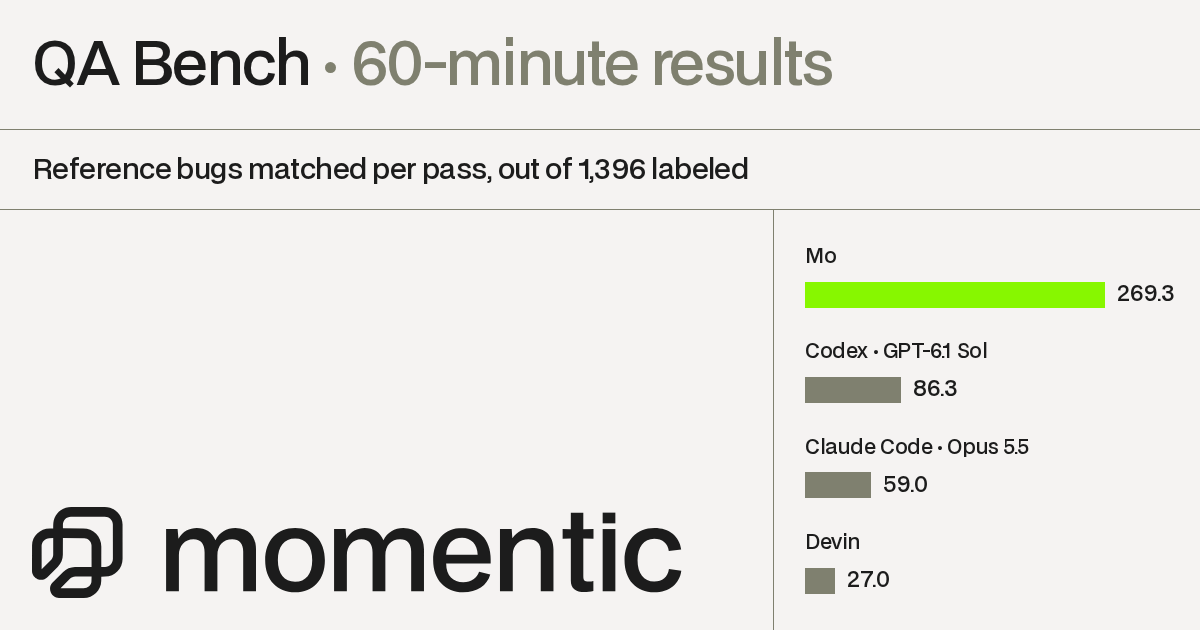
El gráfico proporciona una comparación visual del rendimiento de recuperación de errores entre diferentes agentes de programación durante la prueba de 60 minutos.
La ventaja de rendimiento de Mo proviene de su arquitectura especializada. A diferencia de los agentes de programación de propósito general, Mo utiliza una 'Base de conocimientos' donde los desarrolladores pueden definir terminología específica del producto, reglas de negocio y comportamientos esperados. Este contexto permite al agente tomar decisiones más informadas durante las ejecuciones de las pruebas. Además, la plataforma cuenta con 'Auto-heal', que identifica cuándo un cambio en la interfaz de usuario rompe una prueba y propone una reparación al archivo de prueba. Si bien Mo logró la mayor recuperación en la prueba (19.3%), conlleva un costo más alto por error coincidente (2.67 dólares) que la configuración de Codex más precisa (0.80 dólares), aunque sigue siendo más barato que la configuración Claude Code Opus (4.09 dólares).
Debido a que QA Bench es una evaluación de primera parte realizada por Momentic, los resultados están sujetos a las limitaciones del propio sistema de calificación de la plataforma. La prueba utiliza un juez LLM para comparar los informes del agente con el conjunto de referencia, lo que puede introducir sesgos en comparación con las pruebas independientes de terceros. Además, aunque Mo demuestra una alta recuperación, una sola pasada todavía deja la mayoría de los errores etiquetados sin encontrar, lo que sugiere que el agente es actualmente más adecuado para identificar regresiones de alta prioridad en lugar de una búsqueda exhaustiva de errores.