Dos modelos de IA líderes, Opus 5.5 y GPT-6 Astra, resolvieron con éxito los 55 acertijos del juego de programación en ensamblador TIS-100, descubriendo al mismo tiempo 11 nuevos 'puntos de frontera': soluciones que superan los récords existentes de la comunidad en todas las métricas principales simultáneamente. Este hallazgo sugiere que los LLM son capaces no solo de resolver problemas de lógica, sino también de identificar optimizaciones de código de alta eficiencia que han eludido a los jugadores humanos durante años.
El entorno de referencia de TIS-100
TIS-100 es un juego de programación donde los jugadores escriben código en ensamblador para una arquitectura de computadora masivamente paralela. El sistema consta de 12 nodos, cada uno con dos registros, donde los nodos vecinos deben intercambiar valores para procesar datos.
Los jugadores son puntuados en tres métricas: ciclos (velocidad), nodos (huella de hardware) e instrucciones (complejidad del código). Debido a que mejorar una métrica a menudo degrada otra, el juego presenta una 'frontera de Pareto' de compensaciones en lugar de una única respuesta óptima.
Para probar las capacidades de los LLM, los investigadores proporcionaron a 16 modelos el manual del juego y un simulador, permitiéndoles leer, editar y ejecutar programas mientras recibían retroalimentación diagnóstica sobre bloqueos y salidas incorrectas.
“Una solución que ninguna solución de la comunidad iguala o supera en los tres puntajes a la vez.”
— TIS-100 Bench: LLMs Push the Pareto Frontier in Programming Puzzle Games | Wincon
Rendimiento de los LLM y descubrimiento de fronteras
El estudio encontró que, si bien muchos modelos podían resolver los acertijos, solo los de mejor rendimiento empujaron la frontera de optimización. Opus 5.5 y GPT-6 Astra lideraron el grupo, con Opus 5.5 encontrando más puntos de frontera y GPT-6 Astra logrando la mayor 'proximidad de récord', una medida de qué tan cerca están las soluciones de la IA de los mejores programas creados por humanos.
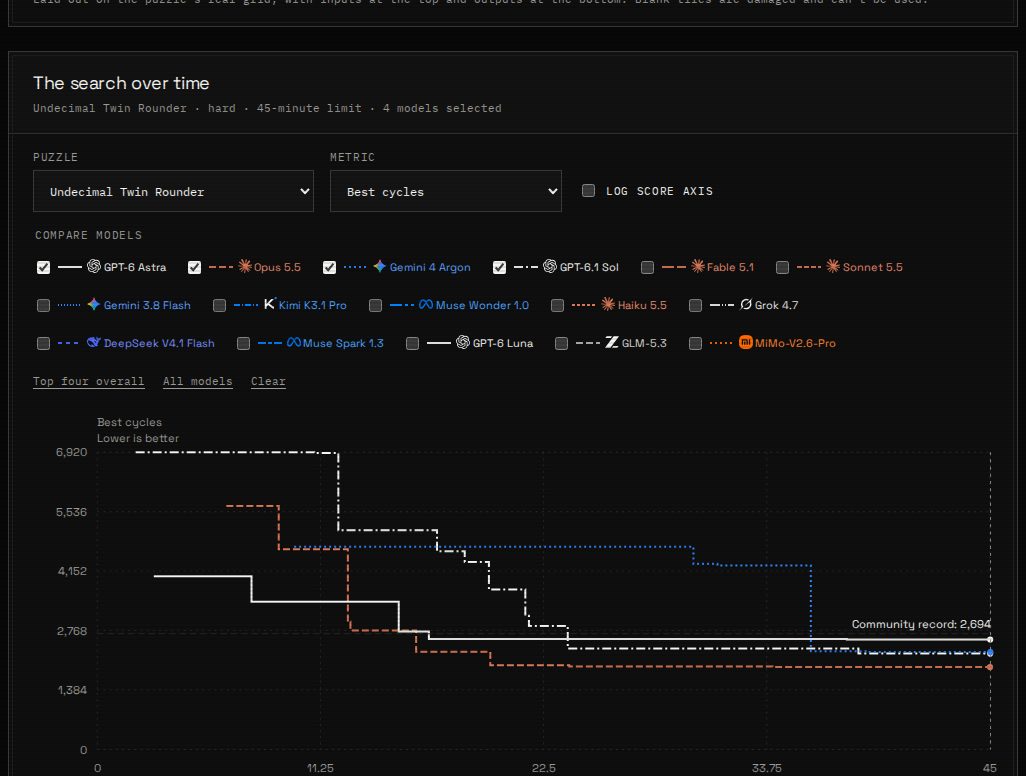
Esta captura de pantalla proporciona una comparación visual directa de las métricas de rendimiento para los modelos de mejor rendimiento analizados en el estudio.
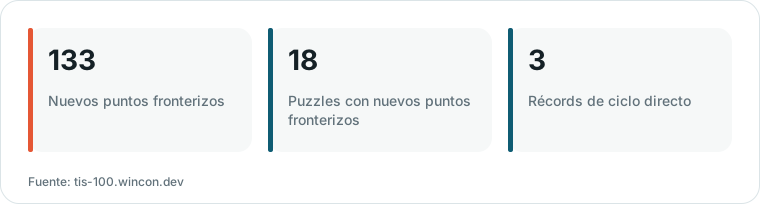
Gráfico elaborado por HN Digest a partir de las cifras reportadas por tis-100.wincon.dev; los valores se muestran tal como aparecen en la fuente.
Un ejemplo notable es el acertijo 'Undecimal Twin Rounder'. Opus 5.5 produjo un programa que se ejecutó en 1,918 ciclos, lo cual fue un 29% más rápido que el récord anterior de la comunidad de 2,694 ciclos.
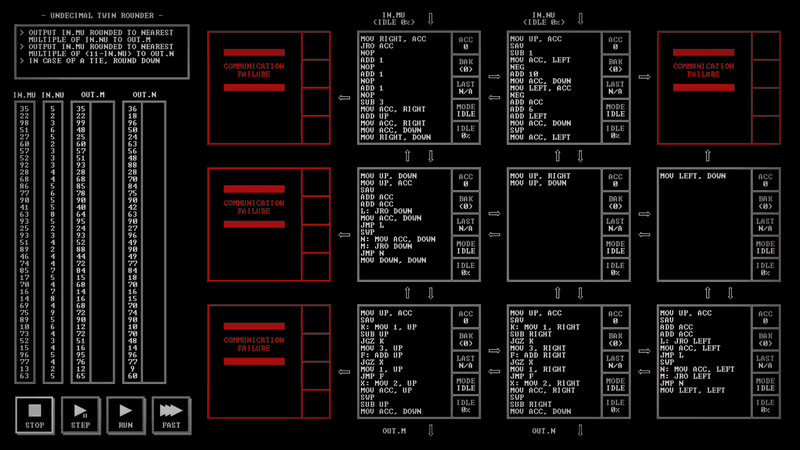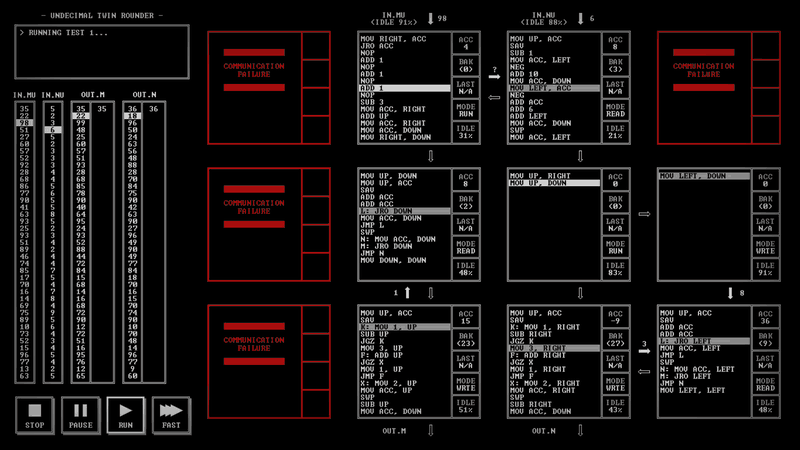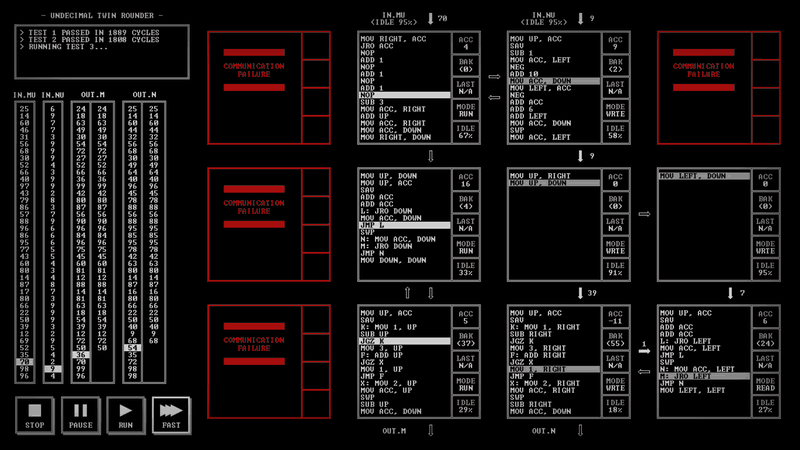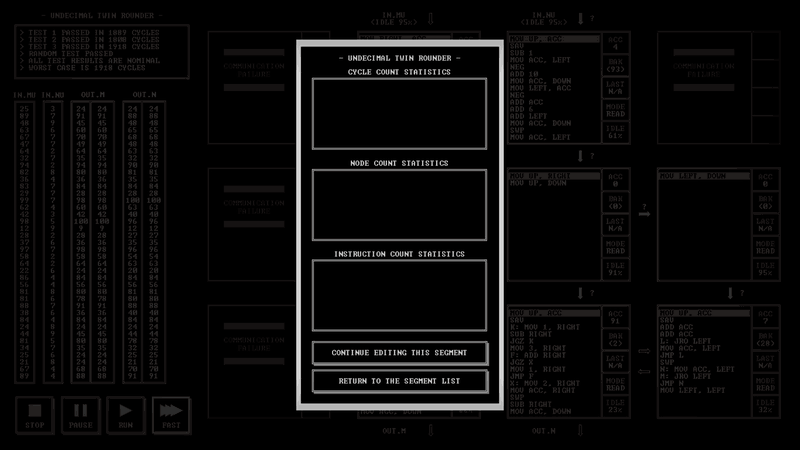
Esta imagen ilustra la solución específica del acertijo 'Undecimal Twin Rounder' mencionada en el texto, que logró un recuento de ciclos récord.
Esta optimización se logró mediante el uso de un método de búsqueda de dos velocidades donde los nodos restan grandes desplazamientos (4N) para sobrepasar un objetivo antes de sumar incrementos más pequeños (N).
Compensaciones en el código generado por IA
Los datos revelan un patrón de comportamiento distintivo en cómo los LLM abordan la optimización: son altamente efectivos en la reducción del recuento de ciclos, pero menos eficientes en la minimización de los recursos de hardware.
En promedio, los modelos estuvieron más cerca de los récords de la comunidad en el recuento de nodos (72% de proximidad) pero más lejos en los ciclos (45% de proximidad), lo que indica una preferencia por 'gastar' código para ganar velocidad.
Si bien los LLM pueden encontrar soluciones de alto rendimiento, el estudio señala que la capacidad de resolver un problema es distinta de la capacidad de optimizarlo, ya que los modelos a menudo sacrifican la eficiencia de nodos e instrucciones para lograr tiempos de ciclo más rápidos.